
DeepSeek V4.1、Qwen3.8、GLM-5.3、MiMo-V2.6 Flash:便宜模型不等于便宜任务
DeepSeek V4.1、Qwen3.8、GLM-5.3、MiMo-V2.6 Flash 怎么选?四家人民币价目于 10 月 2 日复核:短请求看时段,agent 看缓存,长文档看输入档;对照第三方历史任务成本与厂商评测,给出降档的可验证边界。
一条分类请求只要答「是」或「否」;另一条请求让 agent 带着几万 token 的历史反复调用工具。两者都送去标着「Flash」的模型,省钱方式却完全不同。DeepSeek V4.1、Qwen3.8、GLM-5.3 和 MiMo-V2.6 四家 Flash 不能按名字选:短请求看时段,重复上下文看缓存命中价,长文档看输入档位;能否降档,还要看错误能不能被便宜地发现。
假设同一个请求在同一时段使用相同 token 数,按人民币列表价从自家旗舰换成 Flash,MiMo 的短任务可省 67%、DeepSeek 省 75%、GLM 省 90%、Qwen 省 93%。这是单价带来的理论节省,不是任务总成本承诺:模型可能生成不同数量的思考 token、重试次数也可能不同。对上面的短请求,四家 Flash 在 DeepSeek 空闲时段的千次费用是 2.68–3.60 元;但它进入高峰时段后会涨到 7.20 元。对于假设 90% 输入命中的 agent 一轮,MiMo 算例最低;Qwen3.8 的命中单价公开页未列,只能算未命中计价的上界。30 万 token 全部未命中的长文档算例,则由 Qwen3.8-Flash 与 GLM-5.3-Flash 以每千次 248 元并列最低。
技术上,风险不是简单的「小模型会不会写代码」。MiMo 同一家模型的发布表里,长程终端和部分安全任务的 Flash 与 Pro 差距明显;DeepSeek 的基础模型表则在知识问答、长文档指标上出现落差,而安全指标在另一张厂商表里方向相反。低风险翻译、JSON 抽取、边界清楚的代码修改,我倾向于先让 Flash 试跑,但要核算人工抽检、语义漏检及失败重做的成本;schema 与测试都只能覆盖自己实际检查的范围。这是有条件的编辑判断,不是四家都做过的横向实测。
本文价目取官方国内人民币 / 百万 tokens:原稿于 2026 年 9 月 27 日逐项核过,四家价目及百炼缓存规则于 2026 年 10 月 2 日再次实读,数值未变;不拿海外美元价换汇。Artificial Analysis(下称 AA)的分数、速度和每任务花费仍是 9 月 27 日 14:39 UTC 的历史快照,不代表今天实时榜单。厂商自报与 AA 读数各标归属;我们没有跨厂商实测。
五个月四家到齐:从 V4-Flash 到 MiMo-V2.6 Flash
4 月 24 日 DeepSeek 发布 V4 系列,其中有 V4-Flash;8 月 26 日 Qwen3.8-Flash 和 GLM-5.3-Flash
同一天发布;9 月 10 日 DeepSeek-V4.1-Flash 接替 V4-Flash,模型名改为 deepseek-flash
(DeepSeek 更新日志);9 月 22 日小米发布
MiMo-V2.6 的 Pro、Flash、Pro-Ultraspeed 三款
(Xiaomi MiMo 更新日志 · 模型发布)。
掘金上 RockByte 那篇文章把这条线读成一次叙事转向:过去讲参数和榜单,现在讲速度、吞吐和每次任务 花多少钱(DeepSeek V4.1 Flash,等等,为什么现在大家都在卷 Flash?)。 它给的两条用法我都认同:「日常任务先用 Flash,做不对、改不动了,再换旗舰」,以及「让旗舰模型 负责规划,让 Flash 负责执行」。
放到一个每天几十万次调用的服务里,这两句话还缺三样东西:一段能识别「日常任务」的代码,一个能自动 判定「做不对」的信号,一个告诉你「换旗舰贵多少」的数。这篇依次补上:价目表、任务表、路由规则。
四家 Flash 的人民币价目,先看哪一格?
想把生产服务里的一批请求降档,最好先别从榜单分数入手。拿到现有调用日志,区分新输入、缓存命中输入和输出 token,再把账号所属区域与请求时间带进价目表。这三格分别决定长文档、反复调用的 agent 和高峰期短请求的账单;模型名字并不能替你拆开它们。
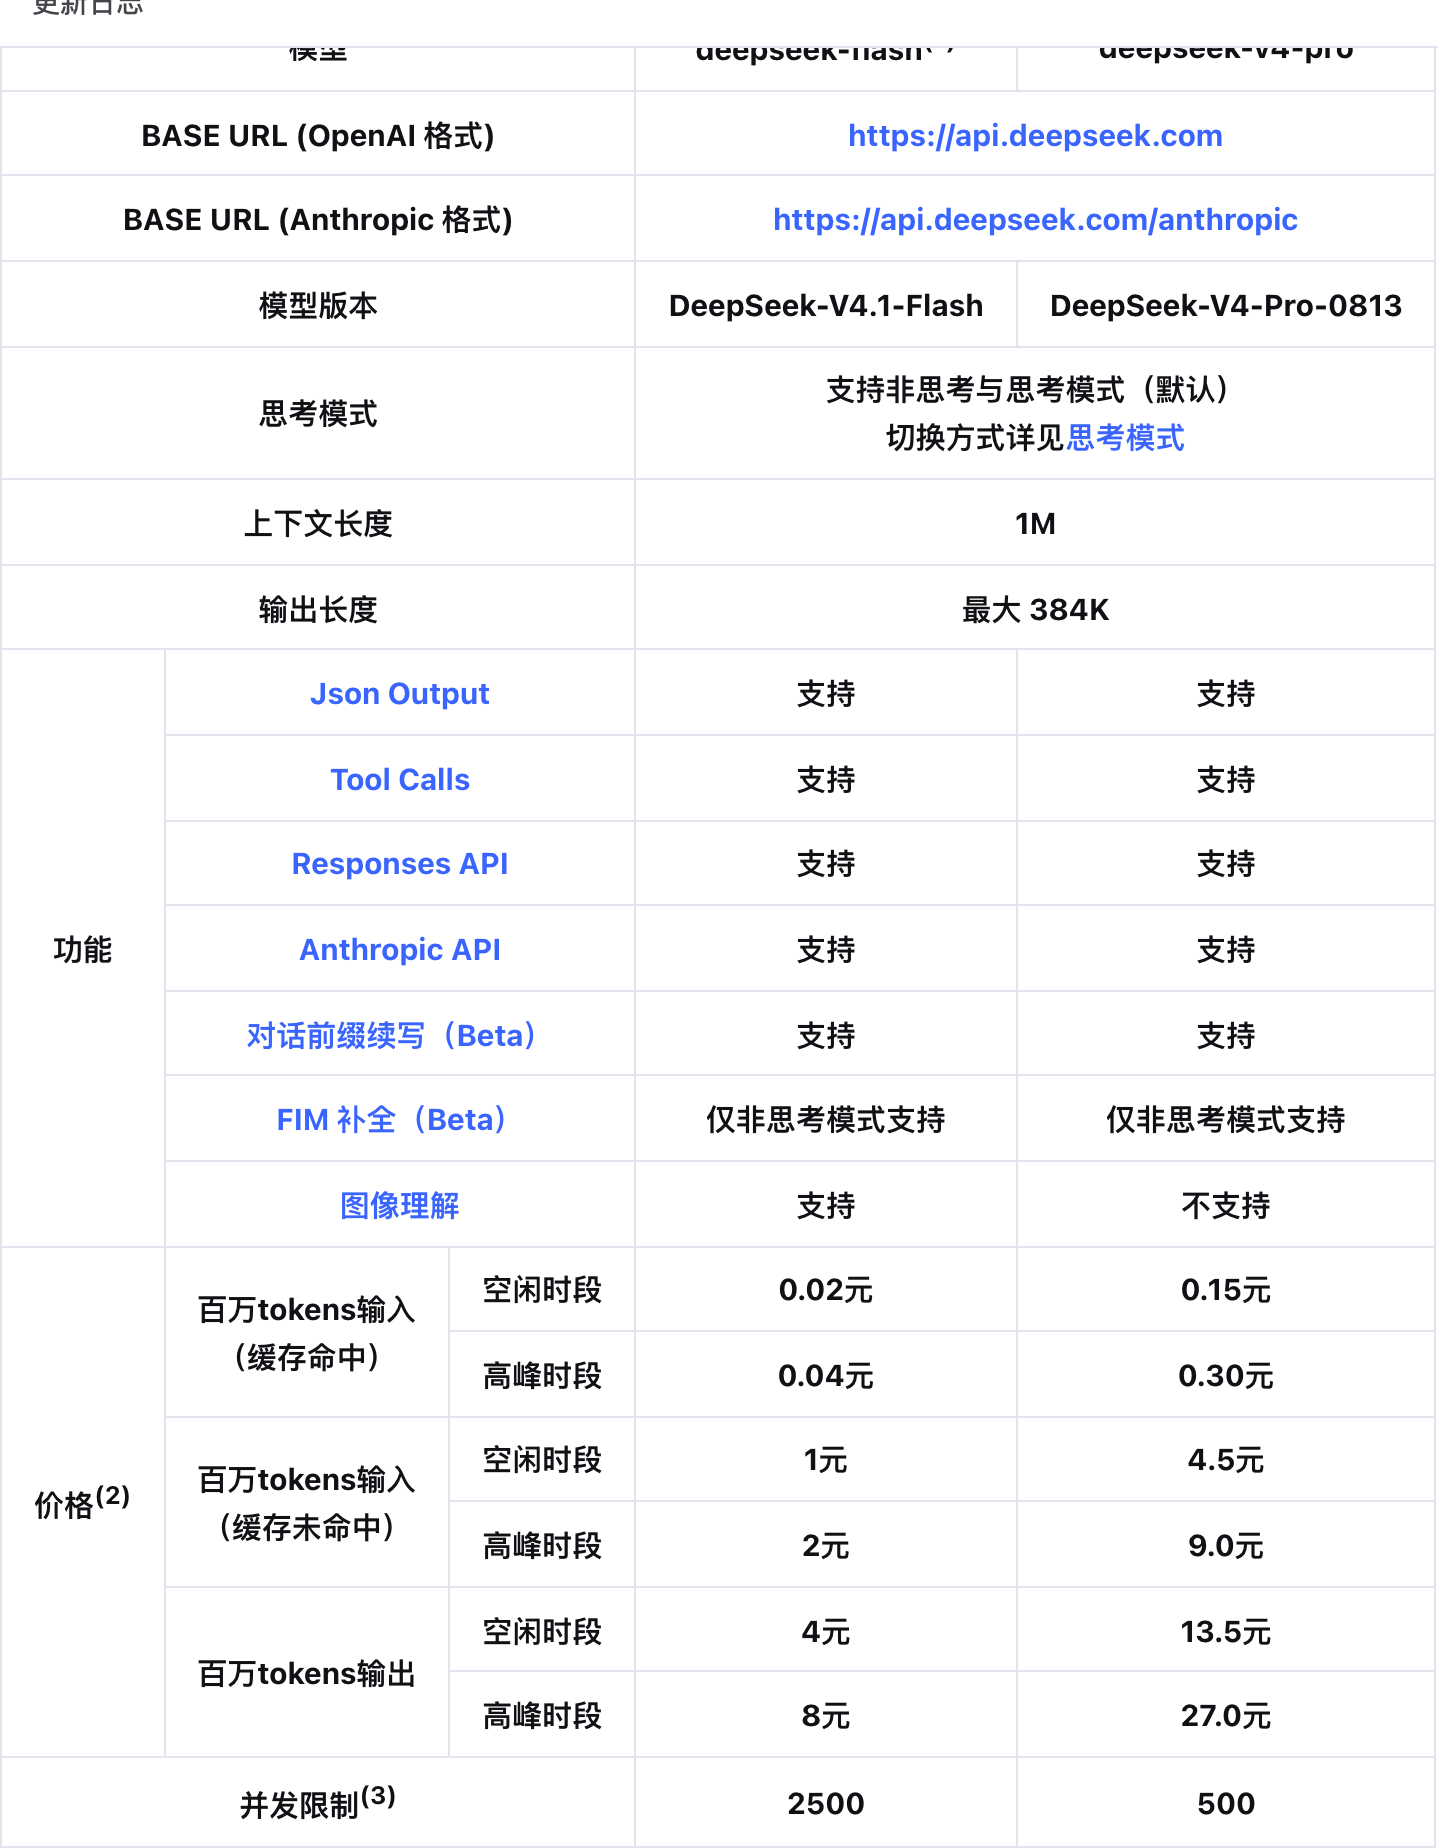
下表为人民币元 / 百万 tokens,原稿 9 月 27 日逐格记录,10 月 2 日重新实读四家官方价目,表中价格仍一致。DeepSeek 斜线前为空闲时段、斜线后为高峰时段;其余三家按表中区域及实时调用公开原价,不含登录控制台才能看到的活动优惠。价目不是同一组质量评测,也不能直接把「低单价」读成「低任务成本」。
| 模型(API 名) | 缓存命中 | 缓存未命中 | 输出 | 上下文 / 最大输出 | 时段 · 阶梯 · 批量 |
|---|---|---|---|---|---|
DeepSeek V4.1 Flash(deepseek-flash) | 0.02 / 0.04 | 1 / 2 | 4 / 8 | 1M / 384K | 峰谷,高峰 2 倍;价目页未列批量档 |
DeepSeek V4 Pro(deepseek-v4-pro) | 0.15 / 0.30 | 4.5 / 9 | 13.5 / 27 | 1M / 384K | 同上 |
Qwen3.8-Flash(qwen3.8-flash) | 公开页未列 | 0.8 | 2.7 | 1M / 页面未列 | 单档;页面未标批量半价 |
Qwen3.8-Max(qwen3.8-max) | 公开页未列 | 12 | 36 | 1M / 页面未列 | 单档;批量半价 |
GLM-5.3-Flash(glm-5.3-flash) | 0.23 | 0.8 | 2.8 | 1M / 128K | 缓存存储限时免费 |
GLM-5.3(glm-5.3) | 2 | 8 | 28 | 1M / 128K | 同上 |
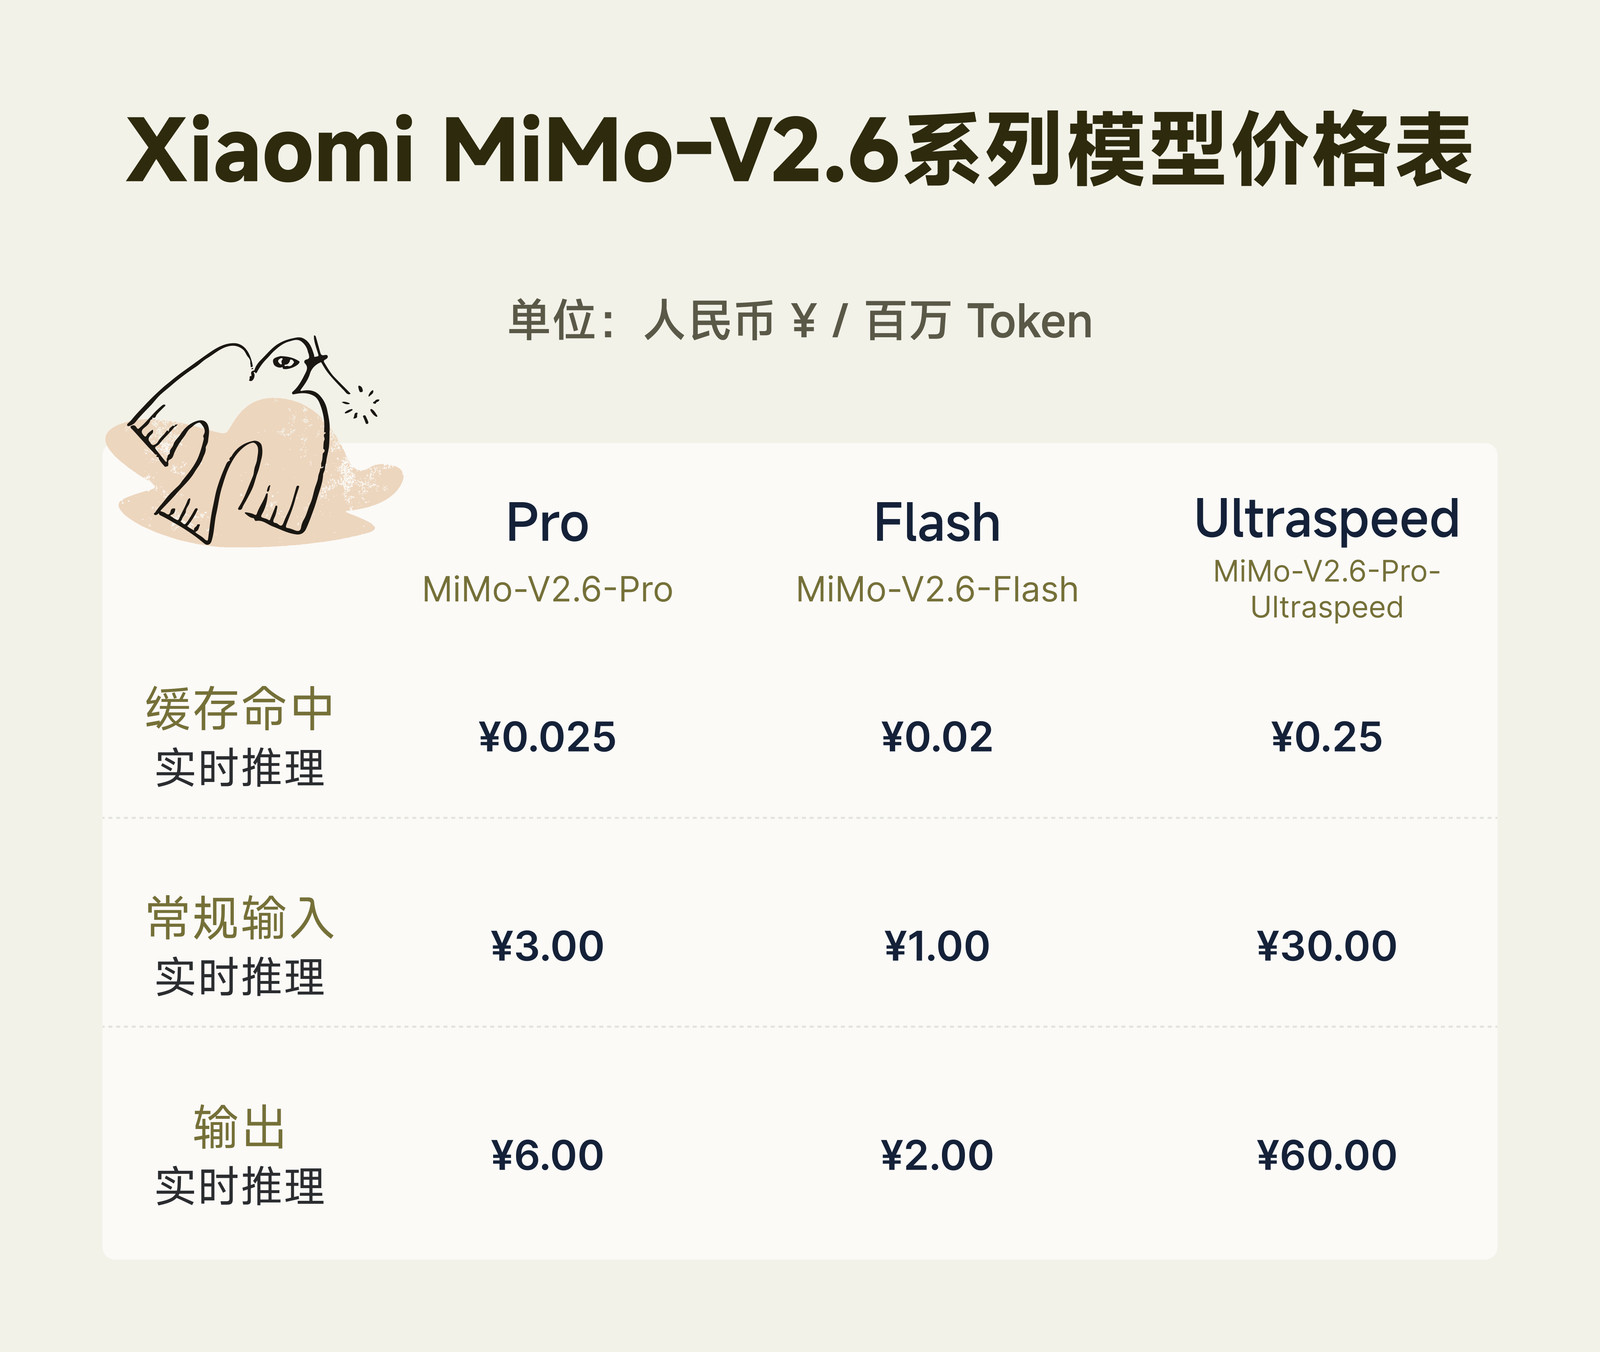
MiMo-V2.6 Flash(mimo-v2.6-flash) | 0.02 | 1.00 | 2.00 | 1M / 128K | 批量五折;缓存写入限时免费 |
MiMo-V2.6 Pro(mimo-v2.6-pro) | 0.025 | 3.00 | 6.00 | 1M / 128K | 同上 |
出处:DeepSeek 模型 & 价格、 阿里云百炼 模型调用价格(华北 2 北京)、 阿里云百炼 选择文本生成模型、 智谱 API 定价、 智谱 GLM-5.3 模型页、 智谱 GLM-5.3-Flash/FlashX 模型页、 Xiaomi MiMo API 定价、 Xiaomi MiMo 模型列表。
「缓存命中」这一列需要先解释。你的请求开头如果和之前某次请求一样(同一段系统提示、同一批工具定义、 同一份文档),厂商可以直接复用上次的计算结果,这部分输入按命中价计,通常只有未命中价的零头。 有两种做法:隐式缓存由厂商自动识别前缀,命中与否不保证;显式缓存由你标记要缓存的内容,命中更确定, 但创建时可能多收一点。命中率完全取决于你的流量长什么样,下面算例里的 90% 只是一个假设,要按各家 账单或 usage 字段实测。
表外还有几处要单独说。
Qwen3.8 系列的命中价只在控制台里。 百炼价目表在 qwen3.8-flash 那一行只写了「上下文缓存享有折扣」; 上下文缓存文档的通用规则是隐式命中按输入价 20%、显式命中按 10%,紧接着把 qwen3.8-max、qwen3.8-flash 列为例外,「具体价格请参见百炼控制台」。 百炼价目页首句还写着「本文仅展示模型调用原价,请前往百炼控制台查看活动优惠」,我们只核了公开原价。 另外 qwen3.8-flash 这一行没有标「Batch调用半价」,同表的 qwen3.8-max、qwen3.7-flash 都标了。
**GLM 的思考关不掉,DeepSeek 与 MiMo 的思考默认开着。**智谱模型页写 GLM-5.3-Flash「thinking.type
仅支持 enabled,不支持关闭思考」,GLM-5.3 同样「不再支持禁用思考」。DeepSeek 的思考模式默认打开、
强度默认 high,可以用 {"thinking": {"type": "disabled"}} 关掉
(DeepSeek 思考模式);MiMo 的 v2.6-flash
与 v2.6-pro 也默认开启、可以设为 disabled
(MiMo 深度思考)。
思考 token 计入输出,一个三十个字就能答完的分类请求,默认配置下也要先想一阵。
**有几项优惠写着「限时」,没写到哪天。**智谱「缓存存储」列的计价单位是元 / 百万 tokens / 小时,现在 标「限时免费」;MiMo 的缓存写入限时免费;GLM-5.3-Flash 模型页还有一句「限时折扣内为 GLM-5.3 的 1/20」, 而价目页上的 0.8 / 2.8 元没有标折扣。三处都没有到期日。如果优惠结束后恢复缓存存储或写入收费,且请求实际使用了这部分缓存,长上下文 agent 的账单才可能多出一项;到期日与未来价格目前均未知。
默认限流差别很大。 DeepSeek 按账号计并发,Flash 2500、Pro 500,超限返回 429,可以免费申请扩容 (DeepSeek 限速与隔离);MiMo 两款默认 RPM 100、TPM 1000 万;百炼对 qwen3.8-max、qwen3.8-flash 按月消费档位做「动态限流」 (阿里云百炼 限流);智谱的限流页本轮没有核到。 RPM 100 意味着一个账号每天最多约 14.4 万次请求,批量任务先看这一格再看单价。
还有两件事和生命周期有关。DeepSeek 的旧名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 仍能调用,
但对应模型已下线,由 V4.1 Flash 服务并按 Flash 计费。deepseek-v4-pro 的口径变过一次:我们
9 月 11 日写的时候,官方说 9 月 14 日后它会全部路由到
V4.1 Flash;现在更新日志的 9 月 10 日条目被就地改写为「决定在 2026 年 9 月 14 日之后继续提供 DeepSeek
V4 Pro 的 API 调用服务,计费方式保持不变;如有变动,我们将另行通知」,没有新开条目,价目页上它仍是
DeepSeek-V4-Pro-0813。口径改了而页面上没有留下改动记录,这种依赖值得写进清单。
最后说一句为什么不换成美元:三家的海外价拿去除国内价,隐含汇率分别是 6.67、7.14、5.33,最多相差 三成多,混着换算会凭空造出差距。你在哪个区域开的账号,就用哪张表。
新一代 Flash 的价格:MiMo 持平,Qwen 输入单价是上一代的 4 倍
各家从上一代换到这一代,价格走向并不一致。
MiMo 持平。 V2.6 发布文写「MiMo-V2.6 系列沿用 V2.5 系列的 API 定价」,价目页上 mimo-v2.6-flash 与 mimo-v2.5 共用一行。需要注意的是,同一页顶部写着 mimo-v2.5-pro、mimo-v2.5 将于北京时间 2026 年 10 月 21 日 10:00 下线,代码里写旧名的要在那之前改。
Qwen 换了计价形状。 上一代 qwen3.7-flash 按单次输入长度分三档:32K 以内 0.2 / 0.8 元,32K 到 256K 0.6 / 2.4 元,256K 以上 1.2 / 4.8 元。qwen3.8-flash 只有一档:1M 以内一律 0.8 / 2.7 元。
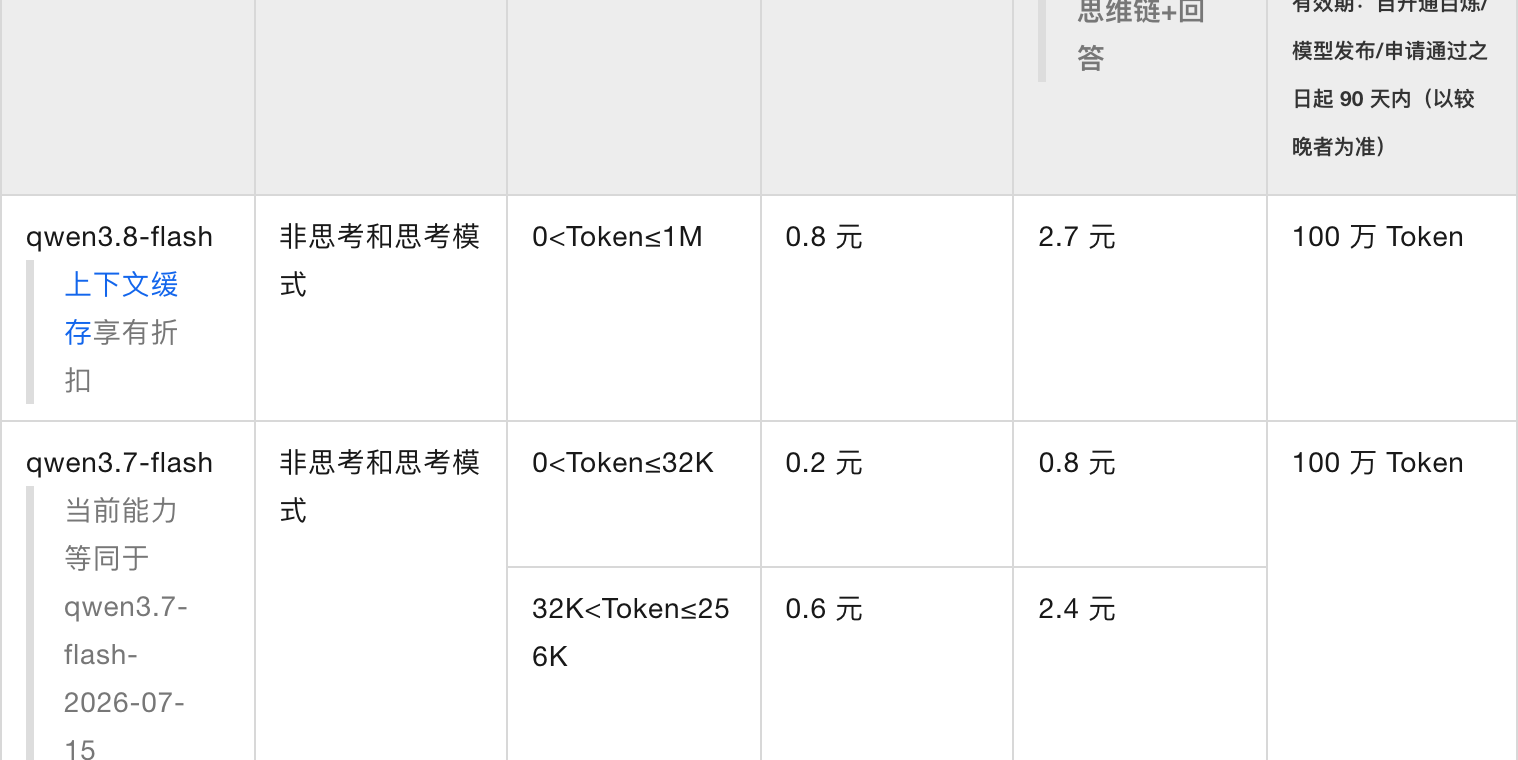
逐档对比:32K 以内,3.8 的输入单价是 3.7 的 4 倍、输出单价是 3.4 倍;32K 到 256K,输入贵 33%、输出 贵 12.5%;256K 以上,3.8 反而输入便宜三分之一、输出便宜四成多。qwen3.8-flash 的单档定价对长请求有利, 短请求要为此多付钱。短请求多、并且确认 3.7 能做对的负载,留在 3.7-flash 上是合理的。
另外两家。 DeepSeek 这一代的价格五个月里改了四次,9 月 11 日那篇 逐张对过,这里不重复。智谱的表上还挂着上一代:GLM-4.7-Flash 免费,GLM-4.7-FlashX 0.5 / 3 元,上下文 都是 200K。
对路由表的结论只有一句:升到新版本 Flash 不一定成本不变,每次升版都按自己的输入长度分布重算。
DeepSeek V4.1 Flash 和 Qwen3.8-Flash 对比:三种请求形态各算一遍
单价表不能直接比,账单是单价乘你的 token 结构。取三种常见形态,按千次请求算,单位元:
- A 短任务:2K 输入、全部未命中,400 输出(分类、改写、解释一条报错)
- B agent 一轮:40K 输入里 36K 命中、4K 未命中,1.5K 输出(带工具定义和历史的循环里的一步)
- C 长文档:300K 输入、全部未命中,3K 输出(整份合同或一个大文件的抽取)
| 模型 | A 短任务 | B agent 一轮 | C 长文档 |
|---|---|---|---|
| DeepSeek V4.1 Flash 空闲 | 3.60 | 10.72 | 312 |
| DeepSeek V4.1 Flash 高峰 | 7.20 | 21.44 | 624 |
| DeepSeek V4 Pro 空闲 | 14.40 | 43.65 | 1,390.5 |
| Qwen3.8-Flash | 2.68 | 36.05(上限) | 248 |
| Qwen3.8-Max | 38.40 | 534(上限) | 3,708 |
| Qwen3.7-Flash(对照) | 0.72 | 10.32 | 374 |
| GLM-5.3-Flash | 2.72 | 15.68 | 248 |
| GLM-5.3 | 27.20 | 146.00 | 2,484 |
| MiMo-V2.6 Flash | 2.80 | 7.72 | 306 |
| MiMo-V2.6 Pro | 8.40 | 21.90 | 918 |
算式:(命中 token × 命中价 + 未命中 token × 未命中价 + 输出 token × 输出价)÷ 100 万 × 1,000 次。 Qwen3.8 的 B 列是上限:命中价没公开,只能把命中 token 按未命中价算。Qwen3.7-Flash 的 B 列按通用规则算, 40K 输入落在 32K–256K 档,它不在 20% 例外名单里,隐式命中按 0.12 元计。
三列的读法各不相同。
A 列看时段。 空闲时段四家 Flash 在 2.68 到 3.60 元之间,最贵的比最便宜的高 34%,为这点差价多接一家 供应商不划算。工作时段 DeepSeek 涨到 7.20,是其余三家的 2.6 到 2.7 倍。短请求最便宜的反而是上一代 Qwen3.7-Flash,0.72 元。另外,这一列按 400 个输出 token 算,默认开着的思考会让它偏低:GLM 的思考关不掉, DeepSeek 和 MiMo 默认开着。A 类请求记得显式关掉思考,能关的都关。
B 列看命中价。 90% 命中时,MiMo Flash 7.72 元最低,DeepSeek 空闲 10.72,GLM 15.68,差距几乎全部来自 命中那一格(0.02、0.02、0.23)。Qwen3.8 那一格不公开,只能给 36 元的上限,所以在 Qwen 上,agent 负载的 成本模型没法只靠公开信息做完。另外,同样的前缀在四家的命中率不一定都是 90%,各家缓存机制不同,要按 各自 usage 实测。
C 列看阶梯和时段。 Qwen3.8-Flash 与 GLM-5.3-Flash 都是 248 元,DeepSeek 空闲 312、高峰 624, Qwen3.7-Flash 落进 256K 以上那一档要 374 元。
竖着看每一家的旗舰和 Flash,就得到标题里的区间:A 列 MiMo 从 8.40 到 2.80 省 67%,DeepSeek 从 14.40 到 3.60 省 75%,GLM 从 27.20 到 2.72 省 90%,Qwen 从 38.40 到 2.68 省 93%。三列的比例大致相同,因为各家旗舰与 Flash 在输入、输出上的单价比接近:DeepSeek 1/4.5 与 1/3.4,Qwen 1/15 与 1/13.3,GLM 两项都是 1/10, MiMo 两项都是 1/3。
这张表有一个前提:同一个请求在两个模型上产生同样多的 token。实际并非如此,下一节第三方的读数会修正这一点。
「Flash」不是成本档,也不是速度档:Artificial Analysis 的每任务成本与速度
先说读法。AA 用同一套评测(Intelligence Index v4.3.2)跑每个模型,把跑完整套评测的花费按 AA 自己选定的 单价折算到每个任务,这就是「每任务成本」;评测输出 token 是整套评测里模型一共生成了多少 token;「(max)」 表示按最高推理强度跑。AA 选价用的是美元列表价,DeepSeek 两行用的是高峰价。这些数只适合在这张表里横向比较, 不能和上一节的人民币算例混用。
| 模型(AA 条目名) | 指数 | 输出速度(tok/s) | 评测输出 token | 每任务成本 |
|---|---|---|---|---|
| MiMo-V2.6-Pro | 46 | 44.4 | 140M | $0.13 |
| Qwen3.8 Max (0902) | 45 | 39.3 | 190M | $5.41 |
| GLM-5.3 (max) | 45 | 84.2 | 210M | $2.01 |
| GLM-5.3-Flash | 42 | 55.9 | 180M | $0.25 |
| Qwen3.8-Flash-Next | 40 | 56.8 | 240M | $0.37 |
| DeepSeek V4.1 Flash (max) | 39 | 231.8 | 250M | $0.27 |
| MiMo-V2.6-Flash | 38 | 62.4 | 240M | $0.06 |
| DeepSeek V4 Pro 0813 (max) | 36 | 100.4 | 160M | $0.67 |
| DeepSeek V4.1 Flash(非思考) | 25 | 242.7 | 45M | $0.15 |
出处:AA 模型页 MiMo-V2.6-Pro、 Qwen3.8 Max、 GLM-5.3、 GLM-5.3-Flash、 Qwen3.8-Flash-Next、 DeepSeek V4.1 Flash、 MiMo-V2.6-Flash、 DeepSeek V4 Pro、 DeepSeek V4.1 Flash Non-reasoning。 2026 年 9 月 27 日 14:39 UTC 抓取;速度是各厂商自家 API 的实时读数,随时会变。
按每任务成本算,同家降档的幅度变成:MiMo 54%,DeepSeek 60%,GLM 88%,Qwen 93%。比列表价口径窄, 差出来的部分来自各模型生成的 token 数和缓存折扣不同。
看这张 9 月 27 日的截图,就能理解为什么文章标题不承诺「哪家最便宜」。如果只拿 API 输入价排序,MiMo Pro 应该离 Flash 很远;但在 AA 的特定评测流量、缓存折扣与输出量下,它的每任务成本甚至低于另三家 Flash。这不是生产环境的通用排序,恰恰说明按任务选型必须把用量和价格放到一起。
这张历史快照里有三处和「Flash」这个名字对不上。
一个旗舰的每任务成本低于另外三家 Flash。 MiMo-V2.6-Pro $0.13,低于 GLM-5.3-Flash 的 $0.25、DeepSeek V4.1 Flash 的 $0.27、Qwen3.8-Flash-Next 的 $0.37,指数还最高;自家 MiMo Flash 是 $0.06,更低。原因 AA 没有拆开, 输入(含缓存)和输出两部分共同决定。从 AA 页面的缓存折扣读数看(MiMo Pro 99%,GLM Flash 83%,Qwen Flash-Next 89%), 我推测主要来自缓存命中价,这是推断,不是 AA 的结论。还要加一个限定:DeepSeek 按高峰价计,换成空闲价约 $0.135, 与 MiMo Pro 基本持平。
DeepSeek 的 Flash 指数高于自家 Pro。 V4.1 Flash (max) 39,V4 Pro 0813 (max) 36。这与 DeepSeek 模型卡上 「Agentic 类全赢」一致;同一份模型卡的基础模型表里 Pro 在知识与长文档上领先,下一节会用到。
GLM-5.3-Flash 比 GLM-5.3 慢。 在 Z.ai 自家 API 上,Flash 55.9 tok/s,旗舰 84.2;AA 对它的评价是「notably slow and very verbose」。页面没有解释原因。速度在这家是另外卖的:GLM-5.3-FlashX 价格 2.5 倍、自报 200 tok/s, 四家快速档那篇算过这笔账。MiMo Flash 62.4 快于自家 Pro 44.4, DeepSeek V4.1 Flash 231.8 是全表最快。同样叫 Flash,最快和最慢差四倍多。
还要说明两个口径。智谱模型页写 GLM-5.3-Flash「在 AA 综合智能指数中取得 57 分」,出自旧版指数,我们 9 月 27 日所存 AA v4.3.2 快照是 42 分,两个版本的数不能放在一起比。表里的 Qwen3.8-Flash-Next 是开源权重版的名字,AA 按阿里 API 测,上下文记 256K; 据 Qwen 官方博客,API 版 qwen3.8-flash 是默认 1M 上下文、内置官方工具的生产版本(我们在 GLM-5.3-Flash 与 Qwen3.8-Flash-Next 那篇里转述过),两者关系很近, 但不是同一个 SKU。
什么任务可以用 Flash 模型:任务类型、可否降档、降档后常见的坏法
这一问最直接的材料,是厂商把自家 Flash 和旗舰放在同一张表里的 benchmark。有两家给了:MiMo-V2.6 发布文的 Table 3(厂商自评,Flash 与 Pro 同表),和 DeepSeek V4.1 Flash 模型卡(instruct 表与基础模型表,我们 9 月 11 日 逐行核过)。
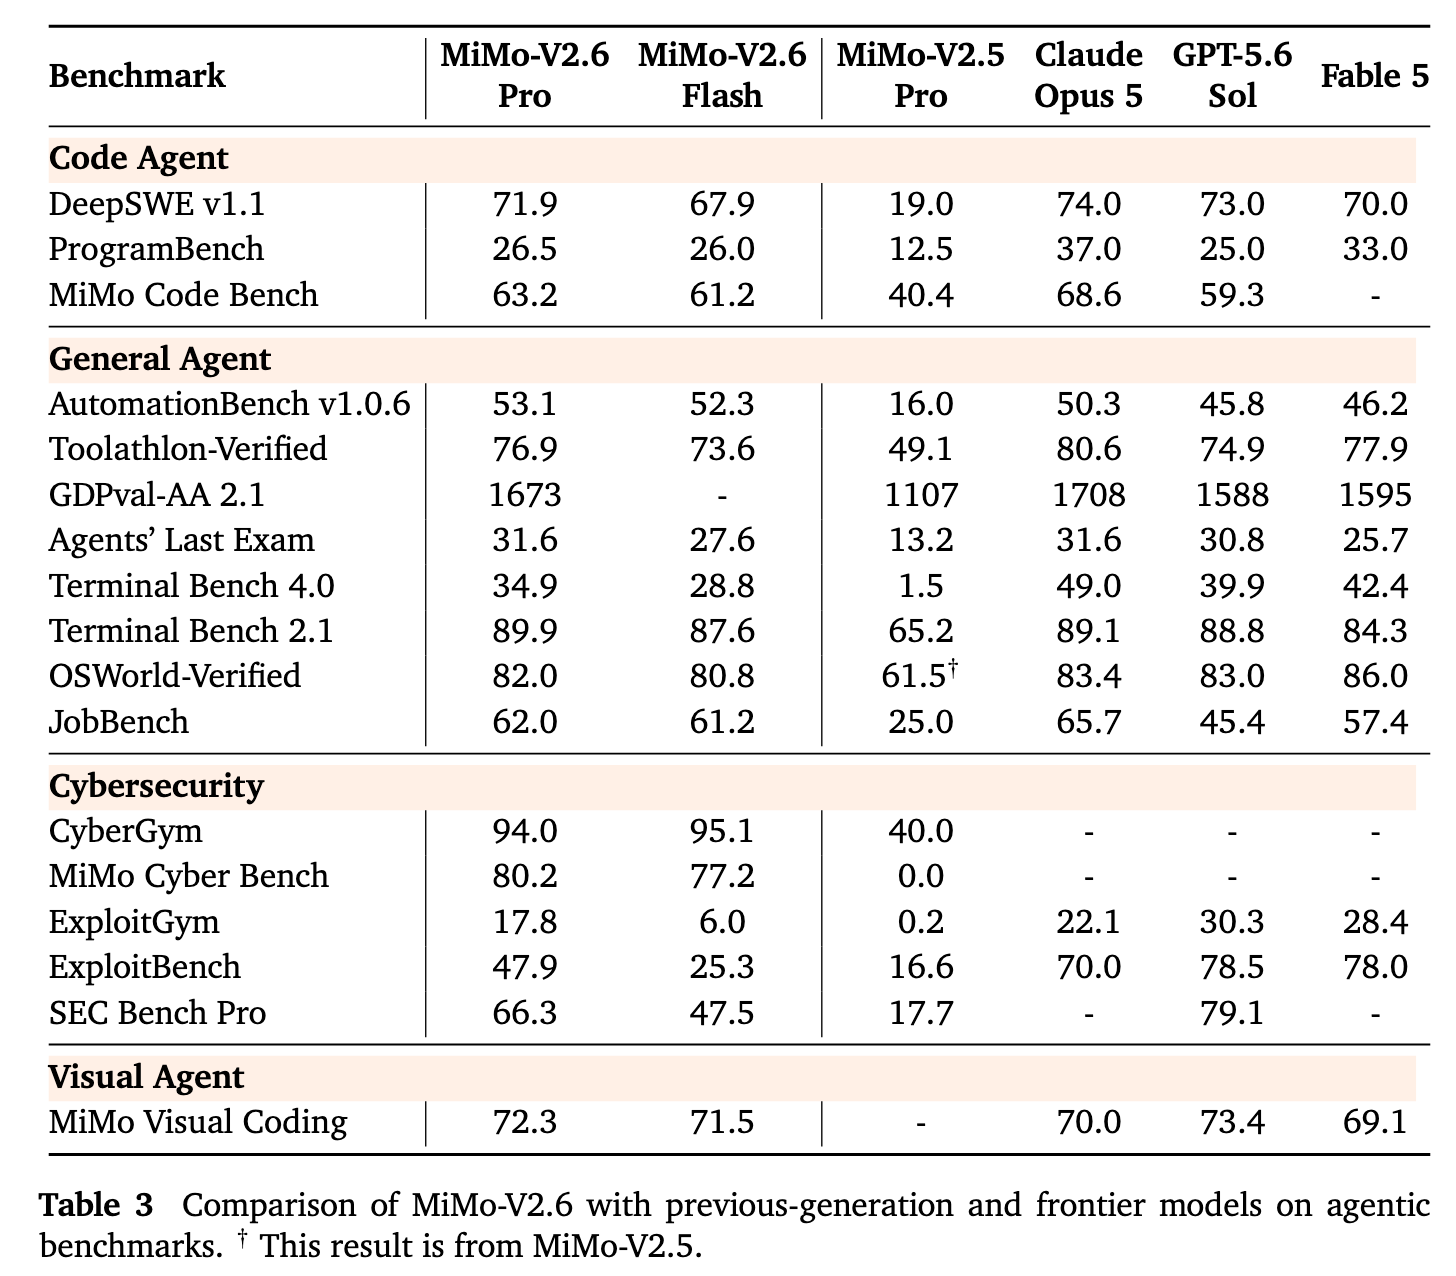
MiMo 表的规律:多数 agent 与代码项 Flash 落后 Pro 不到 4 分,Terminal Bench 4.0 落后 6 分,构造漏洞利用的 两项(ExploitBench、ExploitGym)只有 Pro 的一半和三分之一。DeepSeek 两张表合起来读:instruct 表上 Agentic 类 V4.1 Flash 全赢 V4 Pro,基础模型表上 SimpleQA-Verified 42.3 对 55.2、LongBench-V2 45.2 对 51.5,知识与长文档 Flash 落后。安全类两家方向相反:DeepSeek 更新日志给 V4.1 Flash 的 CyberGym 88.1、SEC-Bench Pro 62.8、ExploitGym 15.3, 都高于 V4 Pro 的 83.3、56.4、5.4,也是厂商自评。
表中 ✓ 表示低风险且可核任务可以先试 Flash,仍需人工抽检与漏检评估;⚠ 表示有条件降档,要配预算或自测;✗ 表示旗舰优先。证据列 标注类型:厂商同表(同一家 Flash 与旗舰同条件对比)、基础模型表(基座而非对话模型)、第三方(AA)、 主线源(掘金作者的经验观点)、我方判断(无量化数据)。
| 任务类型 | 可否降到 Flash | 降档后常见的坏法 | 证据(类型) |
|---|---|---|---|
| 翻译、摘要、改写、会议纪要 | 低风险场景先试 Flash,人工抽检 | 输出变长,思考 token 进账单;偶尔增删事实 | 主线源;思考默认值(官方文档);评测输出 180M–250M(第三方);质量无同表数据(我方判断) |
| 分类、意图识别、抽取成 JSON | 低风险场景先试 Flash,schema + 语义抽检 | 字段漂移、枚举值越界 | 四家都支持结构化输出(官方文档);质量无同表数据(我方判断) |
| 边界清楚的代码修改 | 先试 Flash,编译测试 + 差异审阅 | 表面修好、别处坏掉,来回改几轮 | MiMo DeepSWE 67.9 对 71.9、MiMo Code Bench 61.2 对 63.2(厂商同表);主线源 |
| 多步工具调用、常规 agent 流程 | 可降,设步数预算 | 链条末端失手,重试把省下的钱吃回去 | MiMo Toolathlon 73.6 对 76.9(厂商同表);DeepSeek Agentic 类 Flash 反超(厂商同表) |
| 长程终端任务、跨模块重构 | 旗舰优先,或旗舰规划 + Flash 执行 | 中途遗忘约束,走偏后自我确认 | MiMo Terminal Bench 4.0 28.8 对 34.9(厂商同表);主线源 |
| 长上下文召回 | 按输入长度分桶自测 | 放得进窗口,找不回信息 | DeepSeek LongBench-V2 差 6.3(基础模型表) |
| 无工具的事实性问答 | 旗舰或加检索 | 答错且答得流畅 | DeepSeek SimpleQA-Verified 差 12.9(基础模型表) |
| 安全审计、漏洞利用 | 按厂商分:MiMo 留旗舰,DeepSeek 可自测 | 能发现问题,构造不出利用链 | MiMo ExploitBench 25.3 对 47.9、Cyber Bench 77.2 对 80.2(厂商同表);DeepSeek 三项 Flash 反超(厂商自评) |
| 需求拆解、架构规划 | 旗舰 | 计划错了,后面执行得再便宜也白做 | 主线源;我方判断 |
| 强实时交互 | 看厂商,不看名字 | 以为 Flash 快,实际比旗舰慢 | DeepSeek Flash 231.8 tok/s,GLM-5.3-Flash 55.9 慢于 GLM-5.3 84.2(第三方) |
✓ 只表示低风险且有可核验办法的任务可以先试 Flash,不表示一定做得对。翻译要抽样对照原文,JSON 过 schema 只证明结构合法、不证明字段语义正确;代码过编译和测试也可能遗漏未覆盖的行为。错误可能漏检,人工复核也有成本,重试与升档的次数没有「最多一次」的保证。先为每类任务测接受率、抽检成本和漏检代价,再决定能否默认降档。✗ 那几行错误尤其不容易自动发现:事实答错仍可能流畅,规划错了要等执行完才知道。降档判据不只是任务难不难,还要问错误能否被可靠且足够便宜地发现;这是我方判断,不是厂商评测结论。
DeepSeek 模型卡的 scaffold 表还提醒了一件事:同一个 V4.1 Flash checkpoint 换八套 agent 框架,DeepSWE 从 65.5 到 74.2,相差 8.7 分,比 MiMo 表里 Flash 与 Pro 的 DeepSWE 差距还大。厂商表可以用来决定先试哪一家的 Flash, 要不要上线得看你自己的框架跑出来的结果。
把降档写成路由规则:四条判据和各自的代价
主线源那两句话写成机器能执行的形状,大致如下。这是示意配置,不对应任何产品的真实语法:
# Illustrative policy, not a product configuration syntax.
# Phase 1: select the tier; rules are top-down, first match wins.
tiers:
  flash:    { default: glm-5.3-flash, classify: deepseek-flash, high_cache: mimo-v2.6-flash }
  flagship: { default: mimo-v2.6-pro, long_input: qwen3.8-max }
defaults:
  tier: flash
rules:
  - match: { input_tokens_gt: 200000 }
    tier: flagship
  - match: { task: [plan, refactor_cross_module, exploit, closed_book_qa] }
    tier: flagship
  - match: { task: [classify, extract_json] }
    tier: flash
    thinking_policy: disable_if_supported
    verify: { json_schema: true, semantic_sample_review: true }
    on_fail: { retry_same_tier: 1, then: flagship }
  - match: { task: [translate, summarize, rewrite] }
    tier: flash
    verify: { semantic_sample_review: true }
  - match: { task: [code_patch] }
    tier: flash
    verify: { build: true, tests: true, diff_review: true }
    on_fail: { retry_same_tier: 1, then: flagship }
  - match: { task: [agent_loop] }
    tier: flash
    budget: { max_steps: 30 }
    on_budget_exceeded: flagship

# Phase 2: choose a model key, top-down first match; derive vendor from model.
model_selection:
  rules:
    - match: { tier: flagship, input_tokens_gt: 200000 }
      key: long_input
    - match: { tier: flash, task: [classify, extract_json] }
      key: classify
    - match: { tier: flash, cache_hit_rate_gte: 0.8 }
      key: high_cache
  default_key: default

# Phase 3: after model/vendor resolution, evaluate scheduling top-down.
post_route:
  policies:
    - match: { vendor: deepseek, peak_hours: true, mode: async }
      defer_to: next_off_peak
    - match: { mode: sync }
      dispatch: now
default: { dispatch: now }三步不能混为一条规则链:先按输入长度和任务类型取第一条命中的分档规则(没命中则用 defaults);再用 model_selection 的首条命中选择 tiers 中明确列出的模型键,从型号确定 vendor;选完厂商才跑 post_route,它不会被前面的任务规则抢走。示意的 classify: deepseek-flash 只为展示后置策略怎样触发,不是说 DeepSeek 是分类任务最划算的实测胜者;实际映射必须按团队流量里每个被接受结果的成本与质量重新确定。next_off_peak 只用于允许延期的异步请求;同步请求必须立即处理,异步请求若不命中 DeepSeek 高峰条件也立即处理。thinking_policy: disable_if_supported 仅在所选模型支持关闭思考时才关闭;智谱这类不可关闭的模型保持启用,预算须计入思考 token,超预算就另选型号而不是默默忽略成本。semantic_sample_review 的比例与漏检成本应从自己的业务风险定,不是可照抄的 2%。
拿三条实际输入验这套示意规则:
| 输入与第一阶段首命中 | 选模后第二阶段结果 | 为什么 |
|---|---|---|
300K 输入、task: classify → 长度规则先命中,进 flagship | model_selection 的长输入规则 → qwen3.8-max;即使工作日高峰、异步也立即执行 | 分类规则不会越过长度规则;确定的厂商不是 DeepSeek |
2K 输入、task: classify → 分类规则进 flash | model_selection 的分类规则 → tiers.flash.classify 即 deepseek-flash;工作日高峰且 mode: async → 延期到下一空闲时段 | 分类的型号在 YAML 明确列出,后置调度不会被任务规则遮住 |
| 同一 2K 分类请求 → flash | 同样确定 deepseek-flash;高峰但 mode: sync → 立即执行 | 同步请求首命中立即执行策略,不因便宜而延迟 |
四条判据与 yaml 的对应关系,以及各自的代价:
-
按任务类型和输入长度分档,不按模型名分档(
tiers映射与前两条规则)。规则写「这类请求用 Flash」, 具体用哪家 Flash 由一张随价目表更新的映射决定。长度规则放在最前,否则会被任务规则先匹配走。代价是请求 要带任务标签。 -
每个 ✓ 都要有明确的验收方法,自动校验与人工抽检各算成本(各条
verify与部分on_fail)。JSON schema 只查结构、编译测试只查覆盖到的行为,语义和漏检要抽样复核;没有自动失败信号的翻译不能假装能自动升档。代价是人审、重试、遗漏错误与升档率;哪类任务值得默认降档,只能拿自己的接受率和风险账本回答。 -
选厂商看每个被接受结果的成本,不看列表价(
model_selection与tiers映射)。把真实流量在两三家 Flash 上重放,记录 token 数、重试次数、通过率,算出每个被接受结果花了多少钱,再把通过验证的选型更新到模型键。YAML 中的分类模型只是流程示例,不代表实测推荐。代价是一轮重放的费用,以及每次调价后重算。 重放前先确认你和上游的合同、用户协议允许把这些数据发给另一家,必要时先脱敏。 -
把时段、阶梯、下线日期、限时优惠状态都当作决策维度(
tiers映射与独立的post_route调度策略)。DeepSeek 的高峰价翻倍,只能在已经选定 DeepSeek 且任务异步可延期时等到下一空闲时段;Qwen 价目形状随输入档不同、MiMo V2.5 在 10 月 21 日下线、DeepSeek 旧名被静默路由,也都要在模型映射里可见。几项「限时免费」尚未写结束日期;只有优惠结束且实际使用相应缓存时,才重新计算该项费用。代价是一张要持续维护并核对的价目与生命周期表。
第四条本该是路由层的职责。我们在做的 PiRouter 设计为把任务标签、价目表版本和模型 生命周期放在同一层做决策,这不是上线承诺。不用我们的工具,规则也是同样这几条。
名字是厂商起的,哪类请求值得哪一档,要看你自己的数据
四张价目表对完,关于「Flash 模型怎么选」,我能说的是三件事:同家旗舰到 Flash 的价差从三倍到十四倍,先按 厂商算降档值不值;缓存命中价、时段和阶梯决定 agent 与长文档负载的账单,比「Flash」这个名字重要;降档的边界 在于错误能不能被便宜地发现。
「哪家 Flash 最好」我回答不了,答案在你的流量里。这周可以这样做:
- 导出一周调用日志,每条至少有这些字段:时间戳、调用方(服务名或 API Key)、model、输入 token、命中 token、
输出 token(含思考)。命中字段各家叫法不同:DeepSeek 是
usage.prompt_cache_hit_tokens(DeepSeek 上下文硬盘缓存),百炼是usage.prompt_tokens_details.cached_tokens;另外两家我们没核到,以各自文档为准。 - 按阈值分成三种形态,例如:输入低于 8K 且命中率低于 50% 归 A,命中率 50% 以上归 B,输入超过 100K 归 C。 阈值按你的分布调整。
- 按调用方打任务标签:同一个服务发出的请求通常是同一类任务,先按服务粗分,再抽几十条人工确认,比逐条分类便宜。
- 算可省上限:每一组的旗舰花费 ×(1 − 同家 Flash 与旗舰的单价比),只加总任务表里 ✓ 和 ⚠ 的组。 这个数是本次降档能省下的上限,实际能省多少,要扣掉升档和重试之后才知道。