
DeepSeek V4.1 Flash 降价降了多少?缓存命中 60%、输出只有 11%;deepseek-v4-pro 改道计划已撤回(9 月 28 日更新)
9 月 10 日 12:00 起 DeepSeek Flash 系列降价:缓存命中 0.05 → 0.02 元、未命中 1.5 → 1 元、输出 4.5 → 4 元(空闲时段,元 / 百万 tokens)。前两档精确退回 8 月 17 日涨价前的原点,输出仍是涨价前 2 元的 2 倍——省多少全看你的 token 结构,11% 到 60%。(9 月 28 日更新:DeepSeek 已改为 9 月 14 日后继续提供 V4 Pro,计费不变,原定的改道不再成立。)三张官方价目表逐档对账,一张发布次日被替换的中文基准表,以及 14 日前该做的两件事。
更新(2026-09-28):本文发布后,DeepSeek 在更新日志的 9 月 10 日条目里改为:「为响应广大用户的需求,我们决定在 2026 年 9 月 14 日之后继续提供 DeepSeek V4 Pro 的 API 调用服务,计费方式保持不变;如有变动,我们将另行通知。」(9 月 27 日核对)所以下文「9 月 14 日起 deepseek-v4-pro 全部路由到 V4.1 Flash、没有退出选项」的判断已不成立;Flash 降价的部分不受影响。这条是在原条目里改写的,没有新开日期,我们无法确认改口的具体时间。
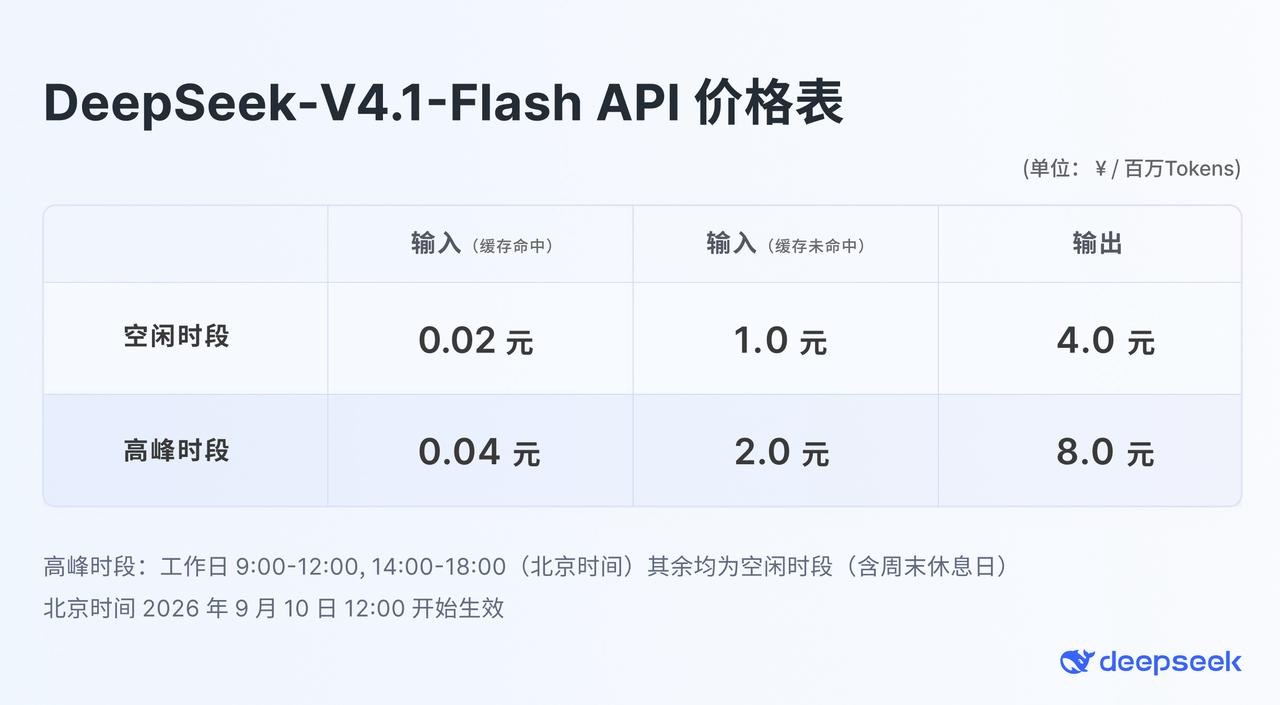
先回答标题。降了,但只有两档退回原点。 9 月 10 日 12:00(北京时间)起,deepseek-flash
空闲时段的价格是:缓存命中 0.02 元、缓存未命中 1 元、输出 4 元(元 / 百万 tokens),高峰时段
翻倍。以 8 月 17 日起的价目表为基准,三档分别降了 60%、33% 和 11%;以 8 月 17 日之前的
价目表为基准,前两档一分不差地退回去了,输出 4 元仍是当时 2 元的 2 倍,高峰时段 8 元是 4 倍。
数字来自官方价目页的现行版本和两份
Wayback 快照,下一节逐格对。
第二个问题的答案更短。9 月 14 日 12:00(北京时间)之后,所有发给 deepseek-v4-pro 的请求
会被路由到 V4.1 Flash,按 Flash 价格计费,没有关掉这件事的开关,持续到一个还没有日期的
V4.1 Pro 上线为止。Pro 本轮一分没降(0.15 / 4.5 / 13.5 元),但从 14 日中午起,这三个数字
只对一个你已经调不到的模型有效。
这篇把三件事拆开:价目表怎么退的、你的账单会退多少、「名字不变模型变」在 14 日会以什么形状 落到你的调用上。中间顺带核两件厂商没主动说的事:「全面超越 V4 Pro」那张表在中文公告页上 发布次日被换过一版;这个叫 Flash 的模型到底多少参数。峰谷机制 8 月 已经写过,不重讲。
三张价目表摞在一起:两档退回原点,输出留在 2 倍
三张表都是官方价目页,只是三个时点。第一列是 7 月 31 日的 Wayback 快照, 当时还没有峰谷;第二列是 8 月 16 日 16:13 UTC 的快照, 距涨价生效不到一小时;第三列是现行页。 单位元 / 百万 tokens,斜线前空闲、斜线后高峰。
| 计费项 | 8·17 前 | 8·17 起 | 9·10 起 | vs 8·17 | vs 8·17 前 |
|---|---|---|---|---|---|
| Flash 缓存命中 | 0.02 | 0.05 / 0.10 | 0.02 / 0.04 | −60% | 持平 / 2 倍 |
| Flash 缓存未命中 | 1 | 1.5 / 3.0 | 1 / 2 | −33% | 持平 / 2 倍 |
| Flash 输出 | 2 | 4.5 / 9.0 | 4 / 8 | −11% | 2 倍 / 4 倍 |
| Pro 缓存命中 | 0.025 | 0.15 / 0.30 | 0.15 / 0.30 | 0 | 6 倍 / 12 倍 |
| Pro 缓存未命中 | 3 | 4.5 / 9.0 | 4.5 / 9.0 | 0 | 1.5 倍 / 3 倍 |
| Pro 输出 | 6 | 13.5 / 27.0 | 13.5 / 27.0 | 0 | 2.25 倍 / 4.5 倍 |
前两行是「精确退回」:0.02 就是 0.02,1 就是 1。这种退到底的调价不常见,一般是往中间某个 位置靠一下。第三行是另一回事:4.5 到 4 账面降 11%,但参照系换成 8 月 17 日之前的 2 元, 空闲价是它的 2 倍,高峰价是 4 倍。掘金上一位作者的概括是我看到最准的: 「输入是退回,输出是打折后的涨价」 (DeepSeek 明天又降价(涵历史价格对比))。
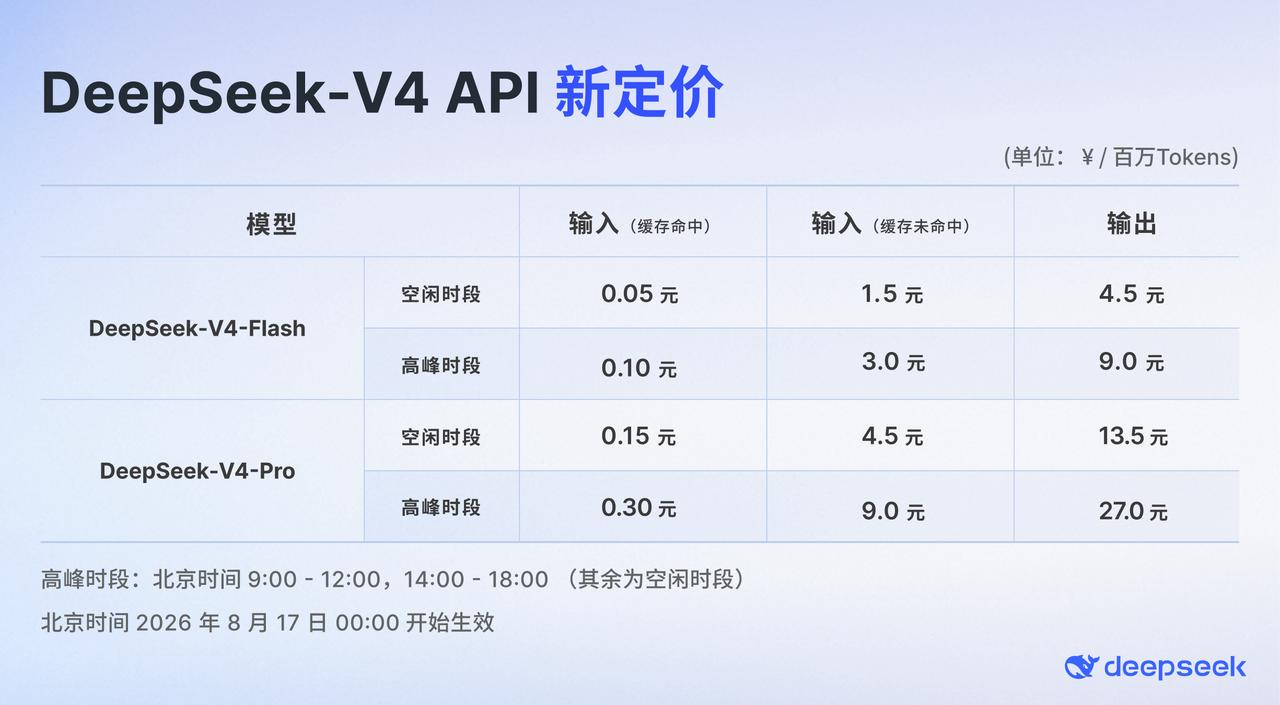
Pro 那三行也值得看一眼。本轮 Pro 没动,但 8 月那次它涨得比 Flash 狠得多:缓存命中从 0.025 元到高峰 0.30 元是 12 倍,InfoWorld 当时报的 「最高涨 1,100%」(DeepSeek raises some V4 prices by more than 10x) 就是这一格。记住这一行,14 日那一节会用到:改道之后按 Pro 名字计的账单会降到 Flash 价, 比 Pro 有史以来任何一张表都低。
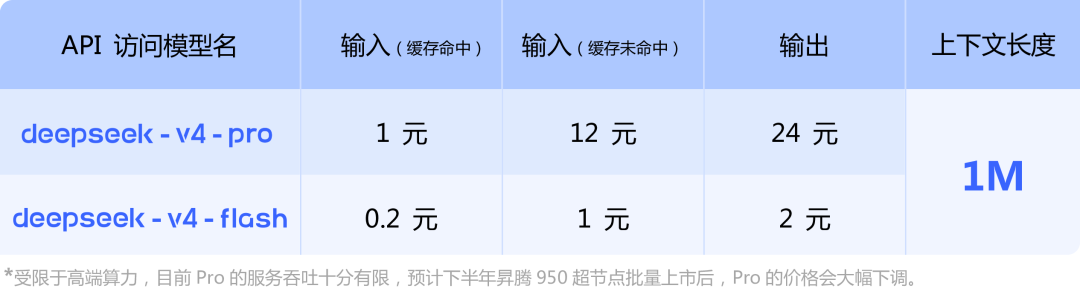
再往前翻一张。这是 V4 系列五个月里的第四张价目表。4 月 24 日上线时 Flash 是 0.2 / 1 / 2 元、Pro 是 1 / 12 / 24 元,配图脚注写着「受限于高端算力,目前 Pro 的服务吞吐 十分有限,预计下半年昇腾 950 超节点批量上市后,Pro 的价格会大幅下调」。 到 7 月 10 日的快照, Flash 缓存命中已经是 0.02、Pro 已经是 0.025 / 3 / 6——中间降过一轮,Pro 的下调兑现了。 然后 8 月 17 日涨回去,9 月 10 日 Flash 再退两档。7 月 31 日那份快照的脚注 (2) 已经预告 「即将采用峰谷定价策略……具体时间以正式通知为准」,7 月 10 日那份还没有这句话。也就是说 8 月的涨价提前挂过预告、没给日期;9 月的降价是反过来的——9 月 9 日开放平台 「用量信息」页的横幅已经列出三个新数字和「9 月 10 日 12:00」,价目页本身直到生效才改。 从横幅到生效,一天。
一个不影响账单、但影响你怎么读页面的细节:8 月 16 日快照的脚注写的是「高峰时段为北京时间 9:00 - 12:00、14:00 - 18:00」,没有「周一至周五」四个字;现行页的脚注 (3) 加上了 「周一至周五」,9 月 10 日的配图也写了「含周末休息日」为空闲。8 月里周末按哪档计费,页面没说, 我们也不猜——你 8 月的账单里有答案。
为什么同一天有人说降 60%、有人说没降:基准线不同
9 月 10 日当天,中英文两边对同一张价目表得出了相反的标题。掘金那两帖写「Flash 降价 60%」,
用的是 8 月 17 日起的表做基准,60% 是缓存命中那一档。一家英文路由平台的博客写的是
「it is the same Flash rate card as before rather than a cut」
(OrcaRouter — DeepSeek V4.1: A New Base Model)——
它把 9 月 10 日的 deepseek-flash 价格和 9 月 10 日的 deepseek-flash 价格比,V4.1 Flash 这个
模型从上线起就只有一张价目表,当然「没降」。ITmedia 的框架是第三种:
「8 月 13 日のAPI料金値上げから一転」,8 月 13 日是公告日,8 月 17 日是生效日,同一件事的两个时钟。
三种说法在各自的基准线上都成立。问题在于官方自己没给基准:更新日志 的「API 定价调整」一条全文只有一句——「随着 DeepSeek-V4.1-Flash 上线,API 价格同步下调」, 英文版对应的是「API prices have been reduced accordingly」。「同步」和 accordingly 都没说 相对哪一张表。于是每个转述者自己挑了一条基准线,读者拿到的是 60%、11%、0% 三个互相打架的数。
我们的对账规矩就一条:写降幅必须写基准日期。 本篇给了三条基准(8·17 前、8·17 起、 9·10 起),你按自己账单的时间段挑。如果你 8 月 17 日之后才开始用 DeepSeek,这次是实打实的 降价;如果你从 7 月一路用到现在,这次只是把 8 月多收的一部分还了回来,输出那部分没还。
你能省多少:全看 token 结构
三个百分比是按计费项算的,账单不是。账单是三档花费的加权和,权重就是你的 token 结构。 用 8 月 17 日起的价目表算出三档各占多少钱,降幅等于 0.60 × 缓存命中占比 + 0.33 × 未命中占比 + 0.11 × 输出占比。缓存命中占比高的 agent 场景 往 60% 靠,纯生成往 11% 靠,中间是大多数人。
四个算例,单位元,空闲时段,第一行是掘金那篇给的:
| 场景(token 量) | 8·17 前 | 8·17 起 | 9·10 起 | vs 8·17 | vs 8·17 前 |
|---|---|---|---|---|---|
| 1M 未命中 + 1M 输出 | 3 | 6 | 5 | −17% | +67% |
| 生成型:0.2M 未命中 + 1M 输出 | 2.2 | 4.8 | 4.2 | −12.5% | +91% |
| 对话型 agent:10M 命中 + 1M 未命中 + 0.5M 输出 | 2.2 | 4.25 | 3.2 | −25% | +45% |
| 长上下文 agent 循环:100M 命中 + 2M 未命中 + 1M 输出 | 6 | 12.5 | 8 | −36% | +33% |
两个读法。第一,要把降幅做到 30%,每个输出 token 得配大约 57 个缓存命中 token;做到 40%, 大约 130 个。这是把未命中放到零算的,真实结构里有未命中只会更难。你的比例在计费导出里, 那是第一个该拉的数。第二,最后一列全是正数——只要账单里有一个输出 token,就比 8 月 17 日 之前贵。两档输入退回了原点,输出是 2 倍,任何有输出的组合都退不回去。生成型的 +91% 是最难看的那格,也是最常见的那类工作负载。
那接下来优化什么。输入端已经便宜到不值得再抠:未命中 1 元、命中 0.02 元,50 倍的差距把 「把 system prompt 和可复用上下文切出来做前缀缓存」的收益又还给你了,但再往下抠 prompt 长度,工程时间比省下的钱贵。该动的是输出端:输出长度上限、结构化返回、别让模型复述你 刚发给它的东西。掘金那位作者还有一句我同意的:为那 11% 改架构不值得,省的是小钱、动的是 大钱。至于把批处理往空闲时段挪,仍然是唯一能让一档确定减半的操作, 8 月那篇算过它值账单的多大一块。
价目表照着架构的形状退(我方推演)
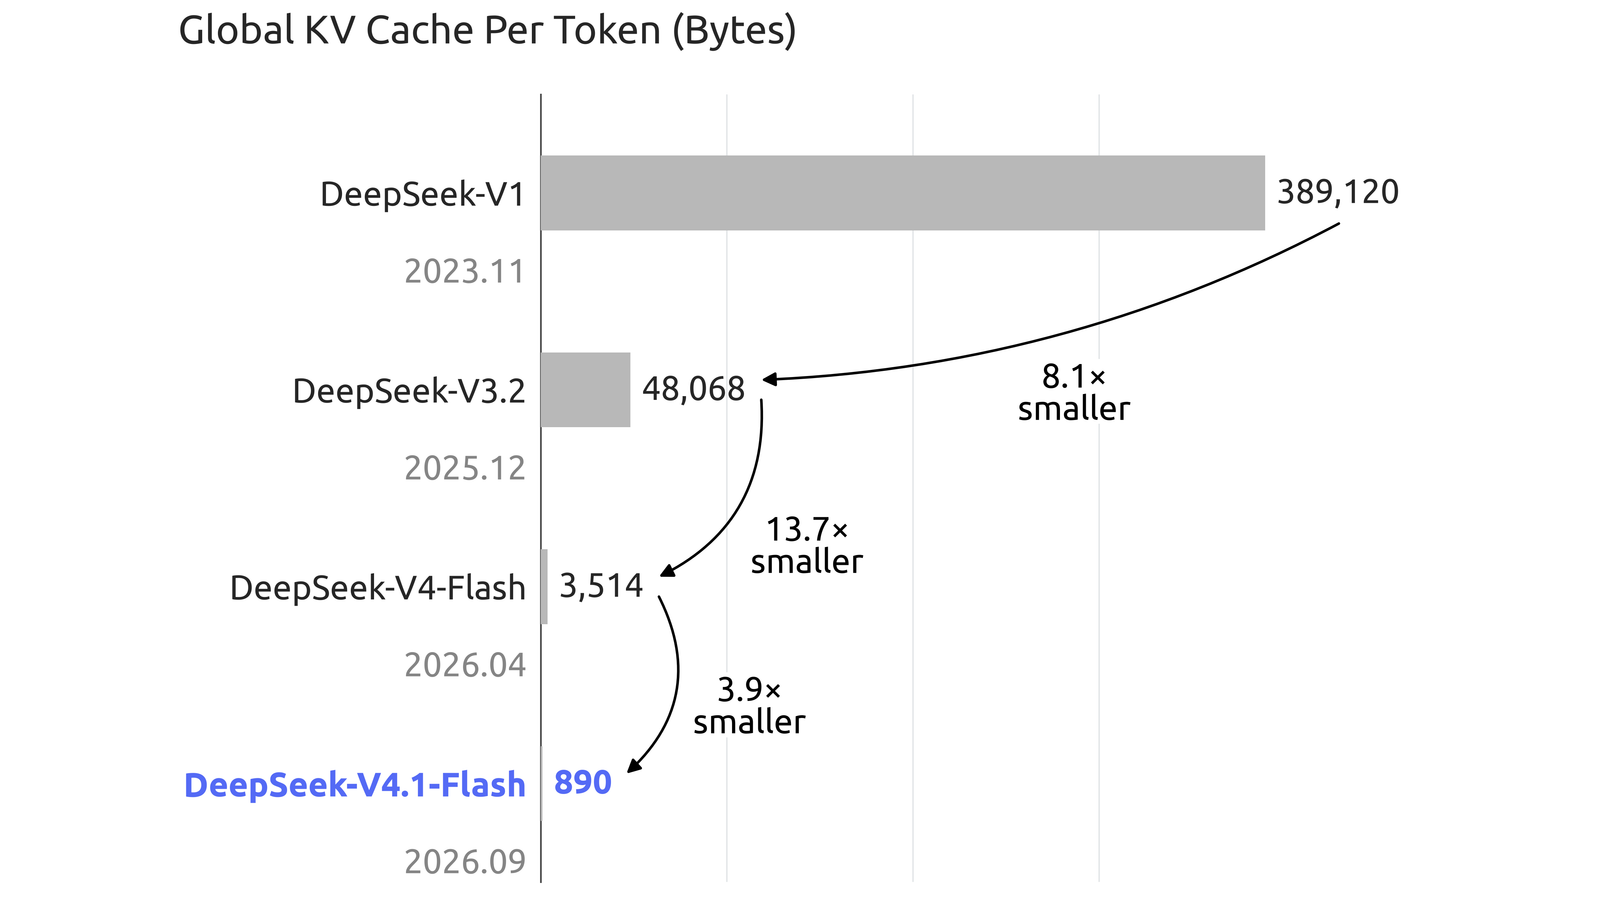
为什么恰好是输入退、输出不退,官方公告给了半个答案。V4.1 Flash 的结构是不对称的: 官方公告写「输入激活只有 8B, 输出激活 16B」;上一代 V4 Flash 两端都是 13B (Hugging Face 模型卡的基础模型表 第二行)。同一份模型卡说,全局 KV cache 压到每 token 890 字节,约为 V4 Flash 3,514 字节的 四分之一;公告的说法是对 HBM 的需求减到 1/4、对 SSD 减到 1/8,那一节的小标题就叫 「更少缓存,更省成本」。封面那张图是官方画的这条曲线。
把这两组数字和价目表放在一起,形状是对得上的:输入端每 token 的激活参数从 13B 降到 8B、 缓存每 token 的字节数降到四分之一,输入两档退回原点;输出端每 token 的激活参数反而从 13B 升到 16B,输出价留在 2 倍。这是我们的读法,DeepSeek 没这么说——公告只说「得益于模型 架构的创新……相应下调了 V4.1 Flash 的定价」,没有解释为什么输出没一起下调。掘金那位作者 的说法是「价格表有时候比官方说明更诚实」,我倾向同意:这张表把成本分布写得比公告直白, 生成那一端是硬开销,输入便宜是在买你的调用量。
对你的成本模型,这个推演有一个可操作的含义:如果输出价是被激活参数量顶住的,那它不会跟着 下一次「缓存优化」再降。下次降价通知来的时候,先看输出那一格动没动,再决定要不要改预算。
9 月 14 日 12:00 起,deepseek-v4-pro 会变成什么
更新(2026-09-28):本节是 9 月 10 日公告时的情况。DeepSeek 之后已改为继续提供 V4 Pro,见文首说明。
先把通知链排出来,因为这条链本身就是要点。
| 时间(北京时间) | 渠道 | 内容 |
|---|---|---|
| 9 月 8 日下午 | 官方交流群 | V4.1 Flash 中间版内测,模型名 deepseek-v4.1-flash-expires-on-0910,计费同 deepseek-v4-flash,每账号 20 并发(掘金 — DeepSeek V4.1 Flash 来了,明天中午 Flash 降价 60%实录) |
| 9 月 9 日 | 开放平台「用量信息」页横幅 | 「在 V4.1 Flash 正式上线之后、V4.1 Pro 上线之前,我们会将对 V4 Pro 的请求全部路由到 V4.1 Flash,并按 V4.1 Flash 单价计费」——没有缓冲期;同一横幅列出 Flash 新价(掘金同帖原文;英文版见 HN — DeepSeek launching v4.1 flash cheaper and more capable than v4 pro,采集时 415 分) |
| 9 月 10 日 | DeepSeek 发给 API 用户的邮件(用户转贴) | 「we plan to postpone the discontinuation of the V4 Pro service to 12:00 Beijing Time on September 14」(HN 用户 lionkor 转贴的邮件全文,非官方页面) |
| 9 月 10 日 | 更新日志 + 价目页脚注 (2) | 正式口径:9 月 14 日 12:00 之后,至 V4.1 Pro 上线前,deepseek-v4-pro 全部路由到 V4.1 Flash,按 V4.1 Flash 价格计费 |
| 9 月 10 日 12:00 | 价目页脚注 (1) | deepseek-v4-flash、deepseek-v4-flash-vision-exp「对应模型已下线,请求将由 DeepSeek-V4.1-Flash 模型提供服务」——当天生效,零缓冲 |
三件事值得从这张表里单独拎出来。
14 日这个日期本身是「推迟」的结果。 9 月 9 日横幅的原计划是 V4.1 Flash 上线即改道,
也就是 9 月 10 日;10 日的邮件把它推到了 14 日。从最早的公开通知到改道生效,五天;
从官方页面挂出日期到生效,四天。两个旧 Flash 名字拿到的是零天:10 日中午价目页脚注 (1)
出现的时候,模型已经换了。4 月那次 deepseek-chat / deepseek-reasoner 指向 V4 Flash,
更新日志给了三个月缓冲;这次三个名字分别是
零天和四天。DeepSeek 的条款对调价不承诺通知期,
现在看,对「名字指向哪个模型」也一样。
没有退出选项。 没有开关、没有钉版本、没有付费保留档。公告的措辞是「至未来 V4.1 Pro 上线之前」,V4.1 Pro 没有任何日期。想继续用 V4 Pro 只剩一条路:它是开源权重,找第三方 托管或者自己部署,1.6T 参数的部署成本另算。
改道的两面。 同一件事有两种读法,取决于你把 deepseek-v4-pro 当成一个价格档还是
一个已经调好的模型。当成价格档,这是厂商主动把你的账单砍掉七成;当成调好的模型,这是
你精心对着 Pro 调过的 prompt、评测集和输出格式,在没有你签字的情况下换了后端。
改道前后,按 Pro 这个名字发出去的请求会拿到什么,逐项对:
| 项 | 改道前(deepseek-v4-pro = V4 Pro) | 改道后(= V4.1 Flash) |
|---|---|---|
| 模型版本 | DeepSeek-V4-Pro-0813,1.6T 总参 / 49B 激活 | DeepSeek-V4.1-Flash,552B 骨干 / 输入 8B · 输出 16B 激活 |
| 缓存命中(空闲 / 高峰) | 0.15 / 0.30 元 | 0.02 / 0.04 元(−87%) |
| 缓存未命中 | 4.5 / 9.0 元 | 1 / 2 元(−78%) |
| 输出 | 13.5 / 27.0 元 | 4 / 8 元(−70%) |
| 图像理解 | 不支持 | 支持 |
| 上下文 / 最大输出 | 1M / 384K | 1M / 384K |
| 并发上限 | 500 | 页面没写改道后归哪一档(deepseek-flash 名下是 2500) |
| 退出选项 | — | 无 |
| 持续到 | — | V4.1 Pro 上线(无日期) |
价格那三行是账单会看到的:按 Pro 名字计费的钱降七到九成,比 4 月上线以来任何一张 Pro 价目表都低。模型那一行是回归测试会看到的:从一个 1.6T / 49B 激活的模型换到 552B / 8B–16B 激活,图像理解从不支持变成支持——一个此前对图片报错的端点从 14 日中午起会开始接受图片, 如果你的输入校验依赖那个报错,它会静默失效。并发那一行是页面没写的:Pro 名下 500、Flash 名下 2500,改道后的 Pro 请求算哪边,价目页 没有说。
「名字不变、模型变」我们两周前在 Cursor 那篇 写过一次,那次是合同一方收回模型;这次是厂商替换模型,名字照旧、账单更便宜、对方还认为 是在帮你。两次的结论一样:你按名字拿到的模型,稳定性等于厂商 alias 表的稳定性。
对照一下现在官方文档首页给的调用示例,注意模型名已经是 deepseek-flash,
思考模式默认开、reasoning_effort 可选 low / high / max
(官方文档 — 首次调用 API):
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-flash",
        "messages": [
          {"role": "system", "content": "You are a helpful assistant."},
          {"role": "user", "content": "Hello!"}
        ],
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
        "stream": false
      }'
如果你的代码里写的是 deepseek-v4-pro,14 日之后它返回的就是这段示例返回的东西,只是
你不知道。
「全面超越 V4 Pro」怎么读:厂商自评的三张表,外加一张被换过的图
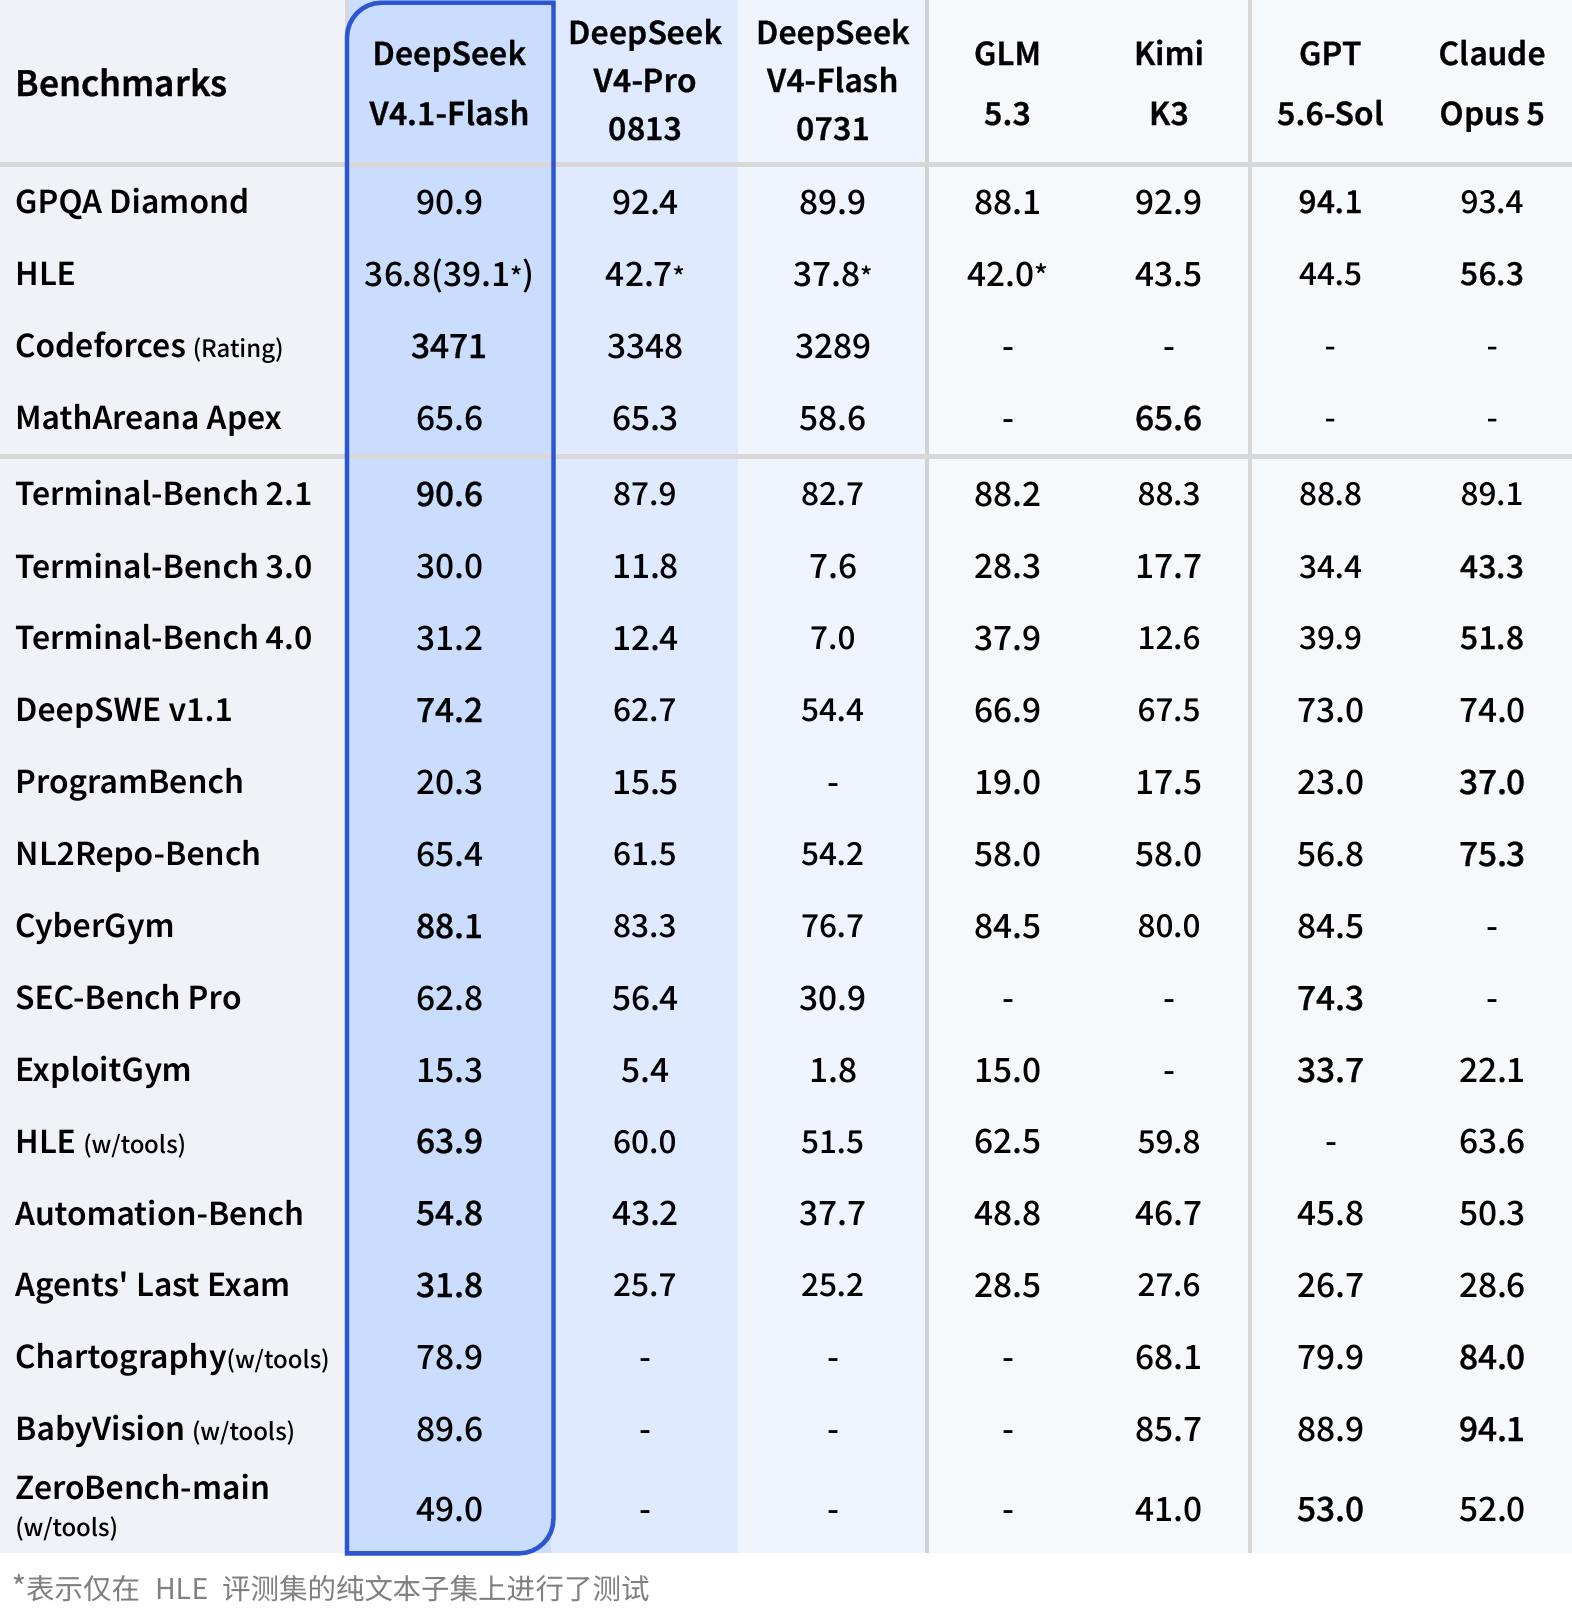
价目页脚注 (2) 用一句话给改道背书:「经多方测试,V4.1 Flash 在性能、费用、速度、总用时等 各项指标上已全面超越 V4 Pro」。证据是 DeepSeek 自己的 模型卡,三张表,全部厂商自评。 公平地说,它把输的行也原样印了出来。
第一张,instruct 模型对比,最大推理强度。 Agentic 类 12 项两个模型都有分的行, V4.1 Flash 全赢:Terminal-Bench 2.1 90.6 对 87.9、DeepSWE v1.1 74.2 对 62.7、 Automation-Bench 54.8 对 43.2、CyberGym 88.1 对 83.3。推理类 4 项是 2 胜 2 负:Codeforces 3471 对 3348、MathArena Apex 65.6 对 65.3(只差 0.3,实务上按持平读——模型卡那条「0.3 以内 视为等同」是给基础模型表定的,这里不套用);GPQA Diamond 90.9 对 92.4、HLE 纯文本子集 39.1 对 42.7,输给 Pro。
第二张,基础模型对比。 16 项,V4 Pro 赢 12 项,没有一项落在 0.3 以内:
| 基准(基础模型) | V4-Pro-Base | V4.1-Flash-Base | 差 |
|---|---|---|---|
| SimpleQA-Verified | 55.2 | 42.3 | −12.9 |
| LongBench-V2 | 51.5 | 45.2 | −6.3 |
| MultiLoKo | 50.9 | 45.5 | −5.4 |
| MGSM | 84.4 | 80.2 | −4.2 |
| MATH | 64.5 | 61.1 | −3.4 |
| BBEH | 29.8 | 27.2 | −2.6 |
| AGIEval · C-Eval · SuperGPQA · BBH · DROP · HellaSwag | −0.8 到 −1.4 |
V4.1 Flash 赢的四行是 MMLU-Pro、BigCodeBench、HumanEval、GSM8K。552B 骨干对 1.6T,这个
分布不奇怪,模型卡也没装作不是这样。但「全面」两个字在这张表上撑不住:事实检索、长文档
问答、多语言知识,恰好是生产里最常见的三类负载,也恰好是 14 日之后 deepseek-v4-pro
这个名字会变差的三类。
第三张,同一个模型换八套 harness。 模型卡的 scaffold 表把同一个 V4.1 Flash checkpoint 跑了八种 agent 框架:DeepSWE v1.1 从 65.5(OpenCode)到 74.2(mini-SWE),相差 8.7 分; Terminal-Bench 2.1 从 84.1(Codex)到 90.6(DeepSeek Harness Minimal 模式)。Flash 对 Pro 在 DeepSWE 上的优势是 11.5 分,换一套 harness 就能吃掉四分之三。你的回归结论只在你自己的 harness 上成立,这不是保守,是那张表说的。
外加一张被换过的图。 中文公告页那张 19 项基准表配图,我们在发布当日存了一份。
9 月 11 日上午复查,服务器返回的已经是另一个文件(HTTP Last-Modified 头
2026-09-11 02:23:58 GMT),八个格子的数变了:
| 格 | 发布当日的中文配图 | 9 月 11 日替换后的中文配图 = 英文配图 = 模型卡 |
|---|---|---|
| Codeforces:V4.1 Flash / V4 Pro / V4 Flash | 3921 / 3850 / 3840 | 3471 / 3348 / 3289 |
| CyberGym:V4.1 Flash | 未给出 | 88.1 |
| SEC-Bench Pro:V4 Pro / V4 Flash | 未给出 / 39.8 | 56.4 / 30.9 |
| ExploitGym:V4 Pro / V4 Flash | 未给出 / 2.65 | 5.4 / 1.8 |
英文页的同一张图从 9 月 10 日 07:25 GMT 起没有动过,一直是右边这一列。哪一版是对的, 我们不知道;Codeforces 差 450 分不是手滑,更像两次不同的跑分。能确认的只有:同一张官方表 在两个语言页上有过两个版本,替换没有留任何说明。另外还有一格三份官方材料没对齐: NL2Repo-Bench 在两版配图和更新日志里都是 65.4,在模型卡 README 里是 64.0。数字不大,但说明这些表是手工拼的。
最后一条:截至 9 月 10 日,Artificial Analysis 还没有发布 V4.1 Flash 的测量 (OrcaRouter — DeepSeek V4.1: A New Base Model 记录了这一点)。一个 1.6T 模型的退役,目前由退役方自己的表背书。这很正常,也正是你要自己 跑回归的原因,而不是从任何一张图上抄数字进选型文档——那张图可能明天就换了。
参数到底多少:484.6B、552B、748B、763B 都对,只是数的不一样
第三件事是模型本身,连它多大都有四个版本。
552B 是官方标题数,指 MoE 骨干。模型卡 同一句话里还有一个 196B 的 Engram 条件记忆模块,大多数转述把它丢了。 r/LocalLLaMA 上一位用户直接打开 safetensors 数了一遍 (Deepseek V4.1 Flash is 748B, not 552B): 主干 551.566B,Engram 196.929B,DSpark 投机解码头 14.225B,视觉编码器 0.485B。 主干加 Engram 就是帖题里的 748B;全加起来约 763B。我们 9 月 11 日读 Hugging Face API 返回的 safetensors 元数据,总数 763,205,315,794,其中 I8 557.17B、F8_E4M3 204.02B、 BF16 1.98B、F32 0.04B,和这位用户的拆解对得上。
484.6B 是发布当天 Hugging Face 页面参数计数器显示的数,Reddit 那帖和 Progressive Robot 的拆解 都记录了它。原因是路由专家权重按 4 bit 存、两个权重一个字节,计数器把 278.6B 个字节当成了 278.6B 个参数;乘二得 557.2B,正是 vLLM 部署配方里列的专家参数总数。到我们复查时,计数器 已经改读 763B。所以四个数说的是四件事:552B 是骨干,484.6B 是计数方式的伪影,748B 是骨干加 记忆,763B 是文件。
这些数字对「Flash」这个词做了什么,是 HN 那条 668 分讨论 (采集时读数)的顶评:「the original v4 flash was 284B… This one is 552B so almost twice that… it’s not really flash anymore, imo.」它下面的回复是另一半:「It uses fewer active parameters, though… So… flash indeed.」两人说的是两个轴。按每 token 激活量,V4.1 Flash 的 8B / 16B 比 V4 Flash 的 13B 更「Flash」;按能不能放进你自己的机器,不是——vLLM 配方列的 checkpoint 约 511 GB,最低要求 614 GB 加速器内存(Progressive Robot 转述);同一条 HN 线里 有人估 V4 Flash 的 FP4 权重约 160 GB,两台 Spark 或 Strix Halo 就能跑,这次至少四台 (HN 评论者的估算,非官方数)。MIT 许可,权重开放,但托管是 另一个问题。
对采购的含义一句话:「Flash」现在只告诉你价格档和激活量,不再告诉你参数量,也不告诉你 部署门槛。 两周前 Ox Alpha 揭牌那篇说「Flash 档」 是一个每两周洗一次牌的价格段位,这次 DeepSeek 用一个 763B 的文件把这句话又证明了一遍。 用名字猜成本档位的习惯,可以改了。
14 日前做两件事
更新(2026-09-28):改道已撤回,本节不再是必须做的事;把依赖的模型名写进依赖清单、订阅更新日志,仍然值得做。
四天够用,如果今天开始。先按你代码里写的名字对号:
| 你的请求写的是 | 9 月 14 日会发生什么 | 这周做什么 |
|---|---|---|
deepseek-flash | 不变,已经是 V4.1 Flash、已经是新价 | 成本模型换成 9·10 表,输出那一档别按「降价 60%」估 |
deepseek-v4-flash / deepseek-v4-flash-vision-exp | 9 月 10 日已经换了,名字还能用,模型已下线 | 改名 deepseek-flash 显式接受;回归已经欠了一天 |
deepseek-v4-pro | 模型换成 V4.1 Flash、账单降到 Flash 价、无退出 | 现在存 Pro 基线;决定你要的是这个名字还是 Pro 这一档 |
第一件事,回归,而且是用你自己的 harness。 14 日中午之后,官方 API 上就没有地方跑
V4 Pro 了,基线只能在这之前存。存什么:一段有代表性的生产流量切片——prompt、工具定义、
采样参数、harness 版本、被接受的输出,带时间戳。然后现在就用 deepseek-flash 重放同一
切片,不要等 14 日。重点看三类:事实性问答、长文档抽取、非英语流量,因为厂商自己的基础
模型表说这三类往反方向动了。同时看输出 token 长度,账单的 2 倍在这一档;再看拒答与格式。
这次回归本身的账:1,000 条 × 20K 输入 + 2K 输出,Pro 空闲时段约 117 元(20M 未命中 × 4.5
- 2M 输出 × 13.5),Flash 侧约 28 元。别嫌 Pro 那边贵,这是最后一次能按这个价拿到这个模型。
第二件事,找出所有写死的模型名。 代码只是一半,网关配置、路由表、alias 映射、CI 变量、 prompt 模板里的模型名才是漏网的地方:
rg -n 'deepseek-v4-pro|deepseek-v4-flash(-vision-exp)?' \
  --glob '!node_modules' \
  --glob '*.{py,ts,js,go,rs,yaml,yml,json,toml,env,conf}'
找到的每一处二选一:改成 deepseek-flash,显式接受这次替换;或者在旁边注一行
「14 日后实际是 V4.1 Flash」,等回归结果决定去留。两者都不做,等于让厂商替你做了决定,
而且你的监控看不出来——请求成功、延迟更低、账单更便宜,所有指标都在变好。
结构上的修法是每次 DeepSeek 调价都在指的同一件事:模型名收口到一处配置,其余地方引用 那个键。名字是厂商控制的 alias,你真正想要的是一个能力档加一张价目表,那个决定该放在 能同时看到价目表版本和模型版本的层里,而不是散在每个调用点的字符串里。这一步的成本是 一次重构加一轮回归,收益是下次脚注再改的时候你只改一行。
价格表退回去了两档,模型名没退回去。14 日中午之后,deepseek-v4-pro 只是一个还能被
调用的字符串。