
GLM-5.3-FlashX、Claude 快速模式、Grok 4.7 Fast、OpenAI Fast mode 各贵多少?同样 2 倍起,输出越重越划算
GLM-5.3-FlashX 是 GLM-5.3-Flash 的 2.5 倍价,Claude Opus 5.5 快速模式、Grok 4.7 Fast、OpenAI Fast mode 都是标准价的 2 倍。加价乘在整张账单上,提速主要落在输出那一截,所以同一个模型,输入越重、输出越短,每省一秒越贵。本文给出四家价目、各自快在哪、容量不够时会怎样,以及一条能直接套自己数据的判据:什么时候加钱,什么时候去 Batch。
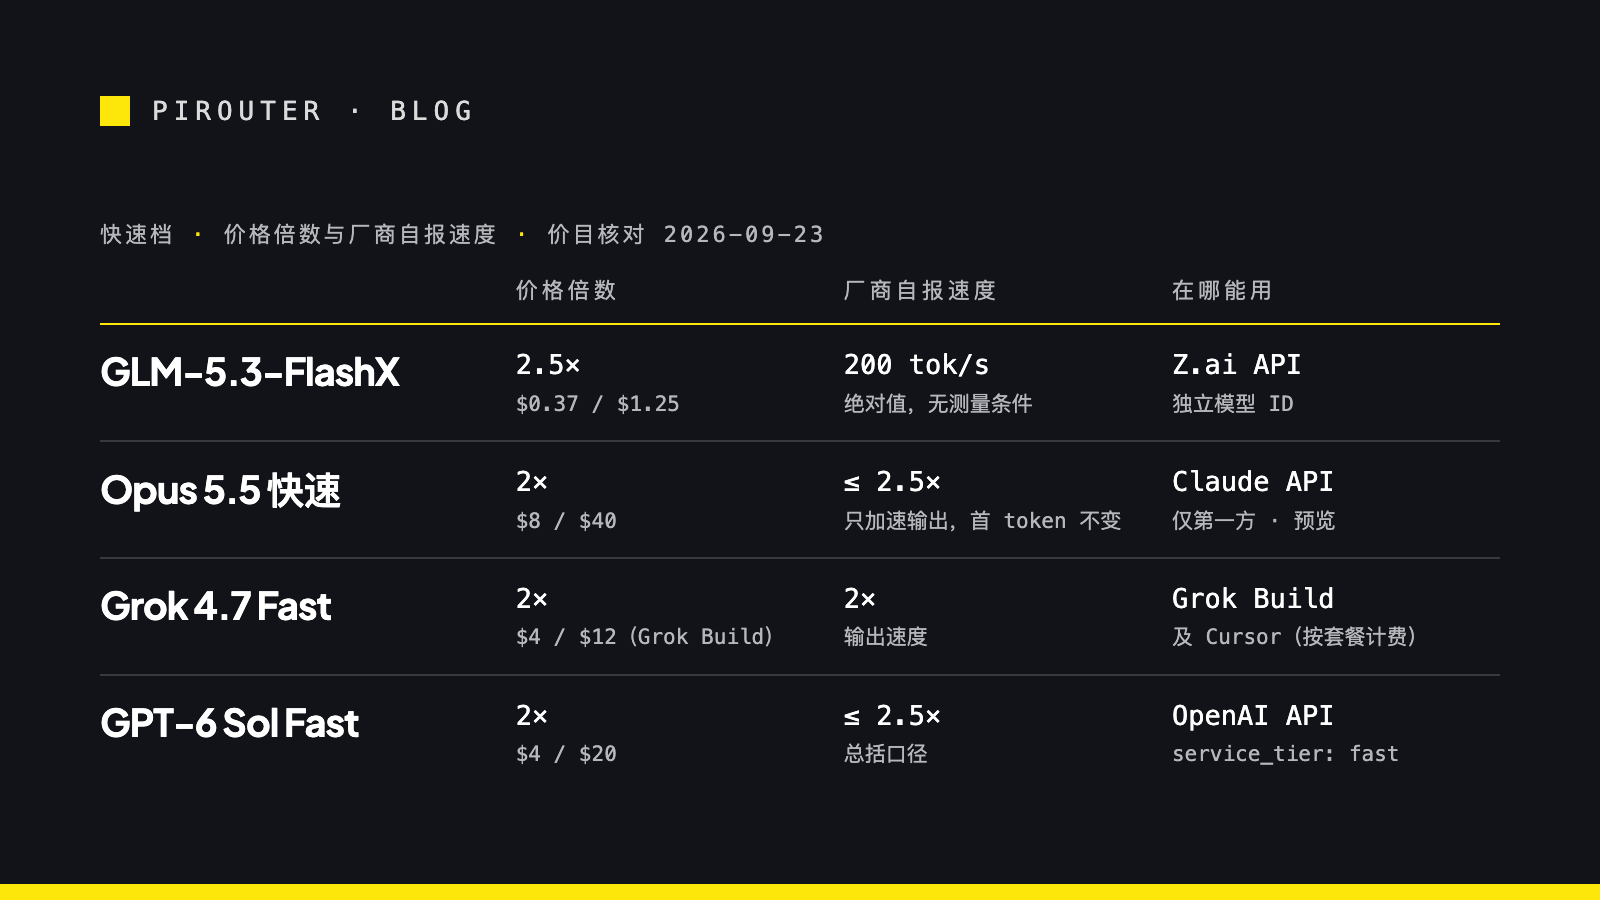
先给数。GLM-5.3-FlashX 的价格是 GLM-5.3-Flash 的 2.5 倍:每百万 token 输入 $0.37、输出 $1.25, 对 $0.15、$0.50(Z.ai Pricing)。Claude Opus 5.5 快速模式、 Grok 4.7 Fast、OpenAI Fast mode 都是标准价的 2 倍。值不值,先看请求形态,再看哪家:加价乘在整张账单上, 提速主要落在输出那一截。同一个 Opus 5.5,输入重的请求每省一小时等待约 $36,输出重的约 $6.6 (按 2 万输入/800 输出与 2 千输入/4 千输出两种请求、标准档 50 tok/s 的假设、取厂商自报上限推算)。
先交代口径:价目核对于 2026-09-23;文中速度数字要么是厂商自报,要么是第三方平台随时变化的实时读数, 没有一个是我们测的。按小时折算是我方用公开价目做的算术,假设写在算式旁边。
五天三家:四个快速档的价目摆在一张表上
9 月 18 日 GLM-5.3-FlashX 上线(据 OpenRouter 上架日), 9 月 21 日 xAI 发 Grok 4.7 并附一个 Fast 变体,9 月 22 日 Claude Opus 5.5 发布、快速模式同日可用。 OpenAI 不在这一周:它的 Fast mode 是 7 月 30 日由 Priority processing 改名来的。
| 模型 | 标准档 输入/输出 | 快速档 输入/输出 | 倍数 | 厂商自报速度 | 怎么开 |
|---|---|---|---|---|---|
| GLM-5.3-Flash → FlashX | $0.15 / $0.50 | $0.37 / $1.25 | 2.5× | 200 tok/s | 换模型 ID glm-5.3-flashx |
| Claude Opus 5.5 | $4 / $20 | $8 / $40 | 2× | 输出最多快 2.5 倍 | speed: "fast" + beta header,需申请开通 |
| Grok 4.7 Fast(Grok Build 标价,提示低于 200k) | $2 / $6 | $4 / $12 | 2× | 输出快 2 倍 | 仅 Cursor 与 Grok Build;Cursor 按其套餐计费 |
| GPT-6 Sol | $2 / $10 | $4 / $20 | 2× | 最多快 2.5 倍(总括口径,点名的模型为 gpt-5.6-sol) | service_tier: "fast" |
单位是美元每百万 token。出处:Z.ai Pricing、
GLM-5.3-Flash/FlashX 模型页、
Claude Fast mode、
Claude Pricing:Fast mode pricing、
Introducing Grok 4.7、xAI Pricing、
OpenAI Pricing、OpenAI Fast mode。
Z.ai 原文写的是「200 tokens/s」,本文统一记作 tok/s。service_tier 是 OpenAI 与 xAI 请求里选处理档位的参数。
「2 倍」好记,但表外有三处不整齐:
- FlashX 的 2.5 倍是四舍五入的。输出、缓存命中都是整 2.5 倍,输入 $0.37 对 $0.15 是 2.47 倍。 人民币的输入、输出都是整 2.5 倍:FlashX 输入 2 元、输出 7 元,Flash 是 0.8 元、2.8 元 (智谱 API 定价)。
- Grok 4.7 Fast 过了 200k 提示 token 不是 2 倍。xAI 价目页给 Fast 长上下文档标 $6/$1.50/$18, 标准长上下文档是 $4/$1/$12,即 1.5 倍;同一页的说明文字却写「twice the standard token rates」。 以哪个为准页面没写,用 Grok Build 的先看实际账单。xAI 的公开 API 买不到 Fast,同价位能买的是 Priority Processing(2 倍,调度优先,下一节讲)。
- OpenAI 当前主力模型大多是 2 倍,gpt-5.5 例外:Fast $12.50/$75 对标准 $5/$30,2.5 倍; gpt-4.1、gpt-4o 这类老模型约 1.7 倍。按模型查表,别按厂商记一个倍数。
同样是 2 倍价,买到的「快」不是一回事
四家都叫「快」,底下是三种东西:两种提速,一种插队。
只加速输出。 Anthropic 说快速模式是「the same model with a faster inference configuration」, 提速集中在每秒输出 token 数(OTPS),不在首 token 时间(TTFT,从发出请求到收到第一个 token 的时间) (Claude Fast mode:How fast mode works)。 等首 token 的那几秒一分没少,钱照样翻倍。
换更快的机器。 xAI 对 Grok 4.7 Fast 的描述是「the same Grok 4.7 model served on faster infrastructure」; Z.ai 把 Flash 与 FlashX 放在同一个模型页里介绍,FlashX 单独一个模型 ID,中文页说是 「持续加大 Infra 投入与推理优化」(智谱 GLM-5.3-Flash/FlashX)。
插队。 xAI API 上的 Priority Processing(service_tier: "priority")文档写的是「higher scheduling priority」,
改善的是 TTFT 与 token 间延迟,高峰期尤甚(xAI Priority Processing)。
OpenAI 的 Fast mode 原名就是 Priority processing,改名时把 gpt-5.6-sol 提到「up to 2.5× faster than Standard」,
现在是插队加提速的混合体。
那几个「最多」都没有测量条件。FlashX 到底快几倍,取决于分母。 报道里流传「快五到六倍」 (如 BigGo 财经的发布报道,基数写的是此前 30–50 tok/s), Z.ai 官方页面上找不到这个倍数。第三方读数有两个:OpenRouter 上 Z.ai 那一行的 Flash 吞吐中位数(P50)是 40 tok/s (OpenRouter:GLM 5.3 Flash),按它算 200 是 5 倍; Artificial Analysis 测 Z.ai 一方 API 是 107 tok/s(Artificial Analysis:GLM-5.3-Flash), 按它算不到 2 倍。两者都是 9 月 23 日采集的实时读数,负载也不同。下一节两个都算。
另一个选项只有开源模型才有:GLM-5.3-Flash 权重是 MIT 许可,Artificial Analysis 同日列出的 18 家托管方里, 排前五的在约 170 到 450 tok/s 之间(AA:GLM-5.3-Flash providers)。
省一小时等待要花多少钱:用同一把尺子算四家
价格倍数和速度倍数各说各的,得换成一个量才能比。我用小时做单位,因为最后要拿它和等待者的时薪比:
加价 = (价格倍数 − 1) × 这次请求的标准档原价
省时 = 输出 token ÷ 标准档速度 × (1 − 1 ÷ 速度倍数)
每小时价钱 = 加价 ÷ 省时 × 3600
倍数是 2 时,加价就等于原价。四家快速档的缓存价也按同一倍数上浮,所以这条对整张账单成立。
手算一遍 Opus 5.5 的输入重请求(2 万输入、800 输出):原价 = 2 万 × $4/百万 + 800 × $20/百万 = $0.08 + $0.016 = $0.096, 加价也是 $0.096;标准档 800 ÷ 50 = 16 秒,快速档按 2.5 倍是 6.4 秒,省 9.6 秒;$0.096 ÷ 9.6 × 3600 = $36。
两种形态:A 输入重,2 万输入、800 输出(带一大段上下文问一个短问题);B 输出重,2 千输入、4 千输出(写一个完整文件)。 800 输出含思考 token。Opus 5.5 的思考无法关闭 (What’s new in Claude Opus 5.5), 实际输出通常更多,A 的每小时价钱会往下走。
| 模型 | A 加价 / 省时 | A 每小时 | B 加价 / 省时 | B 每小时 |
|---|---|---|---|---|
| Claude Opus 5.5(2.5×) | $0.096 / 9.6 秒 | $36.0 | $0.088 / 48 秒 | $6.6 |
| GPT-6 Sol(2.5×,总括口径;默认缓存写入) | $0.058 / 9.6 秒 | $21.8 | $0.045 / 48 秒 | $3.4 |
| Grok 4.7 Fast(2×,API 不可购,仅作参照) | $0.045 / 8 秒 | $20.2 | $0.028 / 40 秒 | $2.5 |
| GLM-5.3-FlashX(基数 40 tok/s) | $0.005 / 16 秒 | $1.1 | $0.0034 / 80 秒 | $0.15 |
| GLM-5.3-FlashX(基数 107 tok/s) | $0.005 / 3.5 秒 | $5.2 | $0.0034 / 17.4 秒 | $0.71 |
GLM 两行的标准档速度是第三方实时读数;其余三家标准档速度没公开,用的是 50 tok/s 假设,这不是任何一家的读数。 GPT-6 Sol 一行按 OpenAI 的默认缓存口径算:GPT-5.6 及以后默认开启缓存,1,024 token 以上的提示首次请求按 1.25 倍输入价写入缓存,快速档的写入价同样翻倍(OpenAI Prompt caching)。改用 explicit 模式且不放缓存断点时不写入,这一行变成 $18.0 与 $3.3。
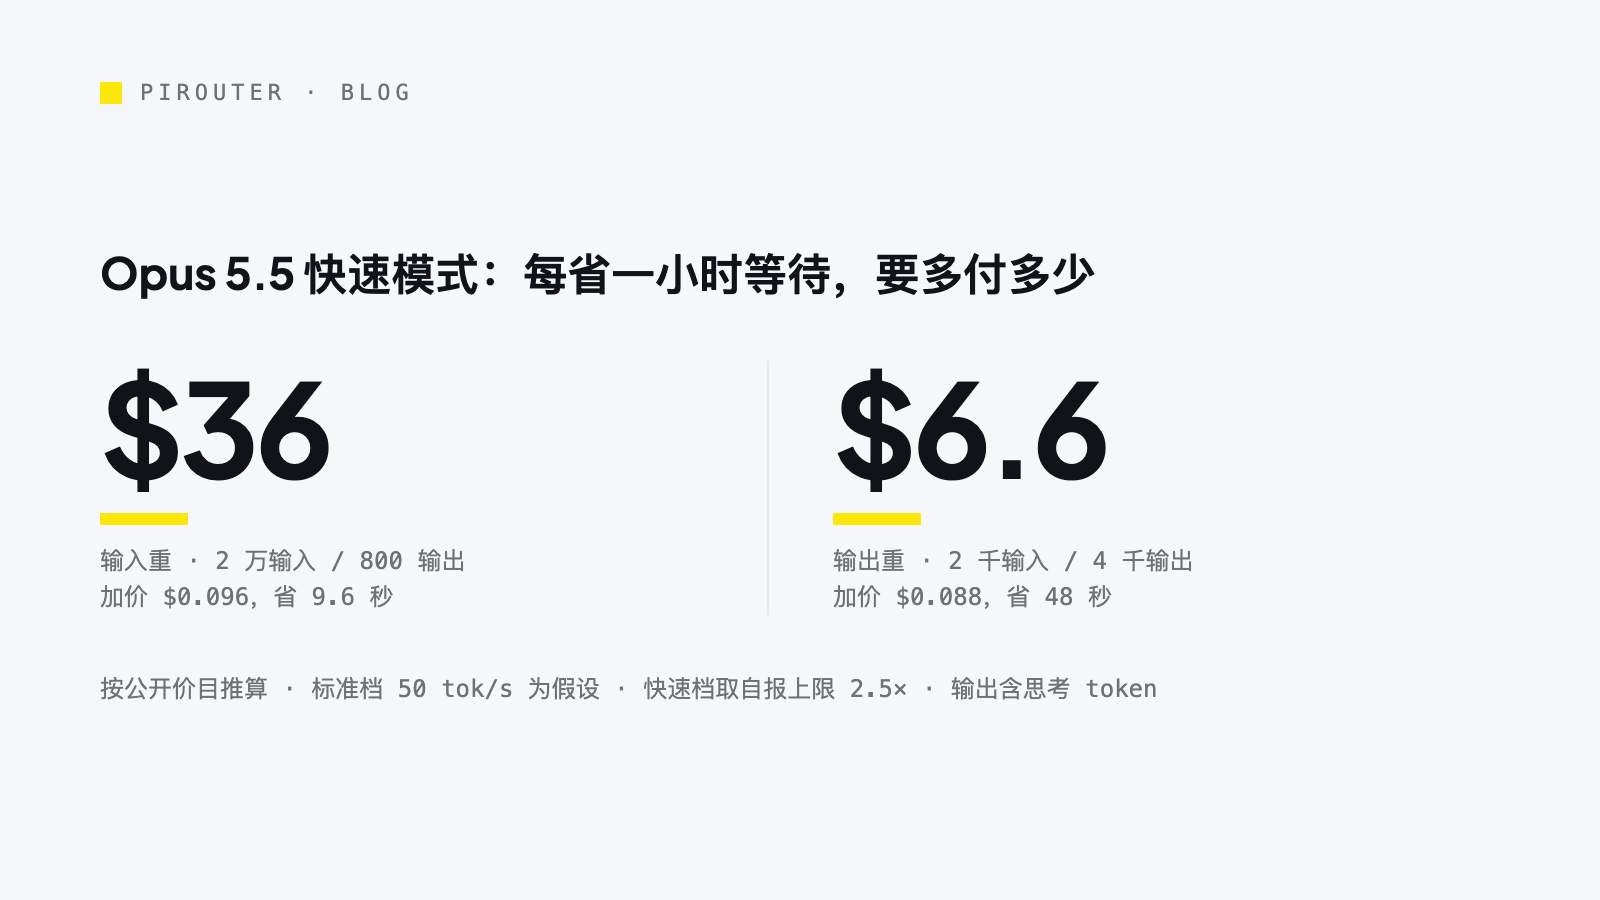
先横着看同一行:同一家内部,A 比 B 贵 5 到 8 倍。A 的账单八成以上是输入 token,你为 2 万个输入付了双倍, 它们一个也没被加速。再竖着看同一列:跨厂商这一列不可比,各家标准档速度未知、倍数口径也不同 (「最多 2.5 倍」对「2 倍」),换一个假设排名就会变。
一般规律是:每小时价钱正比于「整单原价 ÷ 输出 token」。展开成能直接套的式子(推导见文末):
每小时价钱 ≈ 系数 × (标准输出单价 + 标准输入单价 × 输入/输出比)
系数 = 3600 × 标准档速度 × (价格倍数 − 1) ÷ (1 − 1 ÷ 速度倍数) ÷ 100 万
单价按每百万 token 的美元数代入。50 tok/s 下 Opus 5.5 与 GPT-6 Sol 的系数是 0.3,Grok 4.7 Fast 是 0.36;GPT-6 Sol 默认口径下输入单价按写入价 $2.50 代入。 所以 Opus 5.5 约为 $6 + $1.2 × 输入/输出比:比值 25(A)得 $36,0.5(B)得 $6.6。 反过来用(Opus 5.5):团队时薪按 $50 算,比值低于约 37 就值得;按 $20 算,门槛降到约 12。
三个会改变结论的变量:
- 标准档实际速度。是 100 tok/s 而不是 50,系数翻倍,每小时价钱也翻倍。
- 缓存命中率。命中部分按缓存单价代入输入单价。A 里 2 万输入全部命中时,Opus 5.5 缓存读取 $0.20/百万 (Claude Pricing),原价从 $0.096 降到 $0.020, 每小时价钱从 $36 降到约 $7.5。先做好缓存,再买速度。
- 这把尺子只计输出省下的时间。Priority 与 OpenAI Fast 还改善 TTFT 与延迟稳定性,A 形态下对这两家会被低估。
什么时候值得加钱,什么时候该去 Batch
判断规则就是把「每小时价钱」和「等的那个人的时薪」放在一起比。分三档:
值得加钱:
- 思考 token 多。Opus 5.5 的思考关不掉,而思考都在输出侧一个个生成,输出提速对它最有效。
- 必须等整段产出才能用:整文件 apply、tool call 的参数、agent 里前一步不完后一步不开的串行链路。 这类等待是纯阻塞,B 形态每小时几美元。流式展示给人读的回答不算:50 tok/s 已经比人读得快。
看时薪与缓存命中率:
- 输入重、输出短,比如 agent 循环里的每一轮。人确实在同步等,但 Claude 的 TTFT 不变,预填充 (模型读完输入的阶段)照等。先按上面的式子代入你的缓存命中率算一遍:命中高的,可能落到每小时个位数美元。
明确不值得:
- 没人在等。夜间批量、评测跑分、离线数据处理,快速档是纯成本。xAI 的 Priority 文档自己也写了, 后台任务、评测、批量处理更适合 Batch API(异步提交、稍后取回结果的批处理接口)。
反方向的档位同样存在。OpenAI 的 Batch 与 Flex 都是标准价的一半;Anthropic Batch API 也是五折,但快速模式 不能与 Batch 叠加(Claude Pricing:Fast mode pricing)。 所以同一个模型,从最慢档到最快档,新模型上是 4 倍价差(gpt-5.5 是 5 倍),模型名一个字没变。 Astra 与 Fable 5.1 那篇账单对比里见过一次:OpenRouter 上 Astra 的 Flex 档 P50 延迟约 6.88 秒、Fast 档约 2.04 秒(9 月 5 日读数),价差 4 倍。另外两家:grok-4.7 模型页写着 Batch API 「Not supported」(xAI:Grok 4.7);智谱对支持 Batch 的模型打五折, GLM-5.3-Flash 在不在列我没核到原文,不下结论。
把速度档当路由维度:四家失败时的行为不一样
价目表只回答成功时付多少。上生产要问的是:快速档容量不够时,请求会怎样。
| 模型 | 容量不够时(✗ 报错 · ⚠ 静默或未说明) | 怎么核对实际档位 |
|---|---|---|
| Claude Opus 5.5 快速模式 | 返回 429(限流)或 529(过载),不自动降级 | 响应 usage.speed 为 fast 或 standard |
| OpenAI Fast mode | 流量爬坡过快时部分请求被降到标准速度,按标准价计 | 降级时 service_tier 为 default;GPT-5.6 及更早模型成功时返回 priority,不是 fast |
| xAI Priority Processing | 可能按默认档处理,只在确认 priority 时按 2 倍计价 | 响应 service_tier |
| GLM-5.3-FlashX | 文档未描述降级行为 | 文档未写核对方式 |
出处:Claude Fast mode:Checking which speed was used、 OpenAI Fast mode:Rate limits and ramp rate、 xAI Priority Processing。
Claude 最透明也最费事:不替你决定,直接报错,降级链你自己写。OpenAI 对账单友好、对延迟预算不友好: 你以为买了快,拿到的是标准速度,只是没多收钱。它给的经验值是流量到每分钟 100 万输入 token 后, 每 15 分钟增幅不超过 50%;并写明 GPT-6 Astra 的 Fast mode 不带延迟 SLA。
可用面上的限制,比价格更早卡住你:
- Claude 快速模式只在第一方 Claude API,Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry 都没有; 目前是 research preview(研究预览,需找客户经理或排 waitlist 开通)。
- Grok 4.7 Fast 只在 Cursor 与 Grok Build,公开 API 没有(xAI Release Notes:Grok 4.7), Grok Build 免费档也不含。
- FlashX 暂未进 GLM Coding Plan,订阅用户要按 token 另付。
还有时间维度:快速档是按模型开的,会随模型下线而关掉。 Opus 4.6 与 4.7 的快速模式都已移除,
4.7 上请求 speed: "fast" 直接报错,4.6 上静默按标准速度、标准价跑
(Claude Release notes)。
路由表把「fast」写成账户级开关而不是模型级属性,下次模型退役时会以两种方式坏掉。
我的路由规则,代价写在旁边:
- 用式子分档,不用默认值。对每类请求取「输入/输出比」与缓存命中率,代入上面的式子,低于团队时薪的走快速档。 代价是多一个请求分类维度,外加定期用实测速度校准系数。
- 每条响应记下实际档位(
usage.speed/service_tier/ model),月底按实际档位对账。 代价是日志多一列,但这是发现「以为走了 fast、实际跑在 standard」的唯一办法。 - 报错型(Claude)写死降级链:fast 报 429/529 → 同模型标准档 → 换模型,别让 SDK 默认重试替你决定。
- 静默型(OpenAI、xAI)盯回落比例:监控
service_tier回落到 default 的比例,按 ramp 规则爬坡。 代价是每家一套错误码与字段映射。
速度档卖的是时间。买之前算清楚是谁的时间:人在等就算一算,机器在等就去 Batch。 GLM-5.3-Flash 8 月下旬先以匿名测试模型 Ox Alpha 上线、8 月 26 日揭牌,它的定价与促销我们在 Ox Alpha 就是 GLM-5.3-Flash 里记过;这一次不是促销到期, 是同一个模型单独挂了一个更贵的价签,卖的只有速度。
附:系数推导。 设输入 I、输出 O、标准档速度 S、速度倍数 k、价格倍数 m、标准单价 p入、p出(每 token)。 加价 = (m − 1)(I·p入 + O·p出),省时 = O/S × (1 − 1/k)。相除乘 3600,O 约掉: 每小时价钱 = 3600·S·(m − 1)/(1 − 1/k) × (p出 + p入·I/O)。Opus 5.5:3600 × 50 × 1 ÷ 0.6 = 30 万, 乘每百万单价即 0.3。GLM 用绝对速度,省时换成 O × (1/S − 1/200),基数 40 时系数 0.18。