DeepSeek Search/Fetch将结束指定宿主免费期,一次查资料要算几笔钱
北京时间11月1日00:00起,指定宿主经DeepSeek API进行的服务端Search/Fetch工具调用开始计费。两者各按每千次成功请求0.75美元收费;本文拆清免费期范围、空结果规则和一次查资料背后的多笔工具费。
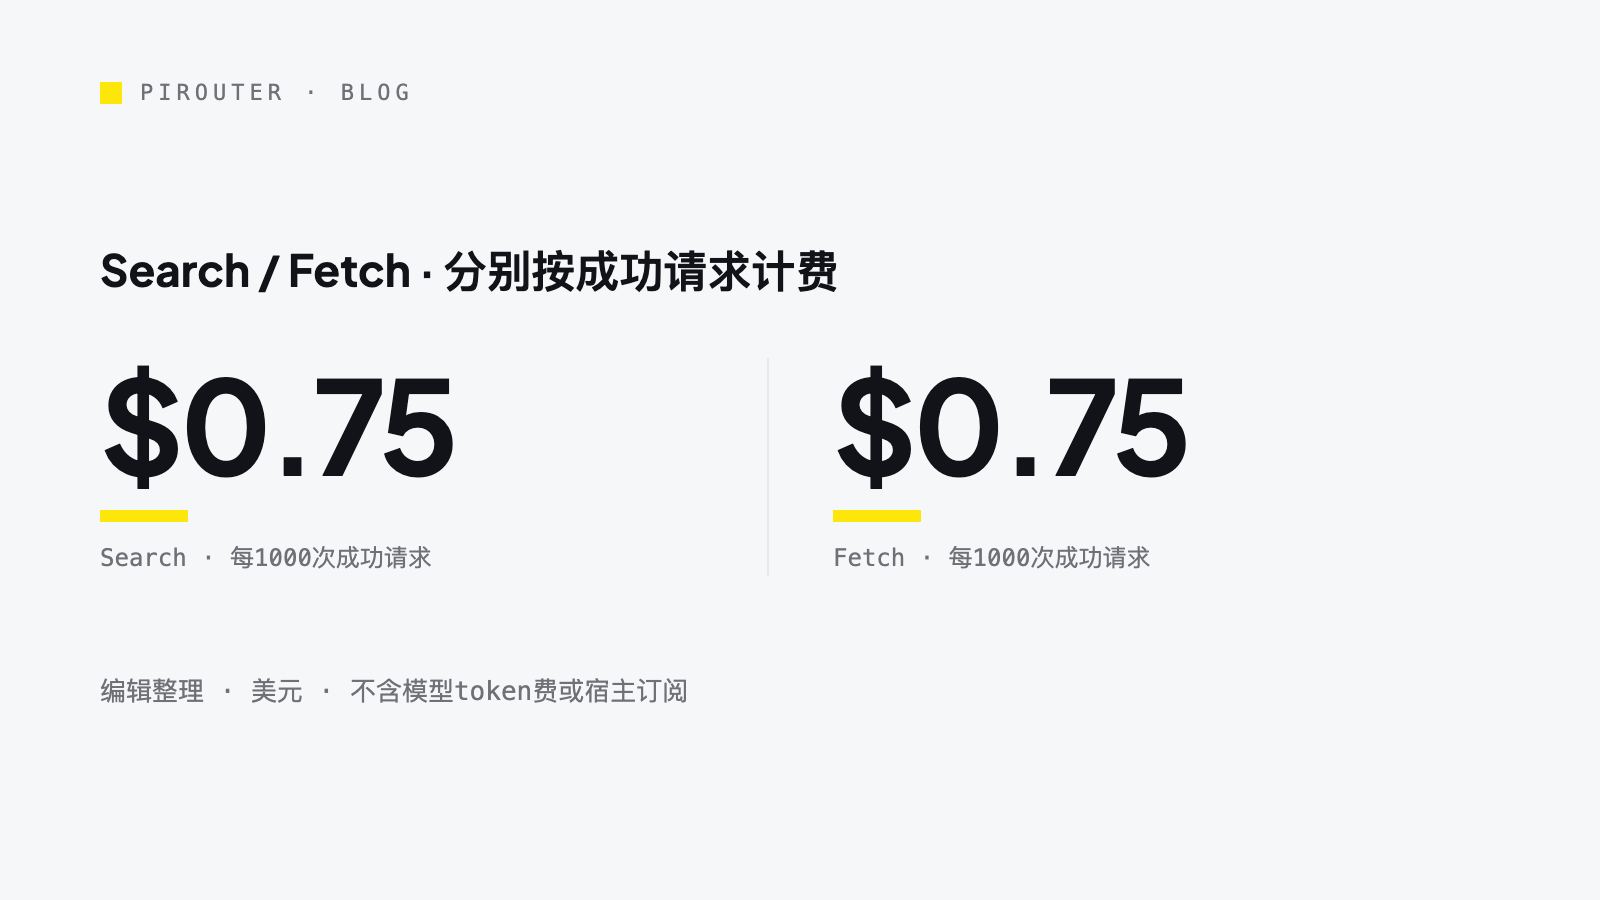
北京时间2026年11月1日00:00起,通过DeepSeek Harness、Claude Code或Codex访问DeepSeek API时产生的服务端Search/Fetch工具调用,将结束免费期。Search和Fetch各按每千次成功请求0.75美元计价,失败、空搜索结果和超时不收该工具请求费。需要重新预算的是这段工具调用链,不是把所有DeepSeek接口都理解成“11月以前免费”,也不是用户问一次只付一笔钱。
截至10月28日,官方Search & Fetch指南仍给出上述条款。本文依据文档说明计费范围,算例均为明确假设下的预算推算,没有实际调用检索、测试搜索质量或核验真实账单。
11月1日开始收费的,是哪一段调用
假设你在编码工具里让Agent查一份刚更新的接口资料。界面上只是一句请求,背后却可能先搜索网页,再打开几条结果,最后把正文交给模型整理。模型生成答案有模型的账,搜索和抓取也各有自己的请求计数。
这次免费期的范围,藏在官方Billing段落的补充说明里:通过DeepSeek Harness、Claude Code或Codex使用DeepSeek API时,服务端工具调用已经会访问Search和Fetch API;这些调用当前免费,11月1日北京时间00:00开始按请求计费。
这里的条件必须一起读。这些客户端或运行工具,就是本文所说的“宿主”。不是只要打开它们,里面所有联网功能就统一适用DeepSeek的价目;也不是换用其他模型提供商后,工具费仍自动按这条规定走。要确认的是请求是否实际经DeepSeek API,并使用了其服务端搜索或抓取工具。
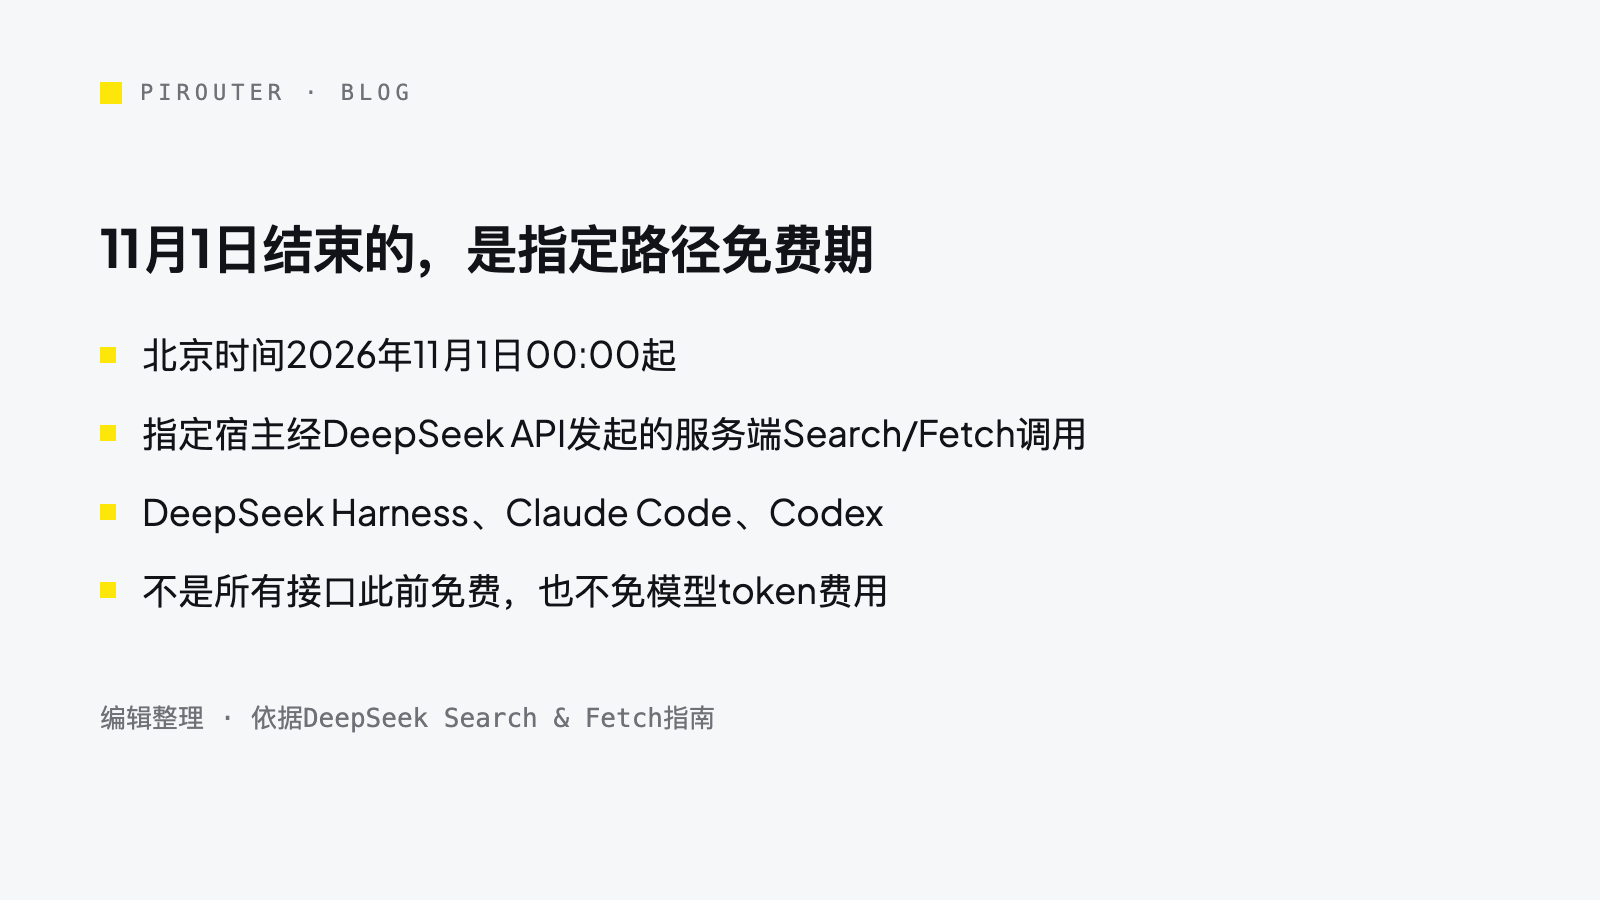
直接调用Search/Fetch端点的开发者,则应看各自公开的成功请求价格,不能把针对上述服务端调用的免费说明,扩成“所有Search/Fetch请求在11月前都免费”。同样,这段说明没有免除模型token费用,也没有承诺宿主订阅免费。
这并非10月28日才宣布的新服务。GIGAZINE的10月19日报道已介绍两类接口和宿主服务端调用的免费期。现在重新看它的价值,在于计费时点快到了:此前没有单列的工具请求,需要进入预算,而不是继续藏在一句“Agent帮我查一下”里面。
Search找页面,Fetch取正文,两笔请求不是一件事
Search负责根据查询找网页,返回标题、URL、摘要等结构化结果;Fetch接受一个网页URL,把该页面内容取成Markdown。两者是独立的JSON API,不是一次搜索请求里默认打包的两个免费步骤。
Search的count决定希望返回多少条结果,范围是1到50,不改变单次请求的价格。一条成功Search返回五条匹配,仍是一条Search请求,不会因为出现五个URL就按五次搜索计价。
但如果工作流随后选中其中三个URL,分别调用Fetch取得正文,这就是三条独立的抓取请求。它们如果都符合成功条件,就分别产生Fetch费用。一次用户任务,不等于一次Search,更不等于Search和所有后续Fetch合起来只算一次。
还有一个容易影响设计的参数:Search的need_content默认是false,此时条目里的content为空;设为true可以请求页面正文,但内容不可用时这个字段仍可能为空。返回列表有结果,与每条结果都带完整正文,是两个条件。
Search的返回字段也为这种分工提供了线索:官方把snippet描述为适合界面展示的短摘要,把summary描述为适合模型阅读的长摘要。需要快速判断候选时,可以先读摘要;要核对原文里的条件、引文或完整上下文时,再考虑取正文。这是工作流设计上的选择,不是接口保证摘要可以替代原文。
因此,工作流应先判断已有摘要或正文是否足够,再决定抓哪几页。这里不是推荐用最少请求解决一切问题,而是提醒:扩大候选列表和逐页抓取,是两种不同动作,它们对工具账单的影响也不同。能否少抓页面而不损失答案质量,需要你自己的任务验证。
HTTP 200不够:怎样才算一条收费请求
官方的成功计费条件同时看状态和内容:请求返回HTTP 200,并且Search的results数组非空,或者Fetch确实返回页面正文,才计费。失败请求、没有匹配的搜索和超时不收费。
这让“成功”有了明确的接口含义,却没有保证研究任务一定完成。Search返回了非空结果,但链接与你的问题关系不大,仍可能是一条收费请求;Fetch成功拿到了文章,也不意味着文章里一定有你想找的答案。价格不是按“最后回答得满意不满意”结算。
尤其不要把两个空值混在一起。Search有匹配结果,但某条结果的content为空,与整个results数组为空,不是一回事。前者可能只是没有要求返回正文,或者正文不可用;只要搜索满足非空结果的成功条件,就不能因正文空着而认定这次搜索免费。
Fetch的边界也类似:网站不可用、目标站访问策略阻止、内容类型不支持,或者提取不出可用Markdown,都可能导致失败,而不是“抓到了一个空壳也算正文”。具体状态应依据接口响应判断,不宜用应用界面上的“已完成”替代。
重试要按新请求继续看。如果一次超时不收费,随后重试成功,成功的那次仍应计入。它不意味着整项任务免费,也不意味着可以无限重试;等待和失败依然会消耗时间。对于超时后结果不明的复杂情形,本文没有真实扣费数据,不把文档原则扩成所有重试都不会重复收费的保证。
1000个研究任务,为什么可能是3美元工具费
把调用链展开,预算反而容易算。以下是一个纯假设:共有1000个研究任务,每个任务只发起一次成功Search,返回五条匹配;随后选三个URL,各成功Fetch一次。没有重试,也没有其他成功的搜索或抓取请求。
| 分项 | 假设下的成功请求数 | 公式 | 工具请求费 |
|---|---|---|---|
| Search | 1000 | 1000÷1000×0.75美元 | 0.75美元 |
| Fetch | 3000 | 3000÷1000×0.75美元 | 2.25美元 |
| 合计 | 两类请求分别计数 | 0.75+2.25美元 | 3.00美元 |
这里的3美元只包含Search/Fetch请求费,不含模型token、宿主订阅或其他服务费用,更不是1000次研究任务的完整成本。它也没有假设实际搜索质量、答案正确率或任务完成率。
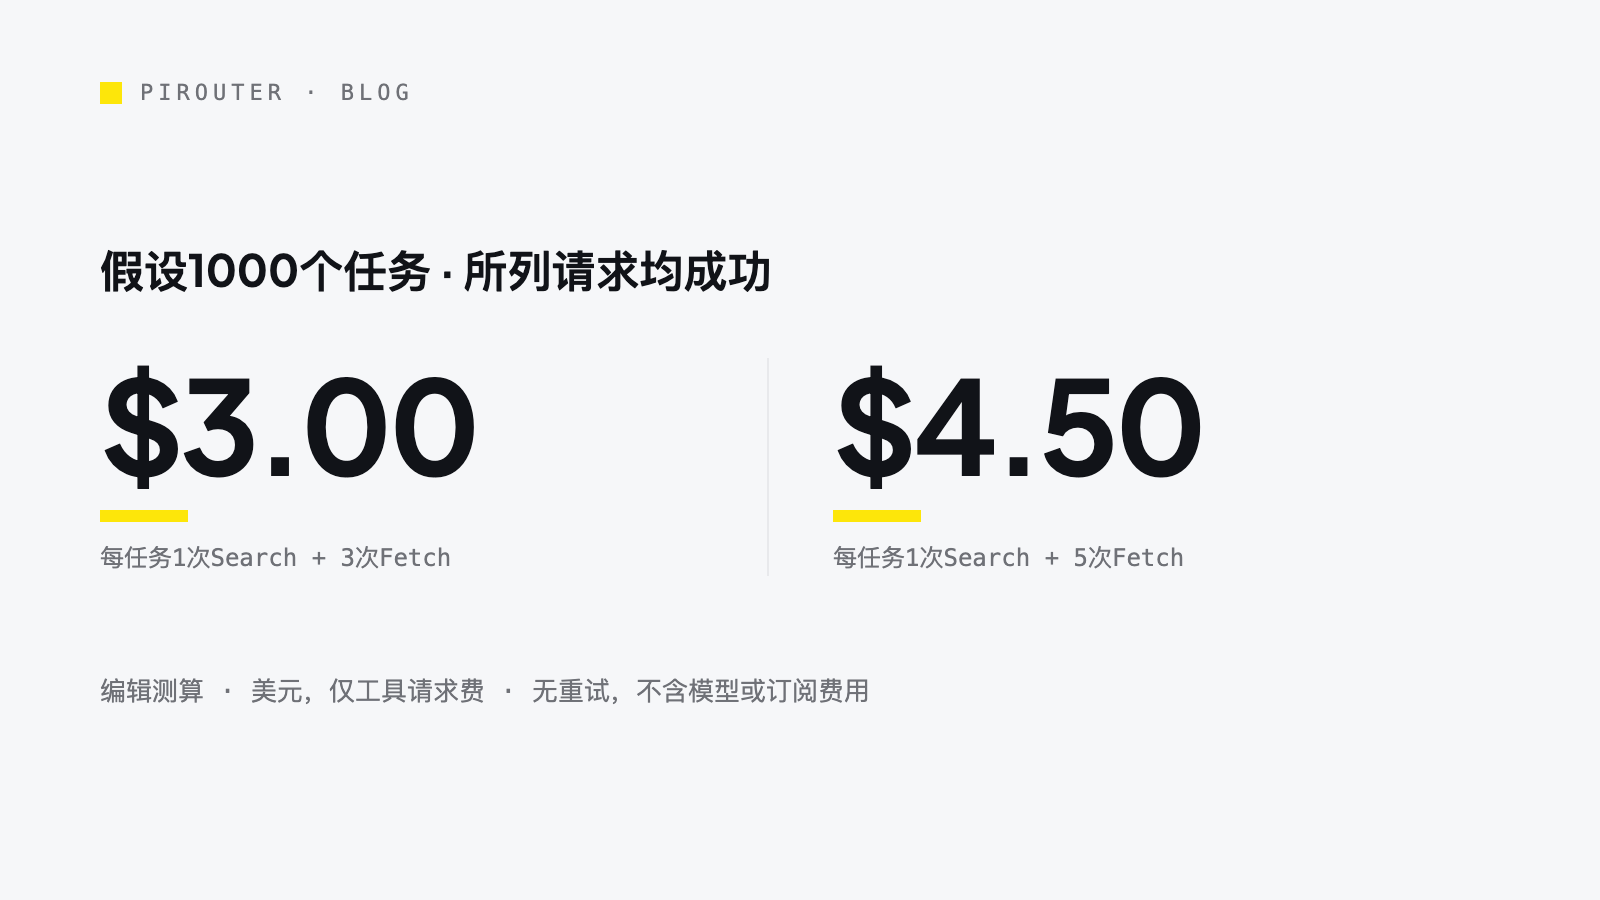
如果改成每个任务把五条结果全部Fetch,在其余假设不变、每次抓取都成功的条件下,Fetch会变成5000次、3.75美元,加上Search的0.75美元,工具请求费合计4.50美元。
两个算例的差别不在Search返回了几条,而在后续实际发起了多少次成功Fetch。仅提高count不会抬高Search的每请求价格;如果应用因此自动抓取更多URL,费用才会沿着抓取数量增加。拿到更多正文之后,模型要读多少内容,又属于模型token费用这一层,不能混进“每千次0.75美元”的工具单价里。
这个拆法比只比较一条接口单价更接近预算问题:先数清请求怎样展开,再判断哪些结果值得交给模型处理。少抓不必然更好,多抓也不必然提高答案质量。
收费生效前,先把调用量与账号配额分开看
预算之外,还有运行边界。截至10月28日,官方文档给出的账号级限制为Search每秒100次请求、Fetch每秒25次请求;两者分别计算,使用Search不会占用Fetch的额度。
这些限制在同一账号的API Key之间合并,不是多建几个Key就能把每秒额度翻倍,也不同于模型并发限制。Fetch还受单域名请求速率限制,但所读指南没有给出该限制的具体数值。文档标出的QPS也不等于本站已经测得的持续吞吐。
因此,一次搜索随后触发多页抓取时,除了费用,还要考虑Fetch的独立限额和目标域名限制。工具失败不计该请求费,并不能消除拥塞、等待或重试带来的任务延迟。
11月1日之前最值得做的准备,是确认实际调用路径,并把Search、Fetch和模型费用分项观察。至少记录两类工具的请求次数、响应状态和是否产生计费所需结果,再用自己的抓取策略估预算;别只统计用户提了多少个问题。
这次变化并不复杂:指定路径上的免费期结束,工具费用开始需要显式计算。真正容易算错的,是把一次对话当成一次调用,把非空结果当成研究成功,或者把一项免费说明当成整条工作流的免费承诺。