DeepInfer 开源了推理核心,完整服务还要补三块系统
根据10月28日读取的官方资料,DeepInfer 公开的是特定模型与硬件上的离线推理核心,不是完整在线服务。读懂 KV 缓存、分离部署和跨副本均衡的缺项,以及 4 卡预填充、64 卡解码与吞吐计数的口径。
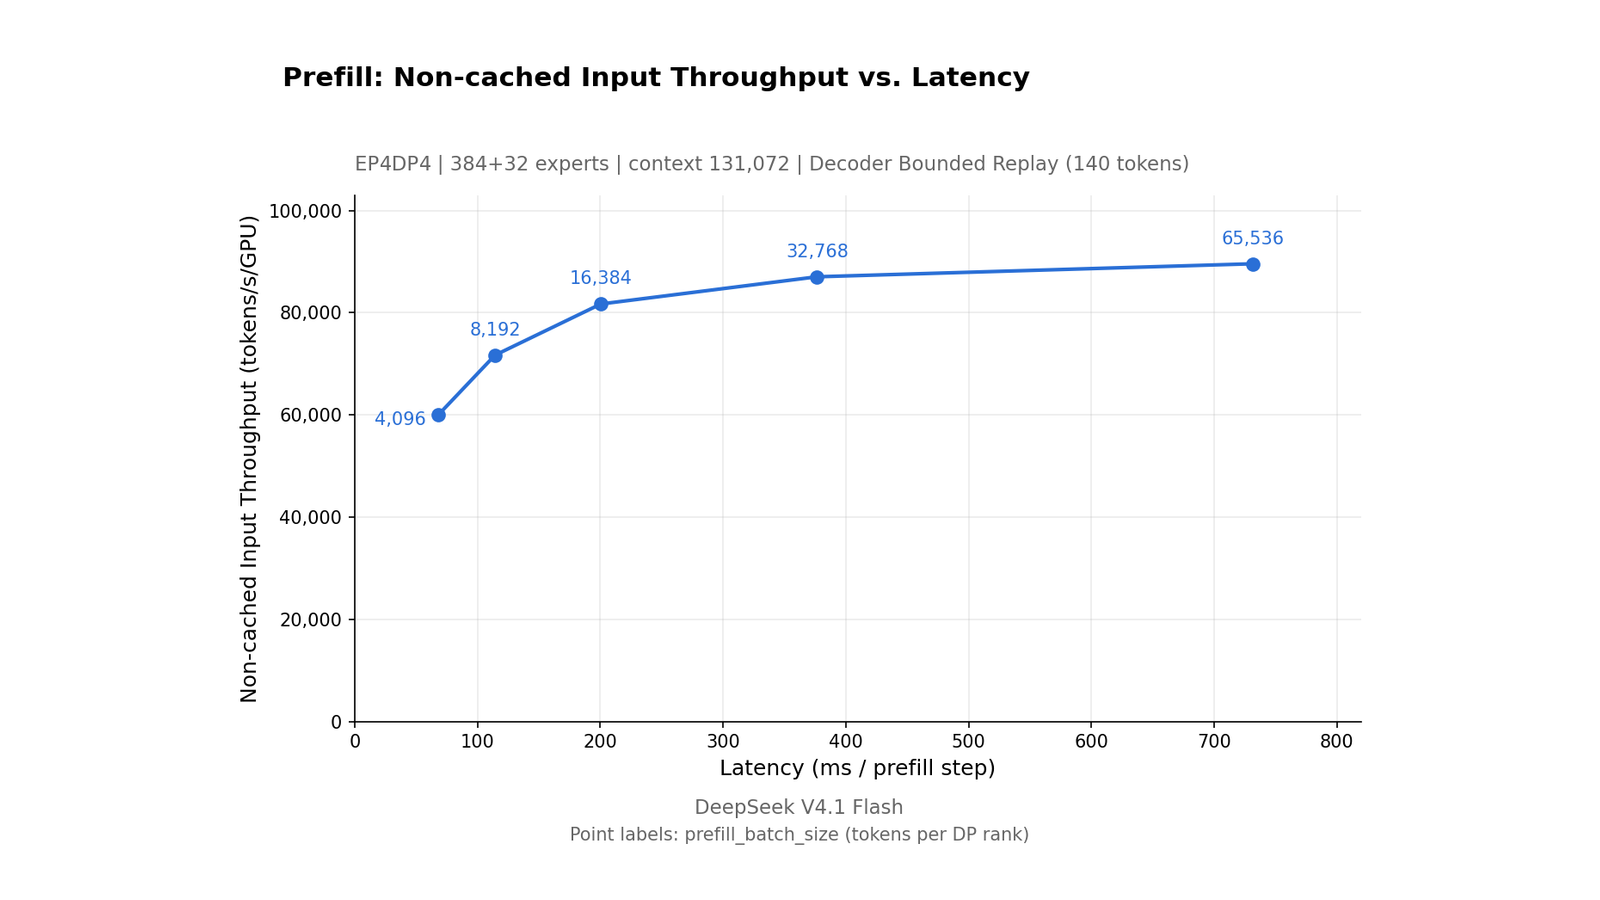
根据10月28日读取的官方 README(当时的 main 分支,未固定提交),DeepInfer 开源的是离线推理核心,以及规模化服务所需的一组底层能力,不是一套已经装好的在线推理服务。该日资料列出 DeepSeek-V4.1-Flash、NVIDIA SM100 GPU 和华为 Ascend 950 NPU;完整服务还需要补齐 KV 缓存系统、视觉编码/预填充/解码分离,以及跨数据并行副本的负载均衡。它值得有相应模型、硬件和系统集成能力的团队研究,不能仅凭“来自生产系统”就当成可直接替换的通用服务。
最容易产生误会的时刻,是离线样例终于生成了正确答案之后。对开发者,这是重要的一步;对等待接收真实流量的产品,它还不是最后一步。
DeepInfer 已有的不只是算子,但交付仍是离线核心
设想一个团队已经拥有匹配的设备,希望把现有模型服务切到 DeepInfer。第一批提示词跑通后,团队很自然会继续问:能否让多个应用接进来?请求长度不一怎么办?负载上升后该往哪个副本发?
从用户一侧看,一次调用是连续的:请求进来,等待资源,被分配到合适的执行位置,处理上下文,逐步生成,最后把结果返回。离线样例能验证其中的模型执行,却不能单独证明这条服务链已经接好。下面的三个缺项,正好可以放回这条路径理解。
官方 README 首段称 DeepInfer 是支撑 DeepSeek 大规模生产服务的推理框架,但紧接着限定,本次开源发布提供的是 offline inference。生产系统的来源与公开版本的交付范围,必须一起读。(DeepInfer README:发布范围与支持特性)
这不是“只放出来几个矩阵乘算子”。现有能力包括优化内核、模型与采样运行时、多种并行方式、专家负载均衡、草稿解码及置信度调度验证、异步调度和结构化输出。异步调度把 CPU 批次安排与设备执行重叠;结构化输出可以约束正则表达式、JSON schema 或语法。它们都是推理核心里的实际工程价值。
不过,10月28日所读 README 的支持列表也不是跨平台承诺。其中的批次不变推理和确定性采样标明仅限 NVIDIA,并有对应配置条件。该日资料列出 Ascend 不意味着每项特性与 NVIDIA 完全相同;列出 SM100,也不等于所有 NVIDIA 显卡都在范围内。实际评估前先核对官方现行支持范围与自身设备,才值得讨论后面的集成。
完整推理服务缺的三块,解决的是不同层的问题
10月28日所读 README 列出了“完整推理服务所需、但该次开源发布未包含”的三项;这是当时文档明确的交付缺项,不是对今日版本的断言,也不是完整的上线验收清单。这比从功能名字猜生产就绪程度更有用。
第一项是 KV 缓存系统。 KV 是模型处理上下文时保存的键值状态,可以减少重复计算。缺少完整缓存系统,不等于引擎完全没有 KV:官方基准会先计算共享前缀,再让分叉请求复用前缀,各自处理未缓存后缀。(DeepInfer Examples:阶段解耦与共享前缀)
二者并不矛盾。一个受控批次已经能使用这些状态,与把状态交给长期接收请求的服务系统管理,是不同的交付。该如何组织应用所需的缓存能力,仍应按实际服务需求设计,不能把基准中的复用等同于所有缓存问题已经解决。
第二项是 VE/Prefill/Decode 分离。 VE 是视觉编码,Prefill 是处理输入上下文,Decode 是逐步生成输出。它们的计算特征不同,完整服务可能需要分别组织资源与工作流。
这里也不能走向另一个极端,说 DeepInfer 完全没有分离所需能力。README 特别注明,大部分所需的引擎功能已经实现;未包含的是该条目所指的完整分离交付。底层具备接口与执行能力,不等于部署、连接和运行管理已经替使用者完成。
第三项是跨数据并行副本的负载均衡,覆盖预填充和解码。 数据并行副本可理解为处理请求的多个实例。把请求送到哪个实例,与 MoE 模型内部把计算分配给哪些专家,并不是同一个问题。
因此,已有的专家负载均衡 EPLB,不能拿来抵消服务层这一缺项。前者关心模型内部专家的工作分配,后者关心服务请求落到哪个副本。名字里都有“均衡”,粒度却不同。
把请求的旅程串起来看,区别就更清楚:进入服务后先决定由哪个副本接手;进入执行阶段,才涉及上下文状态和不同计算阶段怎样衔接;生成完成后,还要把结果交回调用者。README 标出的三项是这条服务链上的具体集成边界,不是说引擎一行缓存、调度或并行代码都没有。
4 卡预填充、64 卡解码,吞吐还要读清 token 怎么计
服务边界读清以后,才能准确看性能图。
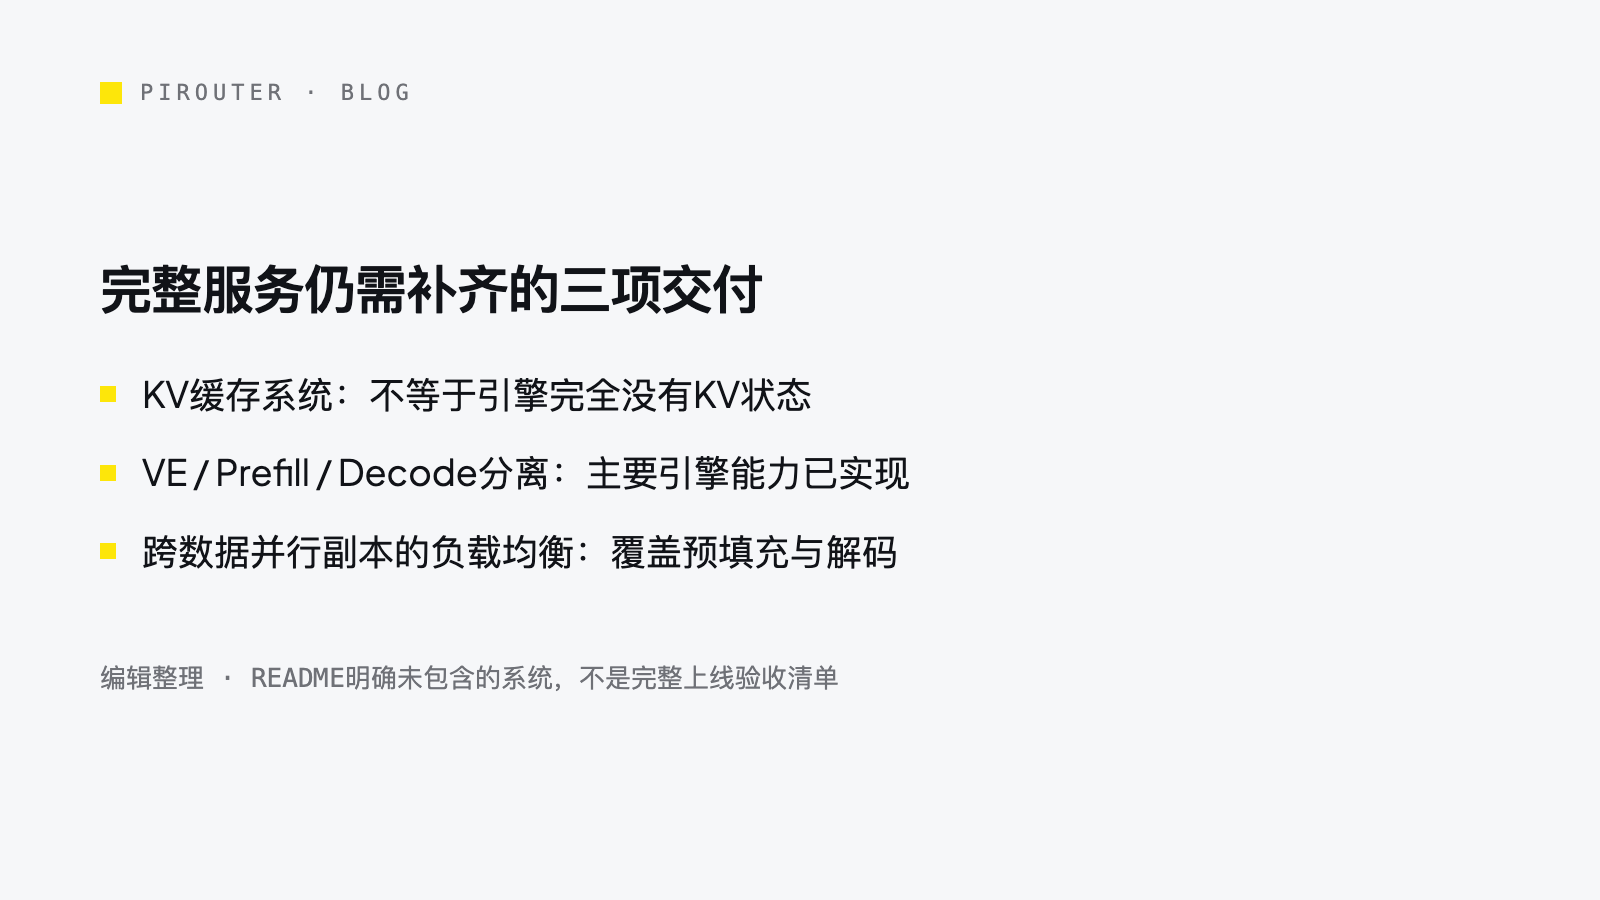
官方预填充测量使用 4 张 SM100 GPU,解码测量使用 64 张 SM100 GPU,两项各自在单个 scale-up domain 内进行,也就是依赖同一高速互联扩展域的配置。它们不是同一套单卡实验,也不能被概括成普通服务器装好就有的收益。
即使指标按每 GPU 表示,单位归一化也没有抹掉多卡并行和互联条件。把每卡吞吐直接乘到另一种集群,或者反过来除成单卡部署承诺,都超出了这些实验提供的证据。
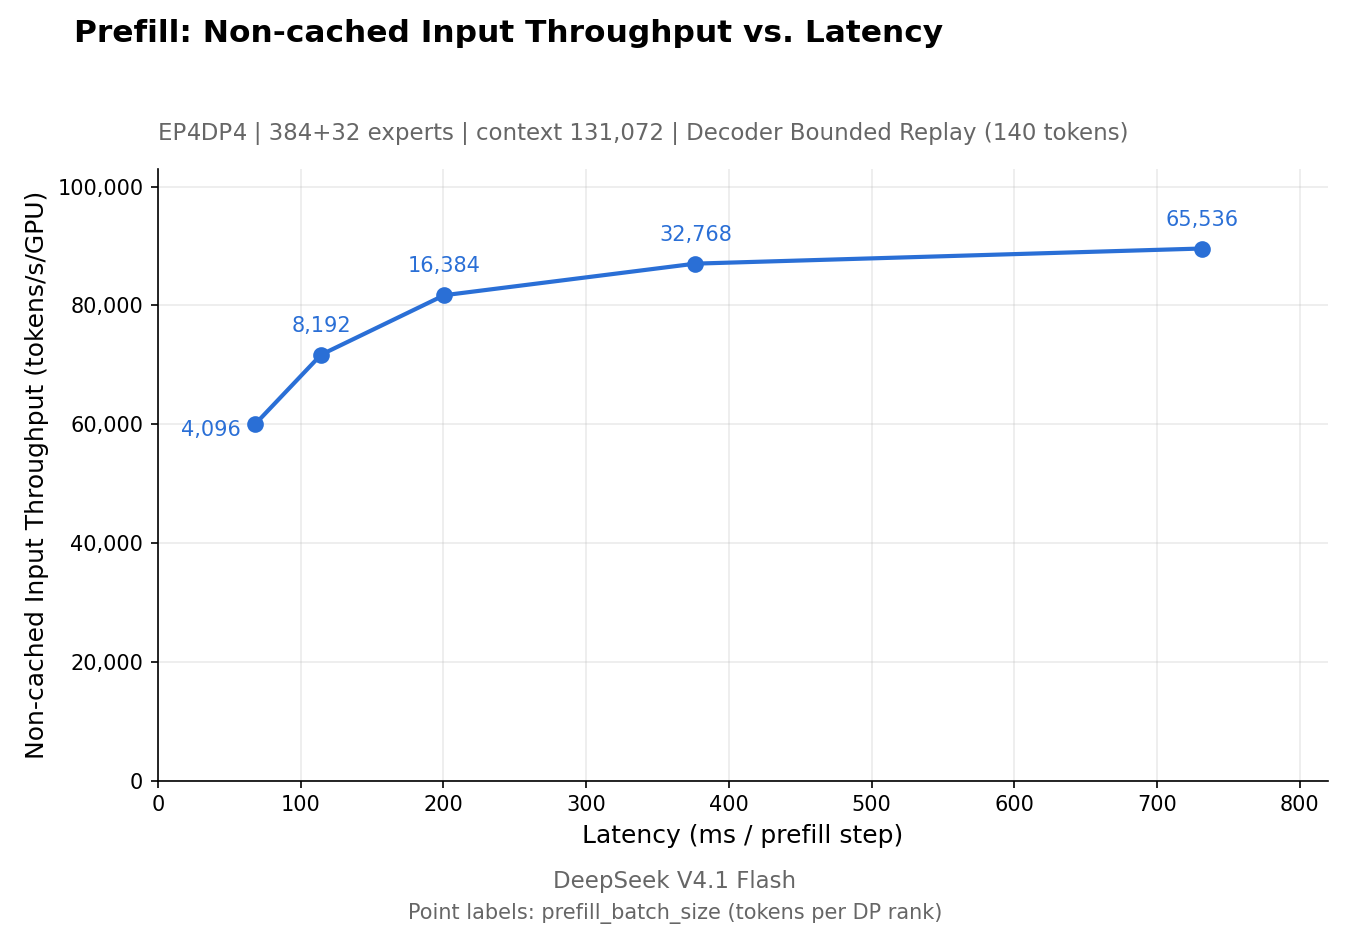
输入负载也值得一起看。Examples 文档将基准的预填充与解码分开控制,默认上下文为 32768 tokens,其中未缓存部分为 4096 tokens,默认解码请求数为 64。这些是 Examples 的默认负载,不是发布图的全部测量配置;本次取得的预填充与解码图,图头都明确写着上下文 131,072。有共享前缀、指定后缀长度的受控负载,也不等于任意在线请求到达时都能得到同样结果。
还有一处更容易漏看:原始解码吞吐采用 full-acceptance accounting,按草稿全部接受的方式计数,不随真实草稿接受率变化。草稿解码先提出候选,再做验证;参与候选计算的 token,不能不加区分就称为用户实际收到的有效输出。
官方 sweep 示例允许用假设接受率缩放绘图,例如传入 0.75。本次取得的官方解码发布图也明确标注:固定 nextn=3,按 75% 的每 token 接受率缩放,对应 τ=3.25。这是发布图采用的计数口径,不是本站或官方已测得 75% 接受率的证明。比较吞吐之前,要分清原始记录、绘图假设与实际接受情况。
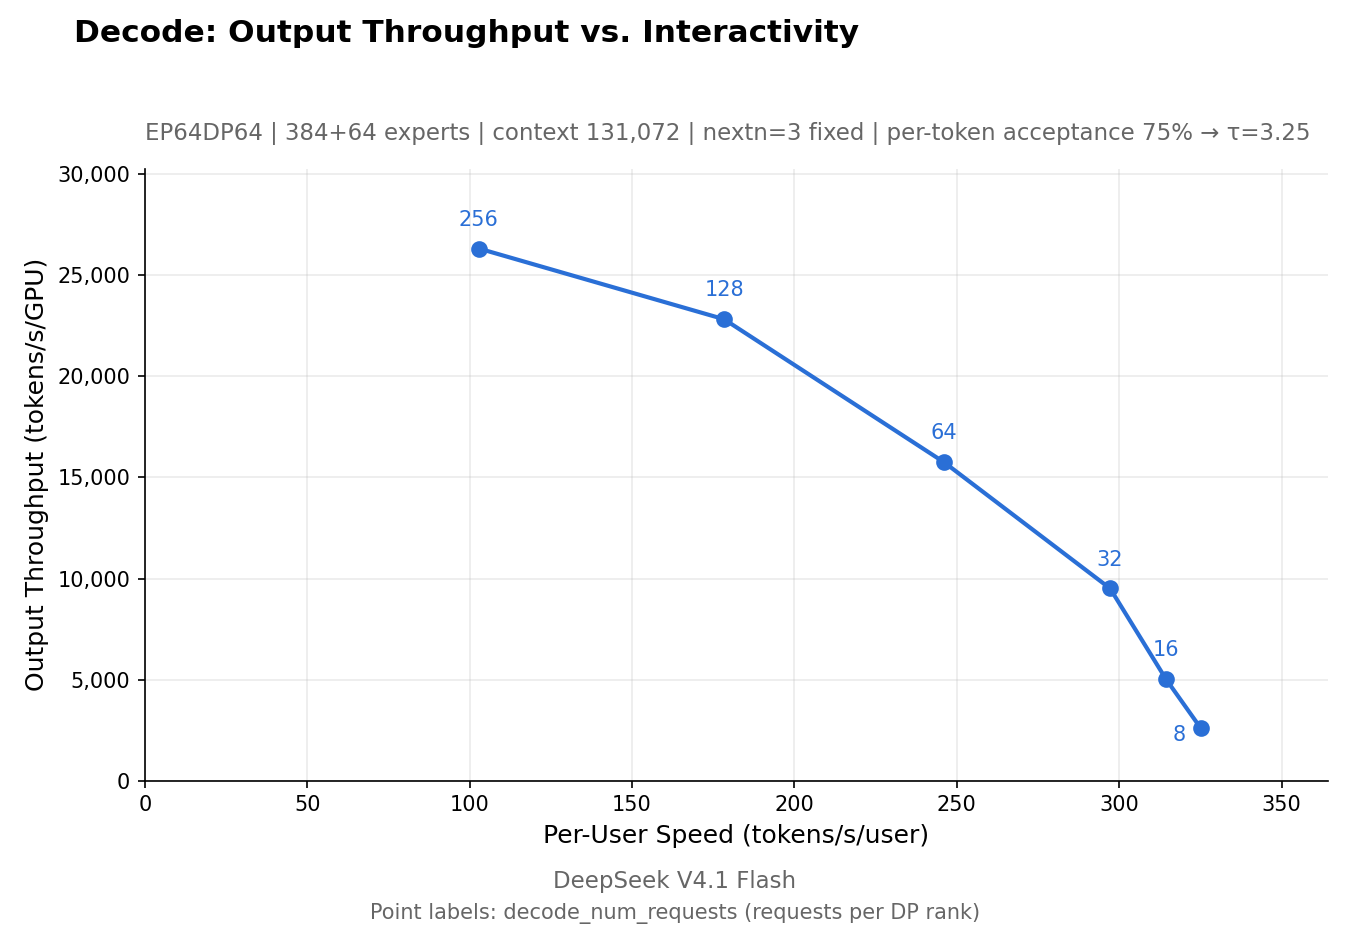
性能分析工具的时间也不能随手拿来算吞吐。Examples 明确提醒,profile trace 内的步耗时含分析器开销,不应用来推导每秒步数。性能图有用,但先确认“测了什么、算了什么”,比先找最高点更重要。
参考准确率是部署体检,不是服务质量保证
推理快还不够,配置改动后,模型结果有没有保持正确同样重要。DeepInfer 的评估脚本把生成和评分分开:先以离线批次生成并保存原始输出,再读取结果评分;更换裁判时,不必重新生成。(DeepInfer Evaluation:评估方法与完整覆盖)
它报告 Pass@1,但不能把所有项目都理解成“每道题只跑一次”。例如默认配置下,数学评估 AIME 每题生成 32 个样本后取准确率平均,GPQA 每题使用 8 个样本;不是从多次尝试中挑最好的一次,再把它叫单次成功率。HLE 则每题使用一个样本。
评分方法也影响可复现性。默认 LLM 裁判判断答案与参考答案是否等价,受到裁判自身采样影响;规则裁判可以对部分任务确定性匹配,但 HLE 仅支持 LLM 裁判。更基础的一关是 coverage_complete 必须为 true,否则缺了计算分区或样本,Pass@1 便不完整。
README 把参考成绩定位为检查配置是否正确的 sanity check,也说明重复运行可能有随机差异。它不是要求每次复跑精确命中某个小数,更没有验证在线队列、故障恢复或用户体验。质量回归与服务验收,需要分别做。
什么时候值得试,什么时候不该直接替换线上服务
如果你的目标模型和硬件经现行文档核对仍在支持范围内,正在研究底层执行、并行和调度,并且有能力补服务层,10月28日所读资料提供了值得进一步评估的代码与测量路径。如果你想要的是在普通设备上直接装好一套通用在线 API 服务,该日 README 并没有作出这样的交付承诺。
进入验证前,先固定版本和负载,再记录真实输出、草稿接受情况、吞吐、延迟与评估覆盖。只有这些口径能对应到自己的任务,后续多副本流量测试才有比较基础。本文依据 10 月 28 日核对的 main 分支文档解读范围,未绑定固定 commit,也没有构建或运行 DeepInfer,不构成固定版本的复现记录。
“离线推理”还不自动等于全流程断网。默认示例首次会下载模型权重,使用本地模型目录是另一条路径;评估默认可能调用外部裁判服务。需要隔离网络的团队,应检查具体数据与调用路径,而不是从 offline 一个词推断隐私保证。
README 标注引擎采用 Apache License 2.0,但引擎代码与模型权重也应分别核对许可,不能相互替代。
这次开源的价值,不需要靠把集成工作说没了来证明。10月28日所读资料公开了一个有具体模型、硬件与测量条件的推理核心;是否值得采用,取决于经现行文档核对后的能力能否匹配你的系统,以及团队是否准备接住当时 README 列出的三块服务工作。