Timestral 值得试吗?先看数据、预测跨度和权重许可
Timestral 是数值概率预测器,不是聊天模型。用门店销量的假设场景,读懂未来已知协变量、32,768 时间步、长预测分块,以及 209M 权重的上月收入许可门槛。
假设你要预测门店下周每小时的销量,需要的是一组未来数值及其不确定性,而不是聊天模型写一段经营建议。Mistral 在 Timestral 发布说明中介绍的,正是这种数值概率预测器,实际发布日是 2026 年 10 月 15 日。现在考虑采用它,先看数据在预测时是否可得、预测跨度如何延长,以及具体权重的使用许可;模型参数小,并不能替你回答这三个问题。
本文以 10 月 28 日读取的公开材料为基础,并在 10 月 30 日再次读取官方模型资料与 209M 权重许可;仓库实现说明仍限定为 10 月 28 日留档。没有运行模型或做业务精度实测,也不把这次解读当成一次新发布。
Timestral 预测数值,不替你解释经营原因
Timestral 家族提供 5M、28M、123M 和 209M 四种参数规模。它处理的是按时间排列的目标序列,可以联合预测同一序列里的多个变量。输入不是一段提示词,输出也不是自然语言答案。
Timestral 仓库 README — Forecast给出的目标数组形状是 (B, V, T):一批序列、每条序列中的变量、历史时间步。单变量或单条序列还可以用更简单的形状;缺失观测用 NaN 表示,也可另给观测掩码。接入前要做的,是把数据组织成正确的时间轴,而非换一种问法。
它为未来每个时间步输出 21 个分位数,包括中位数,以及两端的 0.01 和 0.99。中位数给出一个中心预测。以0.99分位数为例,它描述模型预测分布中较高的一端;回测时可以检查真实值落在这个预测值以下的比例,是否接近99%。这比只交出一条曲线,更适合讨论备货不足或容量预留的风险,但仍要用自己的历史数据验证。
但分位数不是经营建议,也不自动证明区间在你的门店数据上覆盖准确。销量为什么下降、该不该调整价格,仍然需要其他证据和决策过程。即使把预测器接进一个语言模型工作流,也不能把整个系统的解释能力算到 Timestral 本身头上。
未来已知协变量,不能拿未来真实销量来填
预测通常不只依赖目标本身。Timestral 区分仅在历史区间可用的协变量,以及在预测发生时已经知道未来取值的协变量,两类都可包含数值或类别信息。
继续用假设的门店场景:过去的客流记录可以提供历史背景;已经确定的营业日历、节假日标记和促销排期,可以作为未来已知条件。它们帮助预测销量,却不是模型要替你预测的目标。
这里的“已知”有严格的时间含义。下周真实销量不能作为下周预测的条件,下周实际客流也不能因为事后拿得到,就被补进回测输入。天气如果使用预测时已经发布的预报,应保留那个版本,而不是换成后来记录到的实际天气。
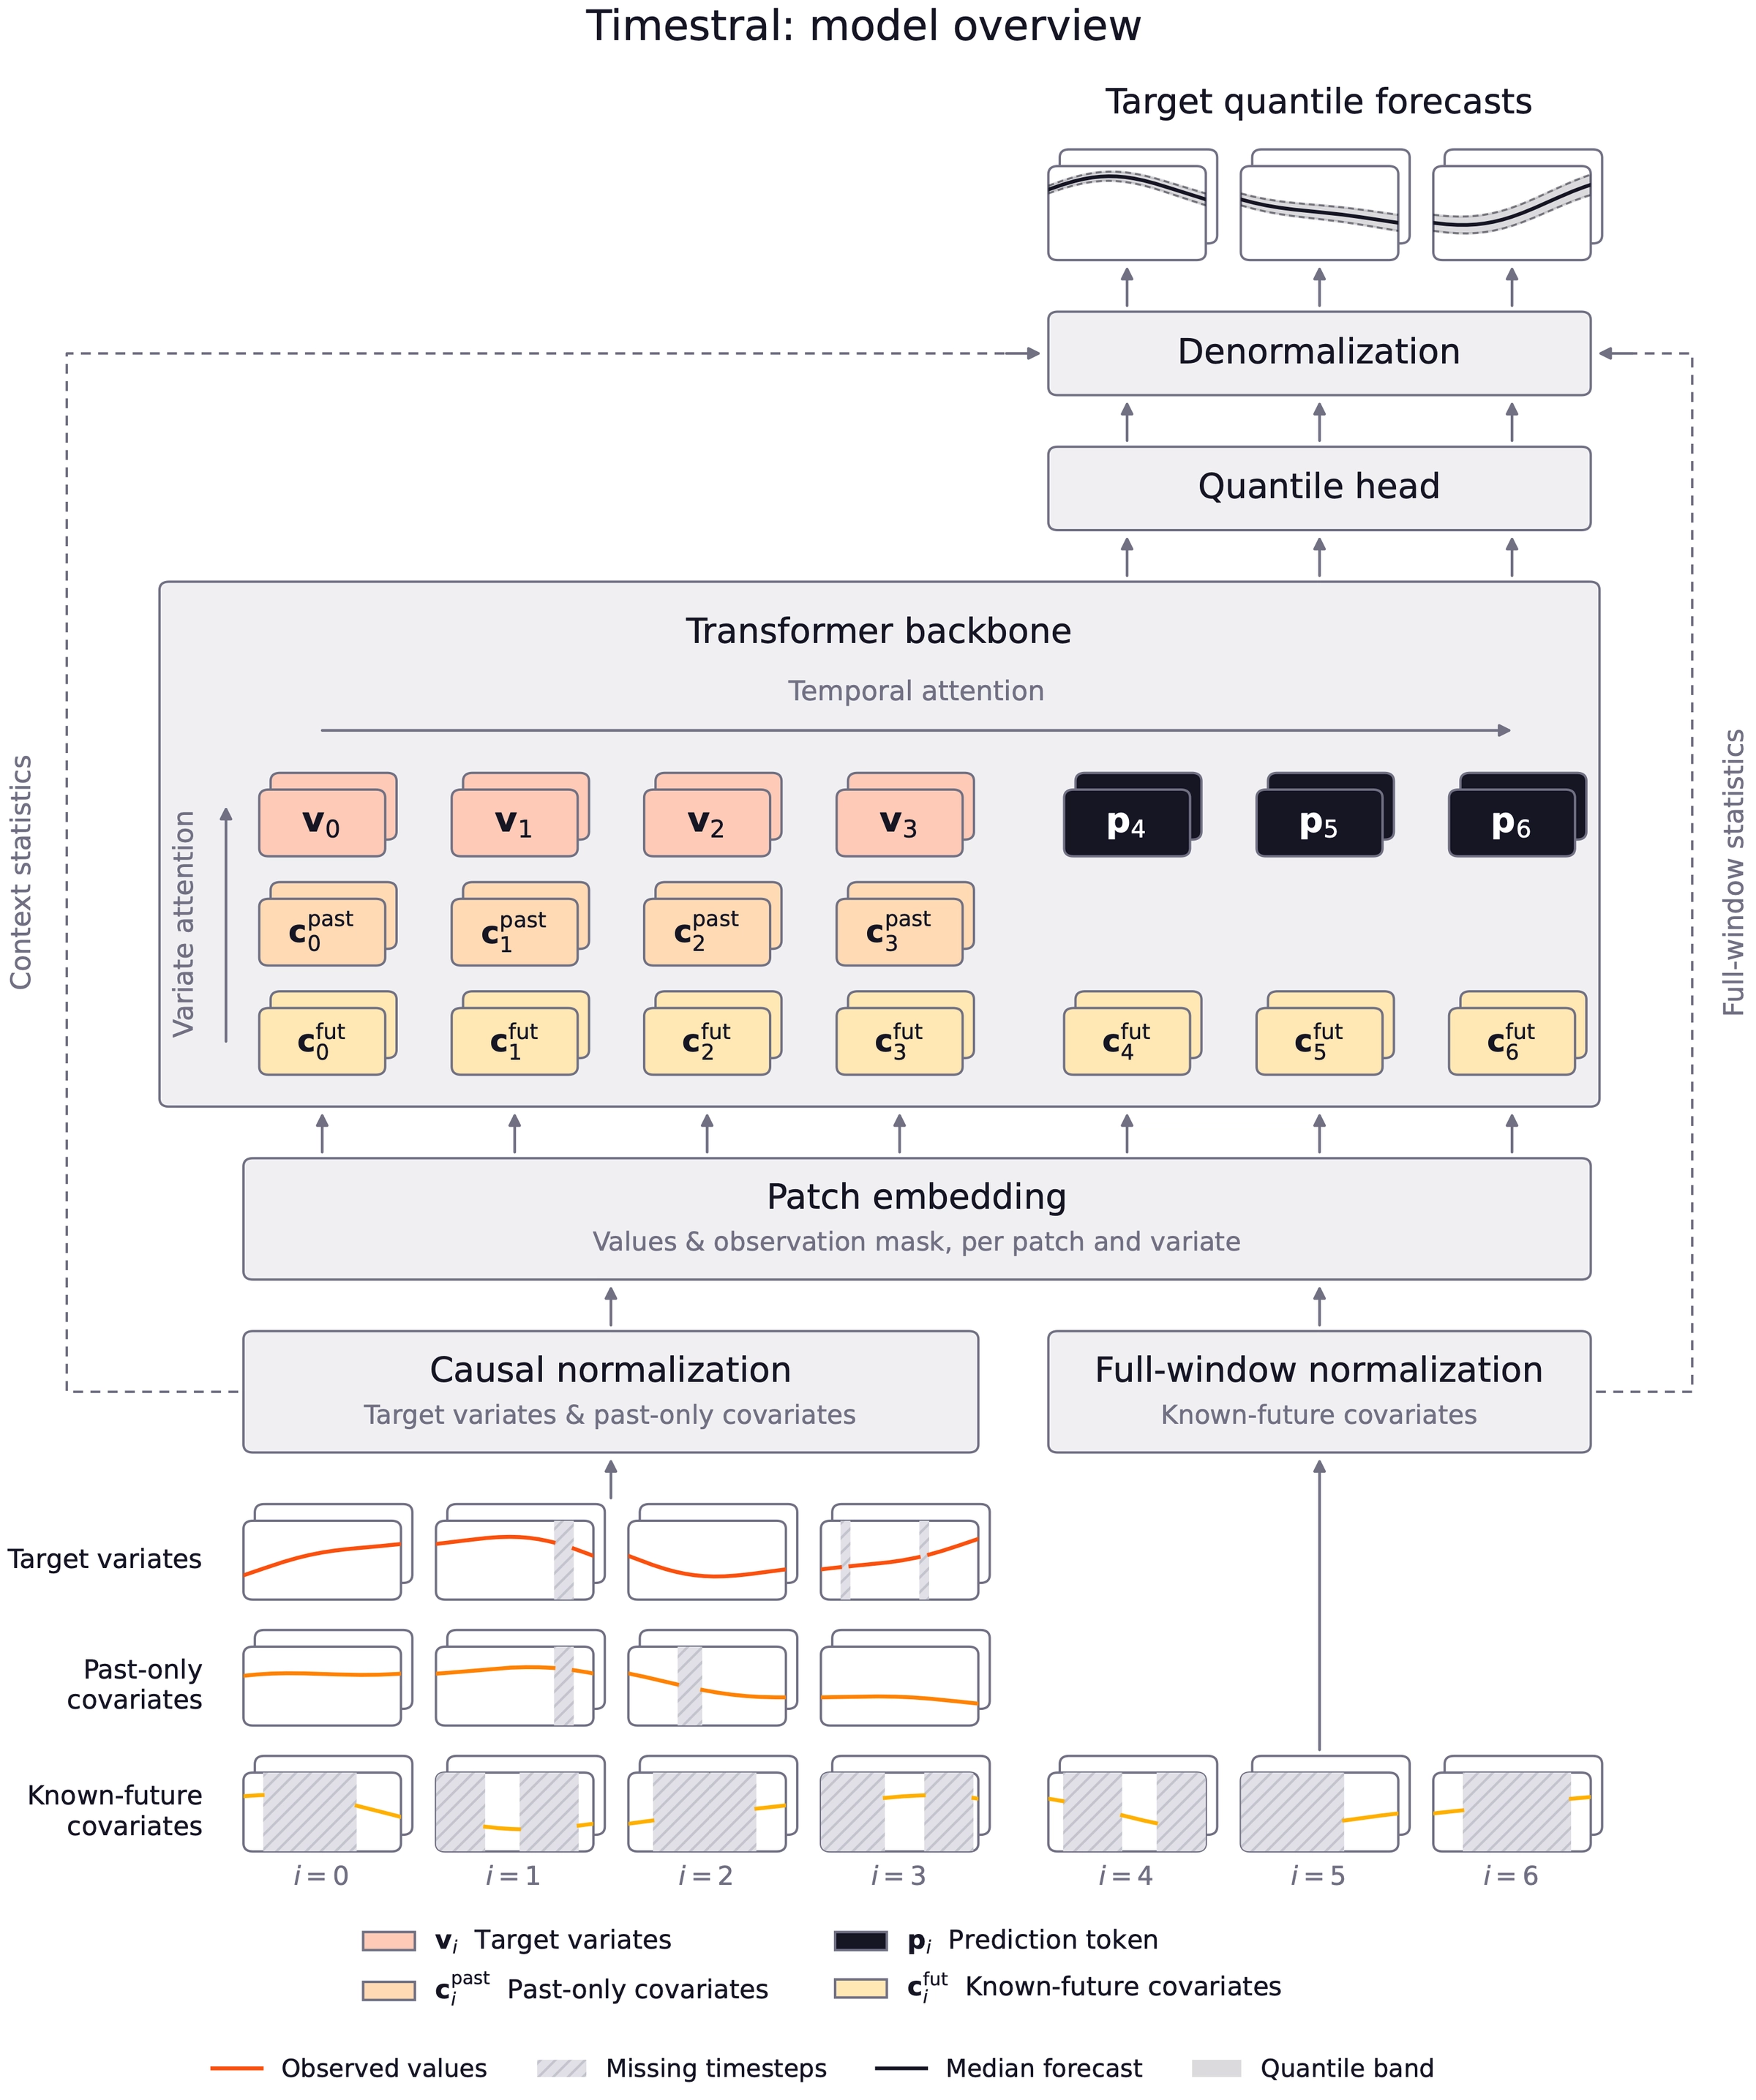
图里的目标变量和协变量承担不同角色。Timestral README — Covariates明确说,协变量用于提供条件,并不被预测;未来已知协变量的数组还要覆盖历史加上预测区间。如果预测未来 96 步,就不能只准备历史区间的那一列。
这会改变数据工程的检查顺序。先问每一列在当时是否真的可得,再问它能不能提升精度。否则,回测越漂亮,越可能只是在奖励一次未来信息泄漏,而不是一个能投入实际使用的预测器。
32,768 是历史时间步,长预测要分块
Timestral 接受最多 32,768 个历史时间步。这里不是聊天模型的文本 token,也不是固定的日历长度:按小时采样和按分钟采样,同样的步数覆盖完全不同的时间范围。10 月 28 日读取的仓库说明写明,历史超出上限时保留最近部分,丢弃最旧观测。
因此,“我们有好几年数据”不等于模型一次会读完好几年。应先根据采样频率,把业务关心的日、周或年度变化换算成时间步,再决定数据准备与验证方式。把序列降采样也不是免费的:时间跨度变长,细粒度峰值信息可能随之减少。
历史能读多长,与未来一次能预测多远,是两个数字。Timestral-209M 模型卡 — Model Details写明,每个输入分块(patch)包含 32 个时间步,一次前向预测最多 1,024 步。需要更长预测时,按块生成,并把每一块的中位数预测追加回上下文,继续下一块。
例如按小时预测,1,024 步约为 42.7 天;假设要预测 90 天,就是 2,160 步,需要多个块,而非一次前向完成。这只是按小时数做的换算,不是本文测得的能力或速度。
中位数回接意味着,后面的块会使用模型前面自己给出的中心预测。不能因为最终仍输出分位数,就理解成它把前一块所有可能路径的不确定性完整传播了下去。预测拉得越远,越应按不同跨度分别检查误差和区间表现,不能用近端预测的成绩担保远端结果。
先用自己的序列回测,再决定是否替换现有预测
厂商把 Timestral 定位为预训练、零样本预测模型。零样本让“不先为这一批序列训练专门模型”成为可尝试的路径,并不免除验证。仓库列出了 GIFT-Eval、TIME 和 fev-bench 的评估条件,但这些是厂商报告,不是本文的独立复测,也不是门店业务收益的证明。
一个务实的起点,是先保留现有预测流程,再按过去多个时间点做滚动回测。每次只提供当时能取得的数据,按实际需要的预测跨度比较误差,并分别查看旺季、淡季、缺失数据或突发变化时的结果。这些是采用建议,不是已经完成的实验记录。
比较对象不必一开始就复杂。上一周期同一时段的数值、简单季节性规则和当前线上方法,都可以成为基线。若只有平均误差更好,却在你最在意的高需求时段系统性低估,就还不足以支撑替换。分位数的区间覆盖也应单独验证,而不是只看中位数曲线是否顺眼。
推理代码支持 CPU 或 GPU,但“能在 CPU 上运行”不等于任何机器都满足你的时延预算。批量大小、变量数、历史和预测长度,都应进入自己的测量条件。本文没有实测内存或吞吐,也不把厂商特定负载下的速度写成普遍承诺。
Timestral 1.0 209M 官方模型页当前标为 Public Preview,并提供权重下载信息;现有材料没有核实一个公开的 Timestral 专属托管 API 端点和价表。预算不能直接套聊天模型的 token 单价。准备固定环境时,也应记录代码与权重的具体 revision,而非长期追随可变化的 main。
Apache 代码与 209M 权重,必须分开读许可
还有一道采用门槛不在数据里。10 月 28 日留档的仓库说明声明,代码和测试使用 Apache 2.0;模型权重另行发布,使用 Modified MIT。下载了 Apache 代码,并没有同时取得 Apache 条款下的权重权限。
本次逐字核对的是 Timestral-209M 原始 LICENSE,不是其他尺寸的全部许可。它要求副本或实质性部分保留署名和许可通知,第 2 条还写明:如果你的公司或雇主上一个月的全球合并月收入超过 2,000 万美元,就不获准行使该许可下的权利。
这是月收入,不是年收入;对象是公司或雇主的全球合并收入,不是只算这个模型带来的收入;条款也没有把触发条件限定为经营模型即服务。把它简写成“MIT,可无条件商用”,会漏掉直接影响采用资格的部分。
原文还把基于该模型的衍生、修改和组合作品纳入限制,包括由第三方提供的版本。因此,换个分发者或拿到一个修改版,并不能仅凭这个动作认定条件消失。超过相关门槛的团队可联系厂商申请单独商业许可,是否授予由厂商决定;具体适用与边界问题应交给法务核对。
这个结论只覆盖本次读到的 209M 许可,不能自动外推整个家族。许可中提及托管服务的替代选择,也不能代替当前端点和价格的核验。
对手里已有数值序列的团队,Timestral 值得进入验证集:先核对准备使用的具体权重许可;在许可允许的前提下,再准备不泄漏未来的输入,按真正需要的跨度回测,最后决定是否接入业务。别让一个小参数量或一个 Apache 标签,提前替你做完采用决定。