FLUX 3 Image Klein 能上 8GB 显卡,先选对本地管线
FLUX 3 Image Klein 的 8GB 路线对应 INT8 实现,5.6B 只统计生成器。拆开文本编码器、VAE 与独立 Pup 扩写器,再看 H100 测量和分阶段运行,判断你的本地改图工作流需要什么。
FLUX 3 Image Klein 在 10 月 15 日开放权重,官方参考仓给出了最低 8GB 显存的本地路线,但它指向 ComfyUI 专用 INT8 文件、RTX 3070 这类显卡,不是任意默认配置都能装进 8GB。5.6B(56 亿参数)只统计图像生成器,文本编码器不在其中;提示词扩写器 Pup 又是独立模型。判断显卡够不够,先把这些组件分开,再看它们是否同时驻留——以下是官方资料与实现者测量的对读,不是本站亲测。
8GB 对应 INT8 路线,不是默认 BF16 示例
假设你已有一张 8GB 显卡,想把商品图的局部修改搬回本机,第一件事不该是复制一段加载代码,而是选对模型版本和工作流。BFL 发布公告同时提供 Base 与步数蒸馏版:前者面向微调研究,后者面向低延迟生成。使用指南列出的默认推理步数分别为 50 和 16。只想先生成、编辑图片,Distilled 是更直接的起点;“能推理”也不代表同卡就能训练 LoRA。
8GB 的说法有明确分支:官方参考实现 README把 RTX 3070 级别的 8GB 显卡指向 ComfyUI 的专用 INT8 文件,并明确参考代码本身没有 INT8 路径。而官方 Klein 使用指南的 Diffusers 入门代码以 BF16 加载组件,再移到 GPU。发布公告也提到通过 Diffusers 运行;这里采用参考仓明确指向的 ComfyUI 专用 INT8 权重入口,不据公告推断任意 Diffusers 配置都能在 8GB 运行。默认示例内存不足,不否定另一套量化路线;有 8GB 路线,也不保证随手运行默认代码就能成功。
Klein 保留了文字生图、图像编辑、多参考与框选布局这些能力。不过,“最多十张参考图”和“最低 8GB 显存”描述的是两种上限与下限,不能拼成一张十参考、4K、8GB 同时成立的配置单。
5.6B 只算生成器,完整管线还有三笔开销
这里的 BF16、FP8、INT8 和 NVFP4 是不同的数值精度或量化格式。降低位宽通常能减少权重占用,但可用格式取决于硬件和实现,也可能影响质量;权重变小不等于整个运行过程只需同样多的显存。
公告对参数量有一句关键限定:比较的是各家报告的图像生成器参数,文本编码器不计入。因此,BF16 生成器权重约 11.2GB、FP8 约 5.6GB,都不是整条管线的显存账单。
把请求拆开看,会先遇到将文字变成特征的文本编码器,再由生成器逐步生成图像的潜在表示,最后经 VAE 解码成像素;带参考图时,还要编码输入图。执行期间的中间张量也要占空间。即便生成器权重压小了,其他组件与运行状态不会因此消失。
官方参考仓的 Memory 表给出了另一种观察口径:在 B200、1024×1024,文字生图及单参考编辑、--no-pup 条件下,用 nvidia-smi 观察 GPU 峰值。
| 参考实现配置 | BF16 | FP8 | NVFP4 |
|---|---|---|---|
Distilled,--no-pup | 31 GB | 26 GB | 25 GB |
Base,--no-pup | 31 GB | 29 GB | 26 GB |
这张表已明确排除 Pup,却仍明显高于生成器权重大小。它说明组件与执行期占用不能省略,不是宣告所有 GPU 都有同一个最低门槛。不能拿“FP8 权重 5.6GB”宣布整条管线只占这么多,也不能拿 B200 的参考实现结果否定另一套 ComfyUI INT8、卸载或分阶段执行方案。
对准备下载的人来说,真正要确认的是工作流还加载什么、用什么精度、何时释放。只问参数量,得到的是模型的一部分,不是机器能否完成任务的答案。
Pup 是否自动运行,要看你用的文档与版本
本地部署还有一处容易漏掉:一句“把杯子改成红色”,未必就是 Klein 最适合接收的输入。官方说模型在完整场景描述上训练,因此强烈建议先用 9B 的 Pup 把短要求和参考图扩写成详细 caption,再交给生成管线。
这里存在真实的文档差异。BFL 使用指南仍写 Diffusers 需要单独运行 Pup;10 月 15 日 HF 发布文章展示的也是直接接收完整描述的工作流。但本次核查的 Diffusers main 管线文档已明确:modular 管线每个请求先自动执行 Pup,文字生图和编辑都如此。官方参考仓也采用这个描述,参考 CLI 则默认扩写。
因此,不能笼统说“Diffusers 不调用 Pup”,也不能把当前 main 的行为保证成每个已安装版本。先核对版本、工作流是否包含 prompt_upsampler,并检查实际生成的 caption;同一段短提示,在不同工作流里可能走了不同前处理。
当前 main 文档写,全组件以 BF16 加载、VAE 用 FP32 时,权重约 39GB,其中 Pup 权重约 19GB;移除扩写步骤的管线载入约 20GB。这是权重载入量,不是执行峰值,更不是最低显卡规格。旧指南另外给出的“Pup 额外约 28GB GPU 内存”又是示例占用口径,不能与 19GB 相减推导开销。
同样不能把 28GB 与“INT8 最低 8GB”相加,宣布所有用户需要 36GB。当前文档允许将 Pup 拆为独立阶段,或对包含它的组件做卸载;参考仓也展示了先扩写、保存 caption,再以 --no-pup 生成的路线。释放前一阶段后,两段占用不必全程叠加,但这不证明 Pup 本体能塞进 8GB。
指南还给出自行撰写完整 caption 的替代。跳过扩写时,要真正使用移除了该步骤的工作流,而非只换一段长文字;这也不保证与 Pup 输出等效。HF 发布文章另展示了单独编码文字、缓存 embeddings 后释放编码器的做法:它把文字变成特征,与 Pup 先把短文字写成长描述,是两道不同工序。
H100 的两秒出图,不能写进 8GB 机器的预算
HF 的具名实现文章由 Aritra Roy Gosthipaty、Sayak Paul 和 Linoy Tsaban 撰写,是首日协作实现与测量,不是独立质量盲测。其 Speed 表条件是:蒸馏版、16 步、单张 H100 80GB、不做 offload、默认 attention 后端,热身后测三次取平均;表中未逐行标明精度,不能自行补成 BF16 测试。
| 工作流 | 输出尺寸 | 测得用时 | 表列峰值显存 |
|---|---|---|---|
| 文字生图 | 1024×1024 | 1.93 秒 | 23.8 GiB |
| 一张 1024×1024 参考图的图像生成 | 1024×1024 | 3.87 秒 | 23.8 GiB |
| 一张 1360×768 参考图的框选编辑 | 1360×768 | 4.10 秒 | 23.8 GiB |
这不是 8GB 消费卡预测表,也不能当成当前自动运行 Pup 管线的服务总延迟。HF 同文另有 Memory 表,BF16 / H100 推理后 peak allocated 为 20.72GiB;它与 Speed 表的 23.8GiB 分别报告,未证明同配置,也未解释差额,不能互换。它们更不能与前述 B200 的 nvidia-smi 峰值表混成一套结果。
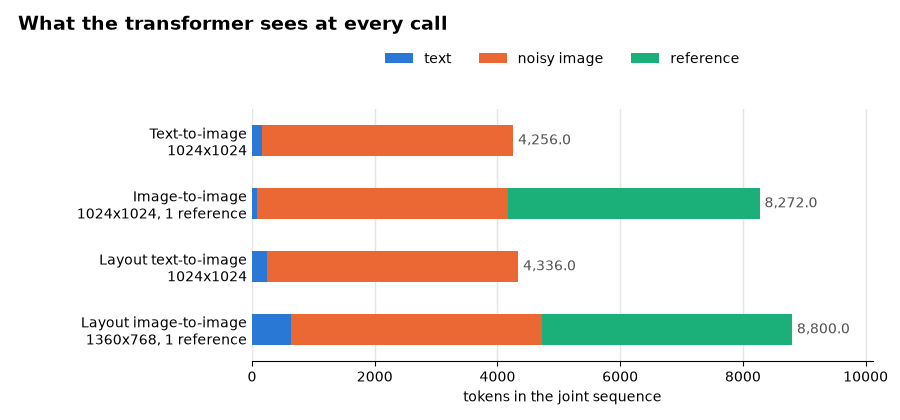
参考图增加的工作也不止发生在入口。HF 说明,一张 1024×1024 参考图会给每次 transformer 调用增加 4096 个 token,与文字和待生成图像共同参与后续计算。这解释了为什么带图编辑需要单独测;它不意味着加一张图就固定翻倍显存,也不能把一参考的用时线性推成十参考的预算。
量化同样要看硬件。HF 列出的 FP8 快速内核面向计算能力 8.9 及以上的 Ada、Hopper、Blackwell;NVFP4 快速内核面向 Blackwell。其他 GPU 的对应路径可能每步反量化,减小占用却没有提速。文章还提供了 CPU 自动卸载方法,但明确没有对它做基准,不能沿用上面的秒数。
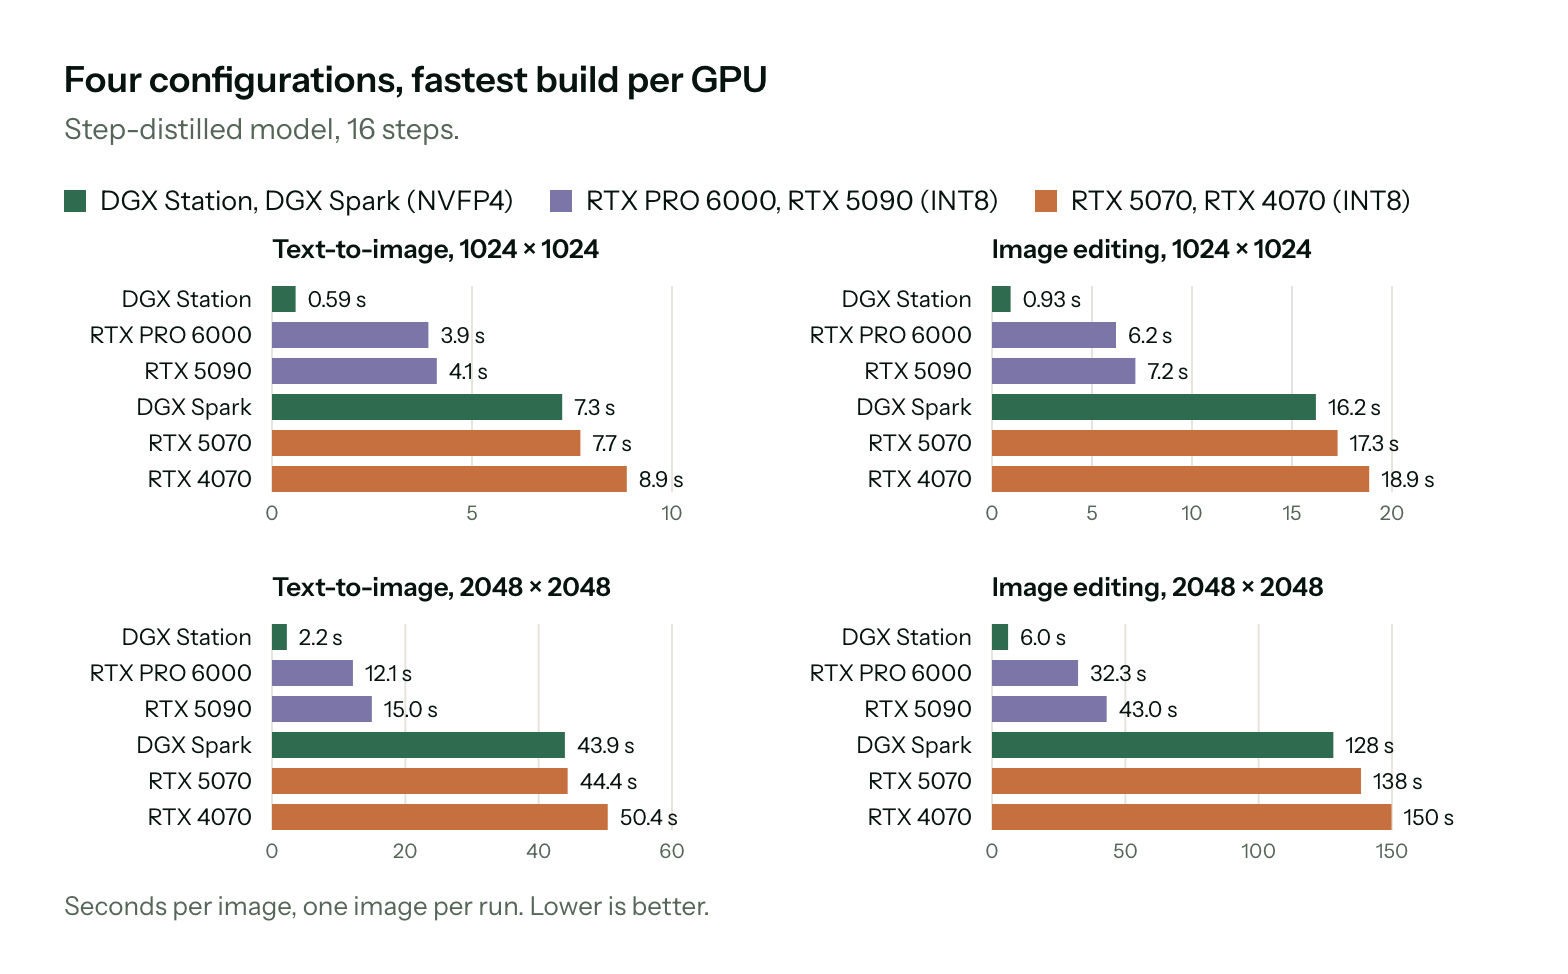
BFL 另有 NVIDIA 测量的消费卡图:RTX 结果来自 ComfyUI,每张 GPU 采用其最快构建。公告明确区分了 GPU 本体生成时间与含排队、网络、提示词扩写的 API 延迟。选本地路线时,两种数字都可以参考,但不能当作同一种计时来比较。
先做最小本地试点,再决定是否补齐工作流
对于已有 8GB 显卡的读者,合理起点是确认 INT8 Distilled 工作流,而非先按全驻留 BF16 配置采购硬件。试点从较低分辨率、较少参考图开始,保存模型版本、精度、步数、输入尺寸与参考数量;分别记录扩写、文本编码、生成和解码阶段的峰值,再计完整墙钟时间。这里给的是验证顺序,不是已经替某张卡跑通的教程。
建议把试点拆成两轮:先固定一条完整描述,确认生成阶段可完成;再加入一张参考图,只改变一个变量。若失败,记录失败发生在加载、编码还是生成中途,而不是只留一句“显存不够”。如果必须卸载组件才能继续,就把卸载策略和等待时间也留在记录里。这样下一次增加分辨率或参考数量时,才知道是哪一步开始超出资源,而不必从头猜测。
验收也别止于“出了一张图”。同样的素材连续修改几轮,保留区域是否可靠、完成时间能否接受,才决定这套流程是否值得留下。框选如何表达修改要求,可接着看此前的FLUX 3 Image 框选编辑解读;那篇讨论母型号 API 的能力,本篇讨论新发布 Klein 的本地资源,两者不要混为一次发布。
如果只是先验证模型是否适合手里的素材,API 也是备选。官方指南列出的 1K 输出为每图 0.009 美元;这不构成与某套本地量化配置的同质量比较,也未包含本地硬件、耗电和返工成本。需要把图片送到外部扩写或 API 时,先核对素材能否离开本机,不能为了省显存绕过自己的数据边界。
权重许可也与“能下载”分开判断。公告列的是 FLUX Kommunity License,并概述了有条件的商业使用安排;本次未核完整许可条款,本文不据此给出商用资格或法律结论。
Klein 的变化,是让消费卡多了一条可评估的本地路径。真正该先做的选择却不是“8GB 还是更大”,而是哪些组件在哪里运行、哪些同时驻留、为哪一种图像任务验收。把这张执行顺序表写清楚,显存数字才开始有意义。