Cloudflare 的 155 个受影响响应:HTTP 200 没能证明租户隔离
Cloudflare 披露已修复的 Workers AI GLM-5.3 租户隔离事件:155 个响应受影响。把部署配置、SGLang 拒绝路径和 KV 页生命周期分开,才能知道成功响应之外还要验证什么。
长请求返回 HTTP 200,答案也连贯,却可能混入另一位用户的数据——Cloudflare 于 10 月 26 日披露的 Workers AI 事件,暴露了成功响应无法证明租户隔离的盲区。事故发生于 8 月 27 日至 9 月 9 日,9 月 9 日已修复并恢复服务,限定端点为 @cf/zai-org/glm-5.3,并非今天仍在泄露。按厂商调查,共有 155 个响应受影响;这个数字不是用户人数,也不是攻击次数。
真正值得拆开的,是系统怎样把一次本应拒绝的请求,一路交接成了“成功”。模型名称告诉我们哪个端点受影响;部署配置和推理引擎的错误路径,才回答为什么。
155 个响应的边界:已修复,未发现蓄意利用证据
在 Cloudflare 官方事故复盘中,所有受影响响应对应的提示都长于 681,280 token。它们可能包含其他客户稍早向同一模型提交的请求数据,不等于每份响应都泄露了一段完整会话。
官方时间线全部使用 UTC:9 月 8 日收到研究者报告,9 月 9 日复现并宣布安全事件,当天将模型转为私有、修正配置与引擎,再恢复公开服务。10 月 26 日是协调披露日,北京时间已是 10 月 27 日,不是事故起点。
Cloudflare 称,排除自己与研究者的测试后,识别出的请求在时间和数量上符合普通长上下文使用,未发现蓄意利用证据。这是其调查结论,不能改写成“已经证明无人利用”。官方也确认其他 Workers AI 模型未受影响;这个范围不延伸到其他平台或所有 SGLang 部署。
这些限定并没有削弱事件的重要性。对 API 用户而言,最容易被误认成安全证据的几个信号——状态码成功、有流式正文、答案看起来通顺——在这里可以同时成立,数据归属却已经出错。
百万 token 上下文,为什么装不进 KV 缓存池
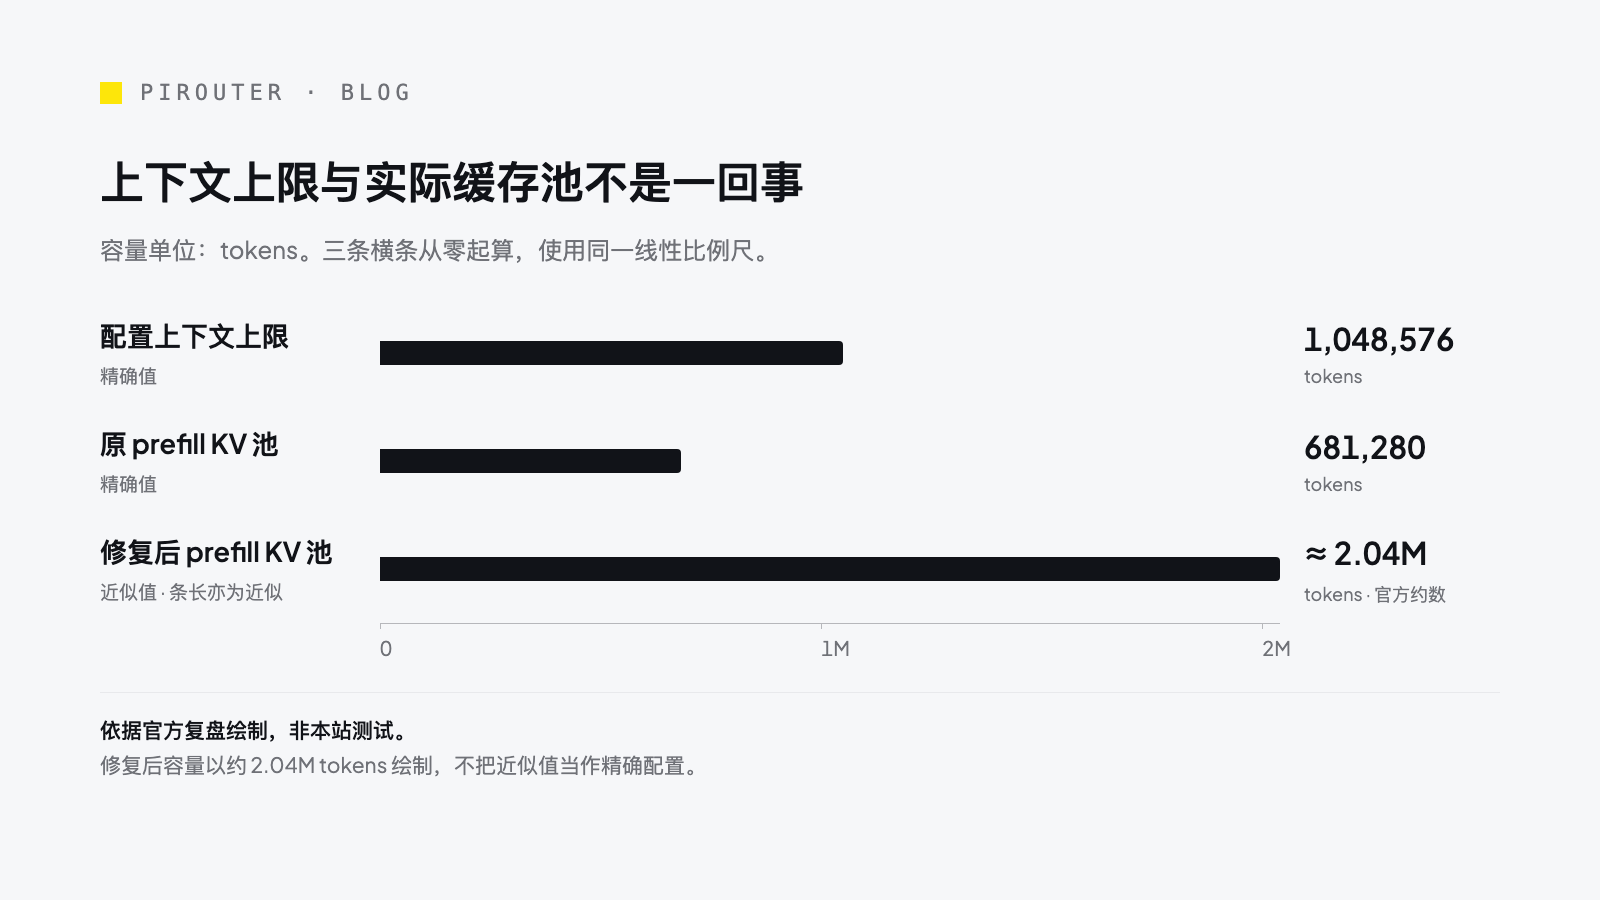
Cloudflare 为 GLM-5.3 配置的上下文窗口是 1,048,576 token,但 prefill GPU 上的 KV 缓存池只能容纳 681,280 token。两个数字出现在同一套服务里,却不是同一个开关。
KV 缓存保存模型处理上下文后供后续计算使用的注意力状态。这里说的不是账单上的 prompt-cache 折扣,也不是模型训练时记住的资料,而是推理时 GPU 内存里的工作数据。
在这套部署中,推理服务引擎 SGLang 启动时根据加载权重后剩余的 GPU 内存决定缓存池大小,上下文长度则单独配置。量化方式、并行配置或模型版本变化,都可能改变可用容量。宣传规格写着百万上下文,不会自动让运行中的池子装下百万 token。
可以把两者暂时理解成“允许接收多大的任务”和“现场实际有多少格子”。这个类比只解释容量,不能拿来替代后面的内存机制。工程上该核对的是引擎启动日志和指标里的实际池容量,而不是从一次请求成功倒推容量足够。
Cloudflare 承认上线前就知道两者不匹配,但长上下文压测拿到了成功状态码和没有错误帧的流式正文,于是预期引擎会妥善处理差额。其复盘明确指出,测试关注了响应码与性能,没有验证输出内容及连贯性。
容量不够,本来应该是一次清楚的拒绝。为什么最终变成了别人的内容?
SGLang 已拒绝请求,decode 为什么还读到了旧页
Workers AI 的这套服务采用 prefill/decode 分离:prefill 处理输入并生成 KV 缓存,再经 RDMA(远程直接内存访问,这里用于两端传输 KV 数据)传给 decode,由后者生成回答。两端必须对“请求是否还有效、传了多少数据、哪些页属于它”保持一致。
缓存池按固定大小的页分配和复用。官方说明,页在请求之间不会立即清零,而由下一次请求覆盖。页复用本身不等于跨租户泄露;安全依赖引擎正确跟踪页的归属,以及何时可以读、写和释放。
本次失效链条,可以沿着一次超出池容量的请求看清:
- 请求被拒绝,但没有被当作结束。 调度器记录了应返回给客户端的错误,并把输入替换成一个 token 的占位内容。交接队列检查的却是“是否完成”,拒绝状态没有让这项检查成立。
- 只写了占位数据,却报告交接完成。 prefill 对那个 token 做计算、传出对应缓存;decode 早已按原始长请求预留了页,收到完成信号后,以为这些页都被本次输入覆盖。
- 生成仍按原请求的长度读取。 结果是本次只写过的少量页面,与仍保留早先请求状态的页面,一起进入了后续计算。
官方复盘的分步说明用八页举例:本次只更新 P0,P1 到 P7 仍是旧状态。八页是解释用的布局,不是对所有受影响请求的固定页数统计。
于是客户端得到 HTTP 200,而非本应出现的 HTTP 400。连 prompt_tokens 都可以对应原始长输入,回答也可以连贯。连贯性检查有必要,却仍不能单独证明数据属于当前请求。
这条机制指向托管配置与推理引擎的状态交接,不支持“GLM 权重偷记了别人对话”或“模型厂商主动窃取数据”的指控。把两者混在一起,会让修复落到错误的层。
扩缓存、正确性修复与提前拒绝,是三件事
Cloudflare 首先调整部署,使 prefill 缓存池扩至约 204 万 token,大于配置的上下文窗口。这样,合法长度的请求就不会因池容量不足进入这条拒绝路径。这是有效的配置修正,但官方也强调,单靠池子够大很脆弱:下一次量化或并行配置改变,还可能重新改变容量。
引擎修复的时间线更容易被标题压扁。
SGLang PR #36988:退役已中止的 prefill 结果在 9 月 6 日就已合入上游;这不是 Cloudflare 的部署日期。原始说明针对视觉语言模型(VLM)编码器或嵌入校验失败后的清理,处理已中止请求的结果与资源所有权。Cloudflare 将其列为阻止本次暴露的修复:不能让已经中止的 prefill 结果继续走到 decode。它不是到 10 月披露时才出现的补丁。
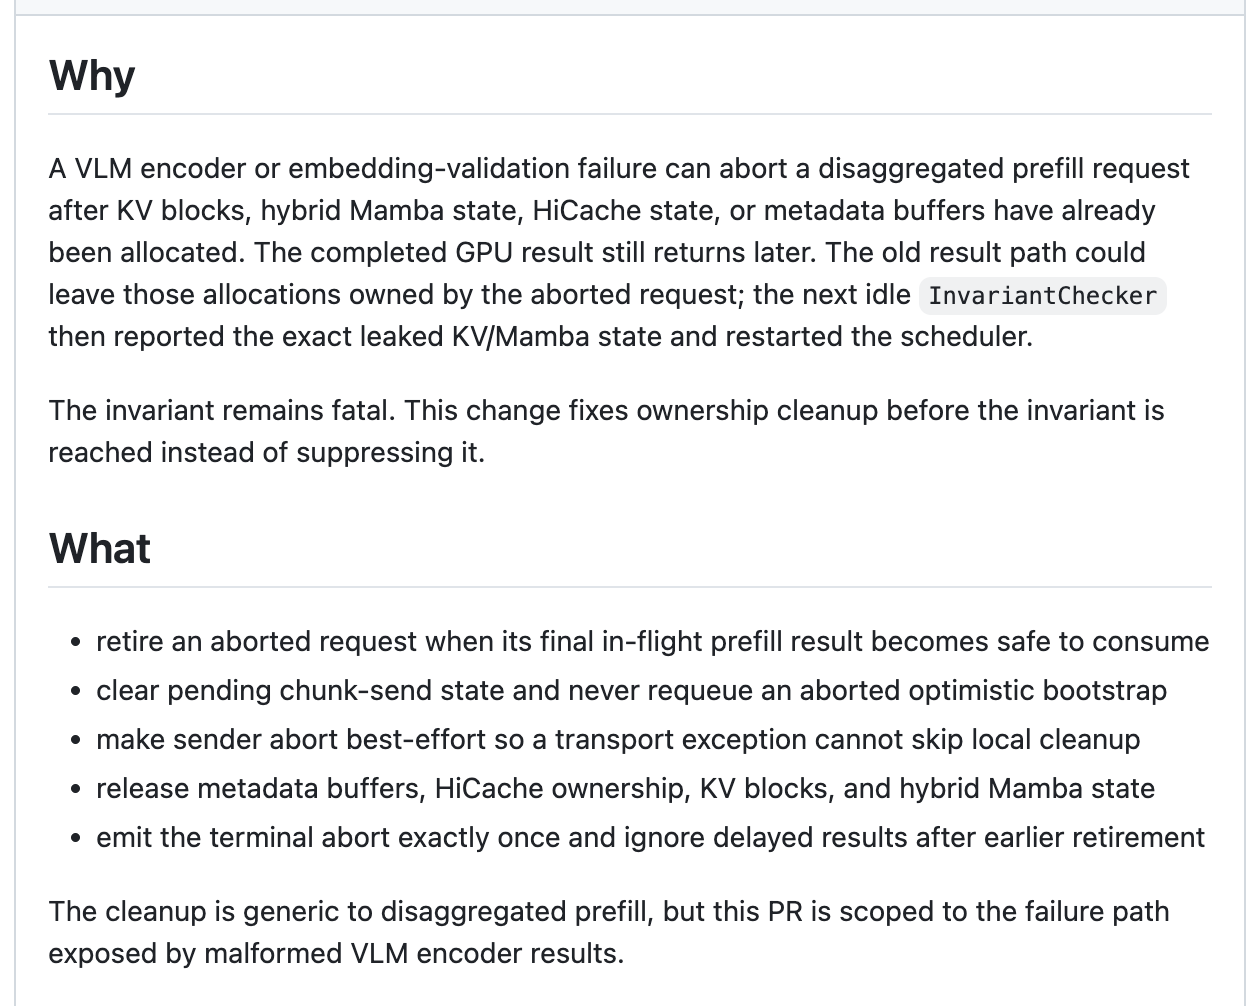
后续于 9 月 16 日合入的 SGLang PR #38935:阻止被拒绝请求进入 prefill/decode 交接,则把拒绝提前到准入阶段,避免继续做握手、分配和占位计算。当前 PR 说明明确写道,这是 “waste-and-latency fix, not a correctness fix”,即减少无用工作与等待,而非最初的正确性修复。
这份说明还纠正了自身早先的描述:旧缓存与错误状态码症状发生在 #36988 之前,不能在已有该修复的主分支上复现。因此,不能把“更早拒绝”和“首次阻止错误数据流出”写成同一件事,也不能仅凭 PR 编号更大就认定它才是真正修复。
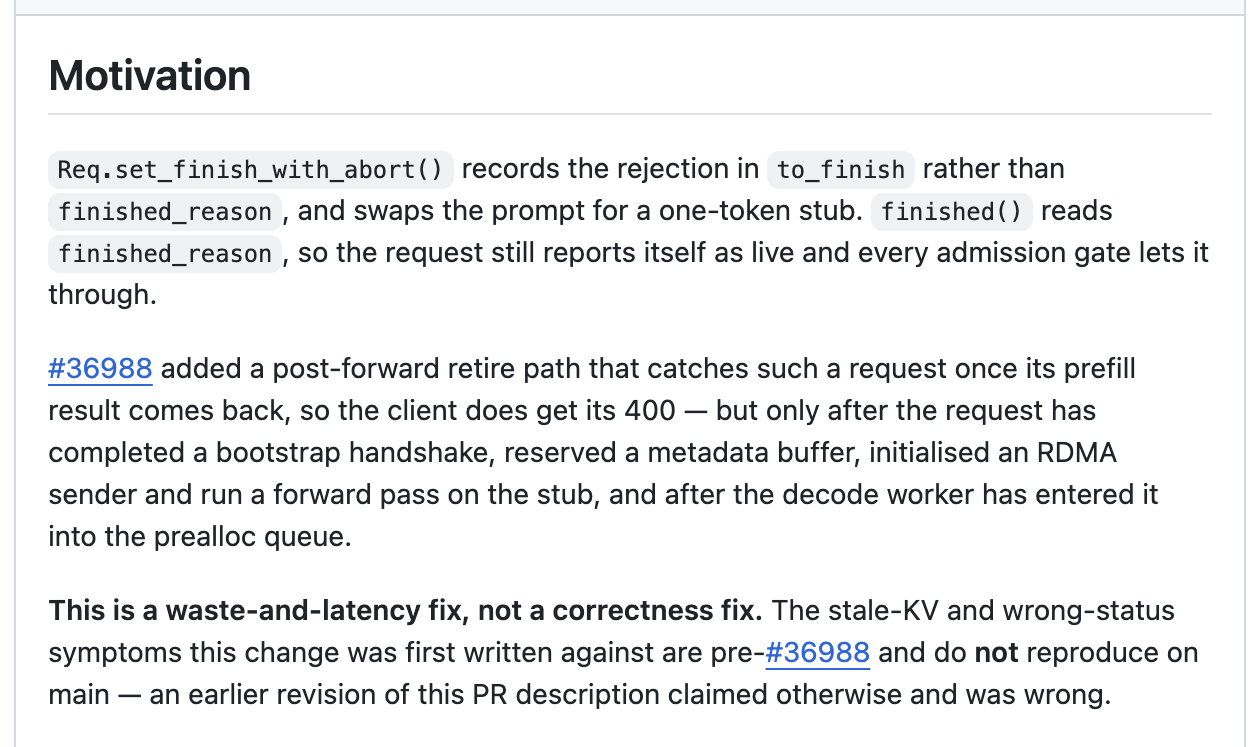
#38935 仍列有两端非对称拒绝时的等待限制,且没有声称做过准确率或性能基准。把这些边界一起读,才不会从一条已合入记录跳到“全部错误路径已证明安全”。
API 用户问影响范围,部署者查运行态与页生命周期
如果只是调用托管 API,先确认自己是否在事故窗口使用过那个精确端点,再向供应商询问影响评估、通知与修复说明。不要自行向生产服务发送超长输入来“试试看会不会串线”;没有看到异常,也不能反向认证隔离安全。
对自托管 SGLang、尤其采用 prefill/decode 分离的团队,官方建议可以归为几层不同的验收。
先核容量,再核版本。 每次权重、量化、并行方式或内存分配变化后,都要从每个 prefill 和 decode 节点的实际日志核对池大小与上下文长度;装不下就收缩配置。代理限长可以作为防线,但不能替代运行态容量核对。Cloudflare 建议升级到 v0.5.22 或以后,或按需回移相关补丁,同时确认构建实际包含所需修复。
再核取消与释放。 请求拒绝、客户端断连、传输失败,不只是 HTTP 状态变化。RDMA 已经发出的写入不能靠客户端取消收回;页过早释放再分给新请求,迟到的写入仍可能落进去。
官方建议两端使用延迟释放,并约束单次传输批量,使在途写入和释放等待之间有明确边界。代理的断连处理也要一起检查:取消路径不能绕过在途写入与延迟释放的协调。
最后核检测确实运行。 checksum(校验和)与 canary(哨兵检测)可以增加发现损坏的机会,但官方说明它们尚未覆盖每种模型架构,披露时仍在扩展的支持范围包括 GLM-5.3 本身。加上参数不等于已验证所有请求,要查日志确认适配与执行情况。
这些是不同层的证据,不能互相顶替。API key 轮换、零数据保留声明、多供应商故障切换,也不能证明 GPU 缓存页归属正确。
Cloudflare 还讨论了逐次读取时核验页标签与形式验证等方向,但页标签原型曾因可靠性问题关闭,不能当作已普遍部署的安全保证。本文依据公开复盘和上游说明整理,没有进行漏洞复现或独立部署审计;这里给出的是安全验收门槛,不是托管 API 与自托管的总成本比较。
这次事件留下的验收问题很具体:请求成功之外,系统如何确认它只读取了自己拥有的数据? API 用户需要供应商给出范围与处置证据;部署者需要把容量、拒绝传播和页生命周期放回同一条验收链。那才是 HTTP 200 没能回答的部分。