
Gemini 4 Argon 公开了,百万 token 得重新算预算
Gemini 4 Argon 进入公开付费 API 与订阅入口,但百万 token 由输入、思考和输出共享。对照官方原始文档,分清 Pro 与 Ultra 权限、65536 默认上限、后台长输出、续段缓存计费,以及11月30日优惠结束后的预算。
Google 于 10 月 13 日宣布 Gemini 4 Argon 进入公开访问阶段。现在可以通过付费 API 和指定订阅入口使用,但这不是全民免费开放。它的 1,048,576 token 窗口由输入、思考和输出共同占用,要让 Interactions API 生成超过默认的 65,536 token,还得开启后台执行并显式提高生成预算。
这次值得重新做决定的,不是再看一次模型排行榜,而是终于可以把能力放进自己的工作计划:哪种账号能进,已有代码是否需要改,长任务走到一半时还剩多少空间,以及它继续思考的每一段会怎样进入账单。
下文依据 Google 公开发布公告、模型规格与开发者原始文档。官方案例只按官方披露呈现;这里没有本站亲测,也不把最大规格当作任务成功保证。
谁能用 Argon:API、Pro 与 Ultra 要分开看
先把“公开”拆开。对开发者,公告列出的主要路径是 Gemini API paid tier,通过 AI Studio、Android Studio 等入口构建应用;公开模型 ID 已写成 gemini-4-argon。对日常用户,公告明确列出 Google AI Pro 和 Ultra 订阅者可在 Gemini app 和 Search 的 AI Mode 使用。Google Antigravity 的订阅访问则列给 Ultra。
这不是一张可以在所有产品之间通兑的票。订阅里能选到模型,与应用拿 API key 调用模型,是两种使用安排。不要因为买了 Pro,就按 API 已免费包含在内设计自己的后台服务;也不要把 API 的每百万 token 报价当作 app 的单条提问价格。
| 要做的事 | 公告给出的入口 | 不应顺带推定的权益 |
|---|---|---|
| 在自己的应用调用 Argon | Gemini API 付费层 | 免费层可调用、订阅自动抵扣 API 账单 |
| 在 Gemini app 或 Search AI Mode 使用 | Google AI Pro / Ultra | 所有账号已有相同额度或所有地区界面一致 |
| 在 Google Antigravity 使用订阅权益 | Google AI Ultra | Pro 自动获得同一入口 |
| 作为研究者申请资助访问 | 申请科研项目 | 填表即可立即免费使用 |
两份官方页面目前存在表述不一致。 发布公告把 Pro 列入 app 与 Search 的开放范围,Gemini Developer API pricing — Gemini 4 Argon 却写着模型不在 Free tier 或 Google AI Pro plan 中,且没有解释这个限制与公告中入口的关系。本文分别保留两页原意,不把“产品语境不同”当作官方已经确认的解释,也不据此认定 Pro 包含 API 权益。购买订阅前,仍须核对对应产品的实际入口与额度。
Google 还开放了科研申请,计划让 10,000 名科学家免费获得 Antigravity 最高使用层六个月,但按批次接入,受资格、容量与筛选限制。网络防御者的 Fairwind 项目同样是申请路径;它涉及的特殊网络安全版本,不是普通公开 API 自动附送的权限。
因此,对尚未订阅的人,第一步是确认工作发生在哪里。只想在 app 里分析材料,先核对 Pro 的模型入口与额度;要把模型接进服务,先核对付费 API。把两者混在一起,会在还没开始长任务前就买错访问方式。
百万 token 是共享窗口,不是读百万再写百万
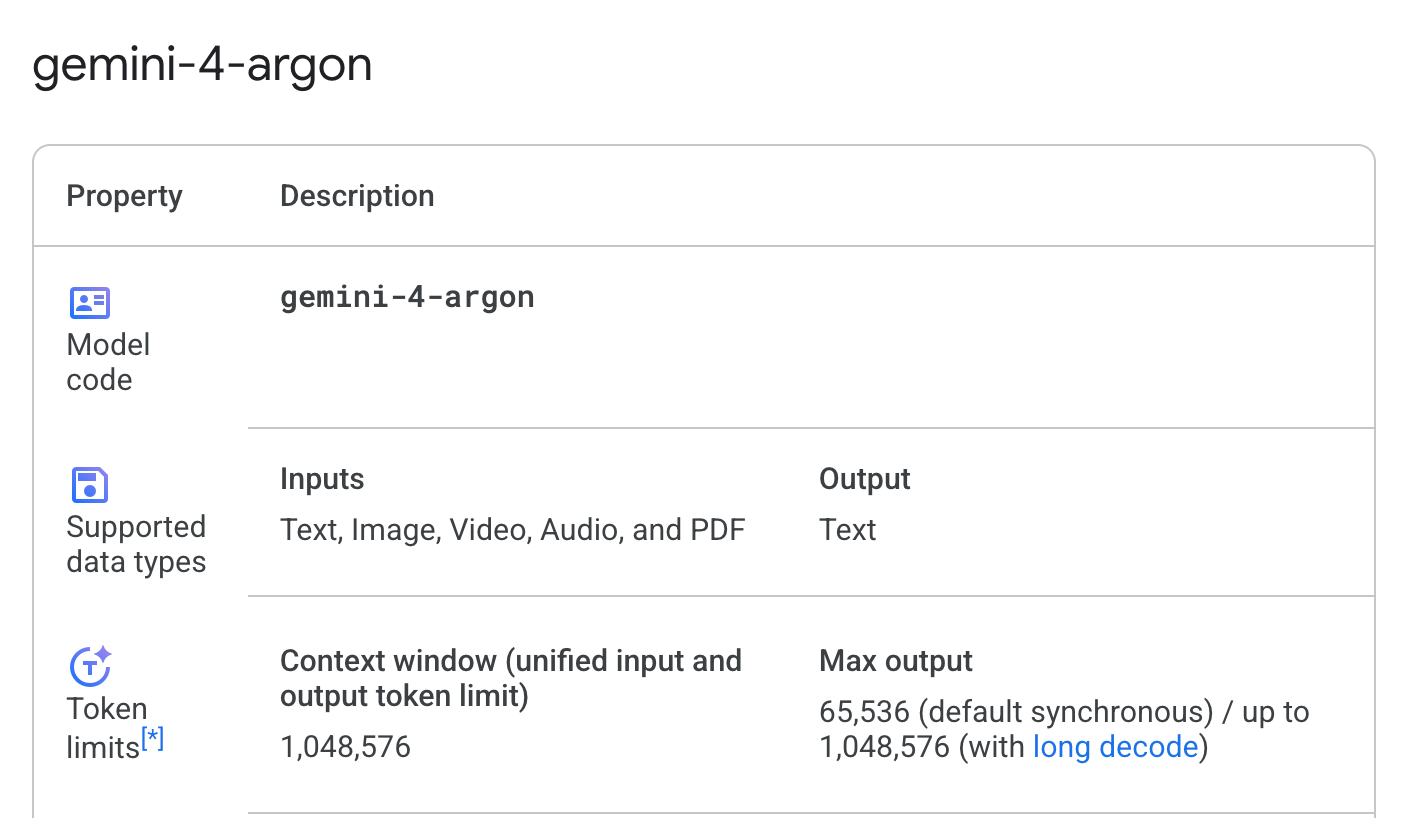
Gemini 4 Argon 模型规格 使用的是 unified input and output token limit。Long decode — How long decode works 再把含义说清:输入、思考、输出共享 1,048,576 token。
token 是模型处理内容的计量单位,不等于字符或字数;实际材料占多少,应以模型对应的计数结果为准。
设想你交给模型一个很大的代码项目,再要求它推导优化方案、生成修改与验证说明。代码已经占去空间,模型后续的思考和回答也要占空间。这个窗口不是“材料箱一百万,答案箱另有一百万”,更不是一百万汉字的固定容量。
按文档的预算关系,输入如果占 800,000 token,剩余思考与输出合计最多 248,576 token;输入如果占 1,000,000 token,剩余合计只有 48,576 token。这些是按规格做的减法,不是本站测得的实际可用长度。请求本身需要容纳的指令、历史与其他内容也不能忘记计入输入。
一个大文件能放进去,并不意味着模型还有足够空间把它处理完。对于复杂证明或大型代码改造,先减少不相关材料,可能比把生成上限拉到最大更有效:你给它腾出的,不只是写答案的位置,也是探索和检查的空间。
max_output_tokens 的名字也容易误导。这里的 interaction 可以理解为一次任务记录,后台续段仍归在同一个任务 ID 下;该参数约束的是整条 interaction 的 思考加输出,不是用户最终能看见的文字数。假设你设置了 262,144,模型可能把相当一部分用于思考,然后给出很短的答案;这与设置了更大篇幅却没有“写够字数”是不同的问题。
共享窗口还改变了评估方法。比较两个任务时,不能只记录最终回答长短,也要看输入规模、思考消耗和终态。一个答案更短的任务,完全可能使用更多计费 token。反过来,模型没有用完预算也不说明它失败:预算是允许它使用的上限,不是必须完成的输出指标。
默认 65,536:换了模型,后台不会自动打开
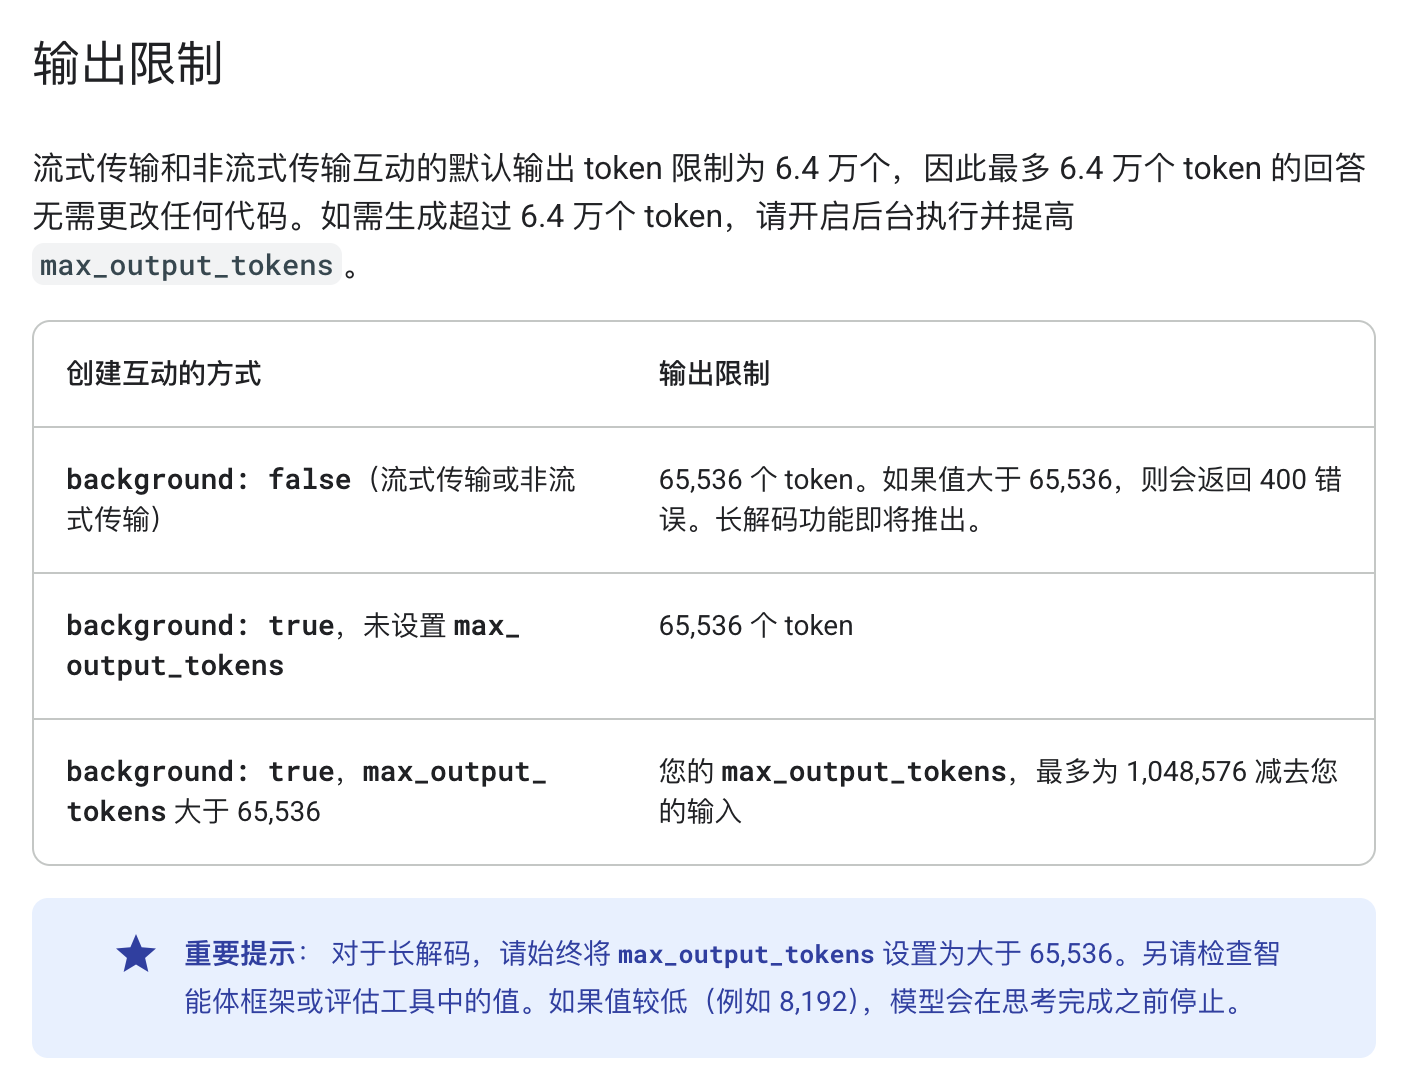
如果现有应用只是把模型名换成 gemini-4-argon,并不会自然获得百万级生成。官方 Long decode — Output limits 给出的 Interactions API 默认行为很明确:无论流式还是非流式,默认生成上限都是 65,536 token。
超过这个值需要两个条件一起成立:background: true,以及 generation_config.max_output_tokens 大于 65,536。只开启后台、却没有设置更大的预算,仍停在默认上限;不启用后台却把预算写大,则会返回 400 错误。后台执行还要求 store: true,不能一边选择后台路径,一边明确禁用服务端存储。
下面是依据官方字段整理的请求配置片段,展示条件关系,不是本站执行记录:
{
  "model": "gemini-4-argon",
  "input": "Analyze the supplied problem and check the proposed solution.",
  "background": true,
  "store": true,
  "generation_config": {
    "max_output_tokens": 262144,
    "thinking_level": "high"
  }
}
262,144 也不是所有任务的推荐默认。文档建议,较长编码与 agent 工作先从 65,536 开始;困难数学、科学和证明可以从后台 262,144 起步,再在剩余共享空间内调整。对大多数编码与 agent 工作,默认的 medium 思考档位更合适,最困难推理才考虑 high。
还要检查模型调用外面那层框架。你给 API 放开了空间,框架或评估工具却仍把上限设成 8,192,任务照样可能在思考尚未结束时被截断。调试“Argon 为什么不输出”时,先查实际送出的参数与 incomplete 状态,比在提示词里反复要求“继续”更有用。
如果不允许服务端存储,官方另列了 GenerateContent 的客户端续段路线,由 SDK 或应用启动下一段;它不是同一套默认规则。文档表中这条路线是每条流 64K、每个非流式请求 32K,运行时间列为二十分钟;Interactions 后台则可运行到二十四小时。Interactions 的客户端续段还写着即将提供,不能提前当作已上线。
长输出变成后台工作,完成状态比连接不断更重要
long decode 不是一次请求突然吐出百万 token。官方描述是模型每次生成最多约 64K,服务器把后续段接到前段停止的位置,一直推进到模型完成或预算用尽。每一段在同一个 interaction ID 下新增一个 model_output step。
应用因此要保存 interaction ID,并通过轮询或流式接收取得进展。拼接答案时,按顺序遍历 interaction.steps,取出 model_output 中类型为 text 的内容。官方特别指出 REST 响应没有一个可直接取用的 output_text 字段;只拿最后一段,也不是完整答案。
后台终态也不能统统叫“已完成”。completed 表示模型结束,可以整理结果与 usage;requires_action 表示它请求工具,应用仍需执行并回传结果;incomplete 表示预算用尽。如果预算全用于思考,最后甚至可能没有正文。这时应检查预算与思考档位,不是把空字符串包装成一次成功交付。
failed 与 cancelled 同样要落到任务状态里。后台可以运行很久,并不表示客户端应等到二十四小时才介入。对有费用上限、任务期限或人工审核要求的系统,应设置自己的停止条件;官方取消接口停止后续执行,但不会抹掉已经完成工作的费用。
流式长任务还需要重连设计:保存每个 event_id,包括状态更新事件中的 ID,重连时用 last_event_id 续接。重连后先读完补发事件,再检查终态;即使任务已完成,服务器也可能仍在补发之前遗漏的事件。文档提醒,首个 64K 之后,输出可能按约 5,000 token 的批次到达,中间停顿是预期行为。这个描述不是固定速度承诺,不能因此预先保证某项工作几分钟完成。
对用户界面而言,变化很具体:从“聊天气泡还没回完”变成“后台任务正在推进”。任务是否还在运行、是否等待工具、是否被截断,应该能被看见。连接断开只是传输事件,不能自动等同于模型停止;把它直接重试成新任务,还可能产生重复工作和额外费用。
每段输入都计费,累计输入不是占窗大小
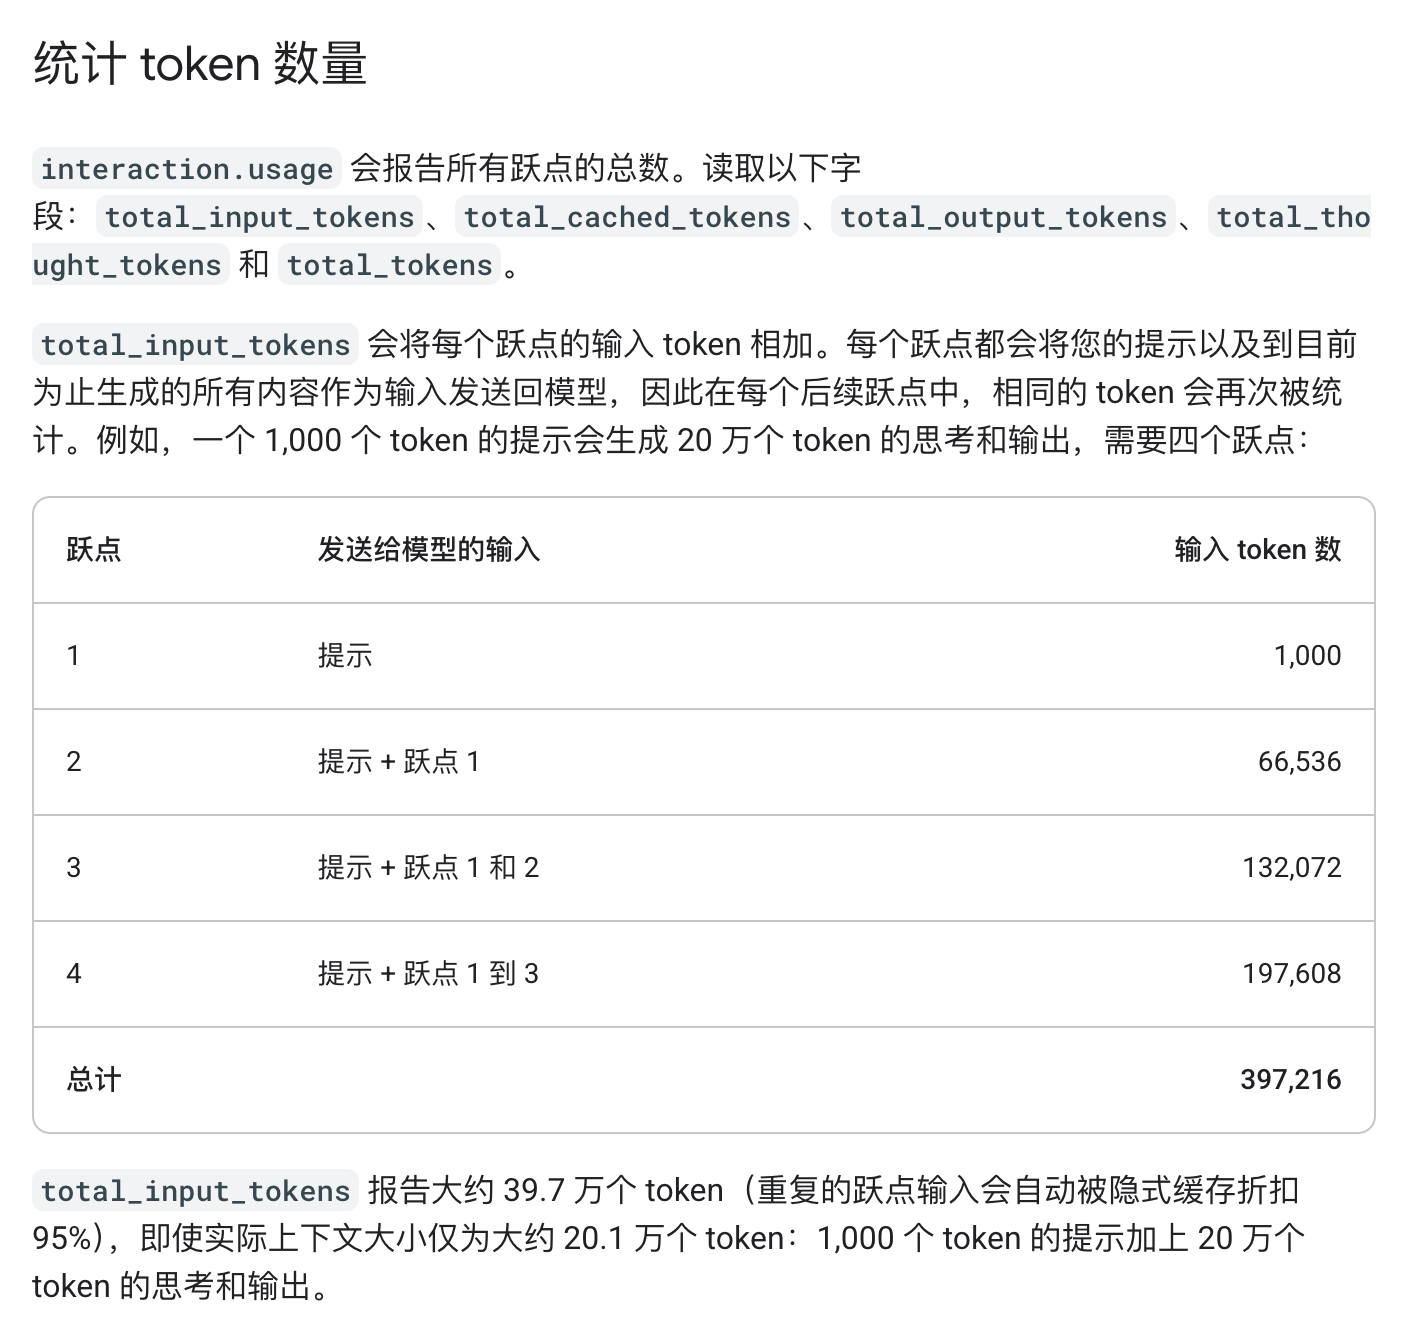
预算最容易算错的地方在续段。文档写明,每个后续段都会把原始提示和之前已生成的内容重新送入模型。因此 total_input_tokens 累计的是 所有段输入之和,不是此刻上下文里放着多少东西。
Long decode — Count tokens 给了一个可以逐项核对的例子:提示为 1,000 token,后续一共生成 200,000 token 的思考与输出,需要四段。
| 段 | 此段送入的内容 | 此段输入 token |
|---|---|---|
| 1 | 初始提示 | 1,000 |
| 2 | 初始提示 + 第一段生成 | 66,536 |
| 3 | 初始提示 + 前两段生成 | 132,072 |
| 4 | 初始提示 + 前三段生成 | 197,608 |
| 合计 | 四段分别计量后相加 | 397,216 |
实际占用共享窗口的内容却约为 201,000 token:初始 1,000,加生成的 200,000。你没有因为累计输入到了 397,216,就用掉那么多独立的上下文空间;同一批内容在续段中被重复计量了。
这会影响两项不同决定。判断是否该压缩上下文,要估算提示大小,加 total_output_tokens 和 total_thought_tokens;判断要付多少钱,则要区分累计输入里哪些按普通输入收费、哪些按缓存输入收费。把同一个数字同时当容量和费用指标,会过早压缩历史,也可能算错长任务成本。
官方说明续段的重复输入通过 implicit caching 获得 95% 折扣。Argon 只支持隐式缓存,不支持显式缓存,因此不能按“先创建一个固定缓存对象,以后所有内容都保证命中”的方式理解。模型规格上的支持能力,与某次调用实际记录的缓存计量仍要分开;核账时应读 total_cached_tokens,不能只看到缓存单价便把全部输入都套进去。
还有两条容易漏:只有思考、没有可见文字的段也计费;取消或失败之前已经完成的工作也计费。流式事件中的 usage 是累计值,读取最新一次即可,不要把每次更新继续相加。那样算出的不是更完整的账单,而是重复累计的账单。
11 月 30 日优惠结束,12 月 1 日要重算
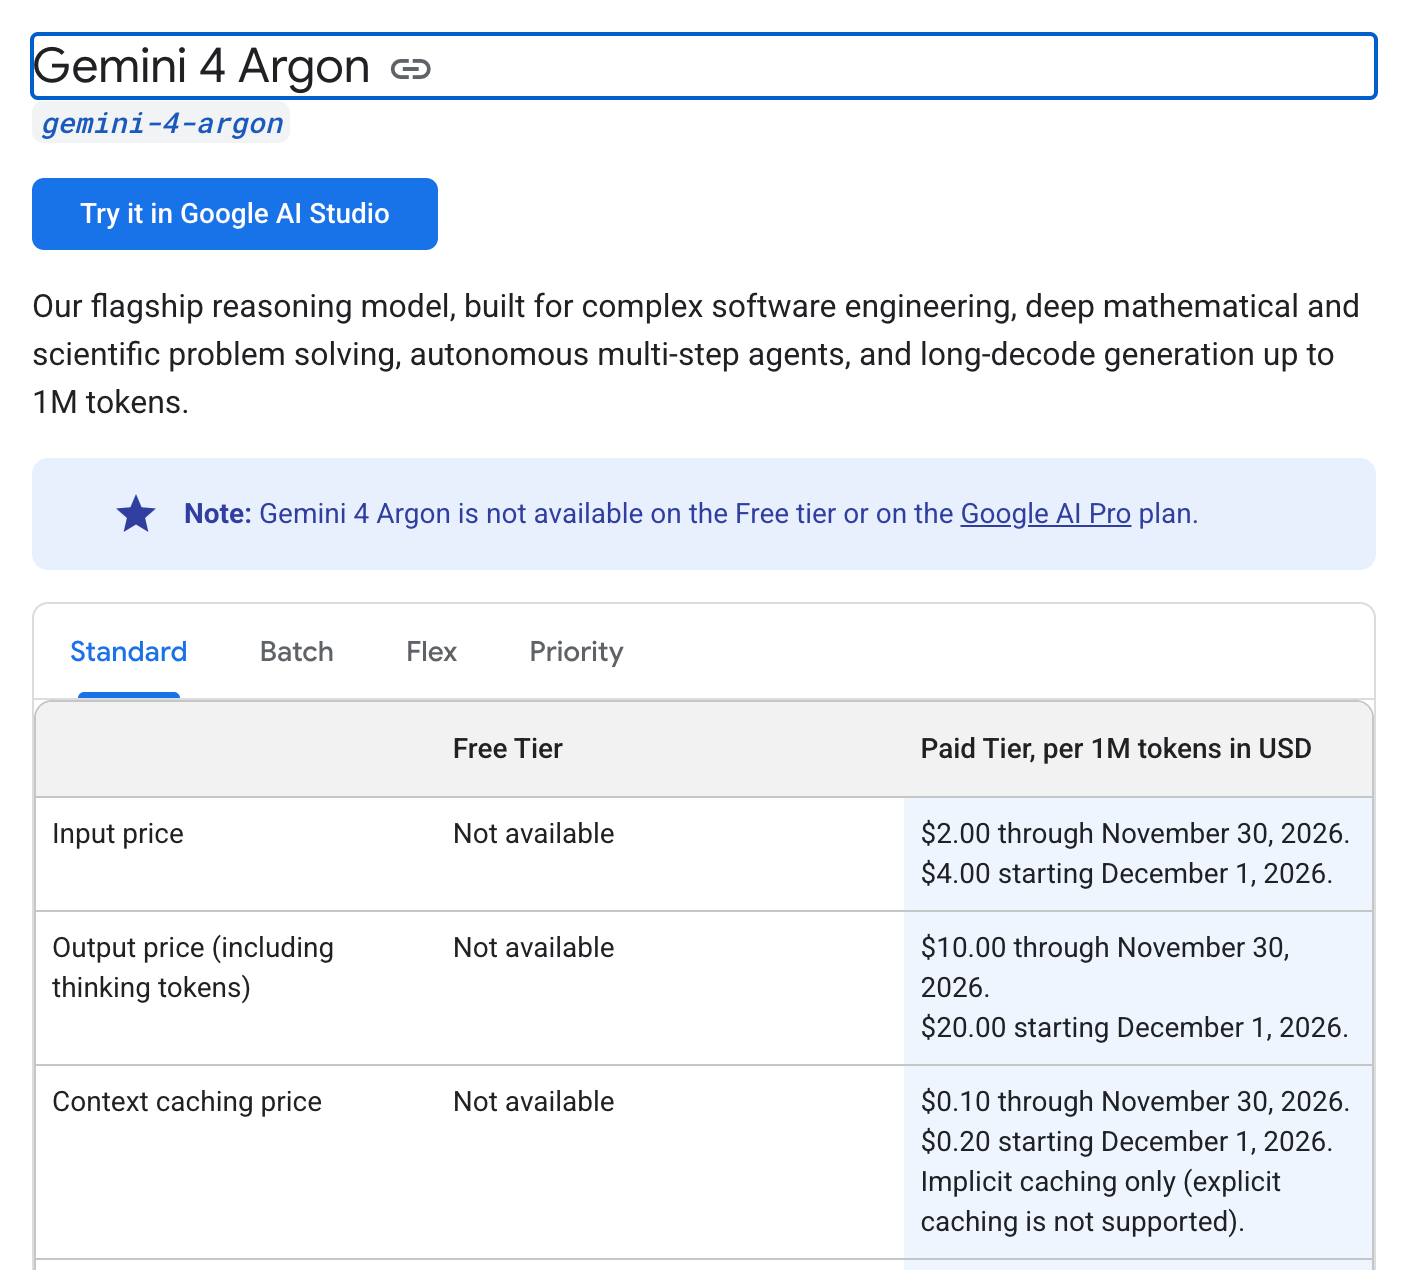
公开后的定价已经有明确日期。以下是 Standard 档、美元/百万 token,不是消费者订阅价格,也不是其他服务档的混合报价。
| 计费项目 | 截至 2026-11-30 | 自 2026-12-01 起 |
|---|---|---|
| 普通输入 | $2 | $4 |
| 输出,包括思考 | $10 | $20 |
| 缓存输入 | $0.10 | $0.20 |
Argon 价目条目未单列缓存按小时存储价,且不支持显式缓存;这与后台 interaction 必须启用服务端存储不是同一概念。本文算例只计算已列出的 token 费用,不据此推断后台存储免费;数据保留条件与其他适用收费,应在上线前核对对应服务条款。
三项单价都翻倍,缓存相对普通输入的折扣比例没有因此消失。对持续运行的研究或编码流程,优惠期间测得的成本可以帮助探索任务,但不能直接当作十二月预算。时间点明确之后,值得保留的是 token 消耗结构,而不是把一张引入期账单长期复制进成本模型。
沿用上面的官方四段例子,做一笔编辑换算:假设首段 1,000 输入按普通输入计费,后面三段合计 396,216 输入全部按缓存输入计费;200,000 思考加输出按输出价计。无工具费、税费、外部调用或失败重试。
引入期算式为 1000 / 1000000 × 2 + 396216 / 1000000 × 0.10 + 200000 / 1000000 × 10,约 $2.0416。到了十二月一日,相同计量与相同缓存假设约 $4.0832。
若用全部累计输入都按普通输入收费的对照口径,引入期约 $2.7944,十二月约 $5.5889。这个对照只是展示缓存计量为什么影响预算,并非说官方续段默认不使用缓存,也不是一次任务必然出现的上下界。真实核账仍以实际 usage、服务档与收费记录为准。
同样重要的是,在这一例子里,绝大部分费用来自思考与输出。95% 的缓存输入折扣,不能被写成“整个任务便宜 95%”。缓存减掉的是对应输入费用,不会把 200,000 的生成费用一起打折。任务换成更大初始输入或更多段时,各部分占比又会变化,不存在一个对所有长任务有效的节省百分比。
价目页也列出 Batch、Flex、Priority,但“后台继续生成”不等于自动切换成 Batch 或 Flex 的优惠档。服务选项与续段机制是两个维度。如果需要 Search、Maps grounding 等能力,还应另查对应工具收费;此处算例没有把这些费用悄悄包进 token 单价。
哪些任务值得更长思考,哪些只会更慢
公开公告列了新的复杂工程案例,包括 Chrome 大规模架构重构、ADK 性能优化,以及多步三维场景制作。这些都是 Google 披露的工作与展示,不是本站拿自己的项目复测过的结果。它们有助于理解长任务的形状,却不能证明任意开发者把预算改大,就获得同样收益。
假设你正在整理一个优化方案,需要探索几种改法,交叉检查约束,再给出完整实现。当前任务总在生成预算耗尽时截断,且输入仍留有足够空间,这才是试长 decode 的合理起点。如果模型的问题是理解错需求、调用错工具,额外思考空间未必解决错误,甚至可能只是让错误继续得更久。
官方使用建议同样收得很窄:困难数学、科学、研究、形式化证明,以及少数最难编码任务,可能需要超过 64K 的单次思考与输出。多数聊天、问答、摘要、分类、抽取远不需要这么长。频繁短轮工具调用的 agent 也不是每轮都该长生成;连续大输出会很快填满共享窗口。
“请写一部七十万词的书”也不是合适的验收方法。文档明确说明模型不保证 token 数或字数目标。长 decode 留出的,是解决难问题时继续探索的空间,不是一台按字数精确交货的印刷机。
多模态能力也要按规格判断:Argon 可接收文本、图像、视频、音频和 PDF,模型输出是文本;它本身不支持图像生成或音频生成。公告里的游戏与场景案例会组合其他工具和模型,不能把最终成品的所有能力都算到 Argon 的单次文本输出头上。
公开可用之后,先验收一件具体工作
对于开发者,一个稳妥起点是挑一件已有验收标准、输入规模可控的工作。先确认付费 API 与模型 ID,再保持原有生成预算记录基线;只有观察到预算截断确实妨碍完成时,才开启后台并扩大空间。同时记录终态、可见答案、思考消耗、缓存计量、耗时与服务档。
要比较的是任务有没有做对、花了多少时间与钱,而不是谁用掉了更多 token。把优惠结束后的同一消耗结构重算一次,再决定要不要进入持续流程;对敏感材料,先确认后台所需存储是否符合自己的约束。
对 app 用户,判断可以更简单:确认自己的 Pro 或 Ultra 入口能否使用,再拿一件真正需要多步分析的工作观察结果,不必把 API 的百万规格当作订阅中的承诺。Argon 公开之后,值得兴奋的变化是终于有条件验证它;值得保留的克制,是不把访问权、最大空间和实际收益混成一件事。