
Claude Haiku 5.5の料金は10万トークンで変わる:75%安いという数字の条件
Haiku 5.5の短文向け単価と10万入力トークン超の単価は、超過分だけでなくリクエスト全体で切り替わります。キャッシュ、tokenizer、effortの条件を公式資料から読み解きます。
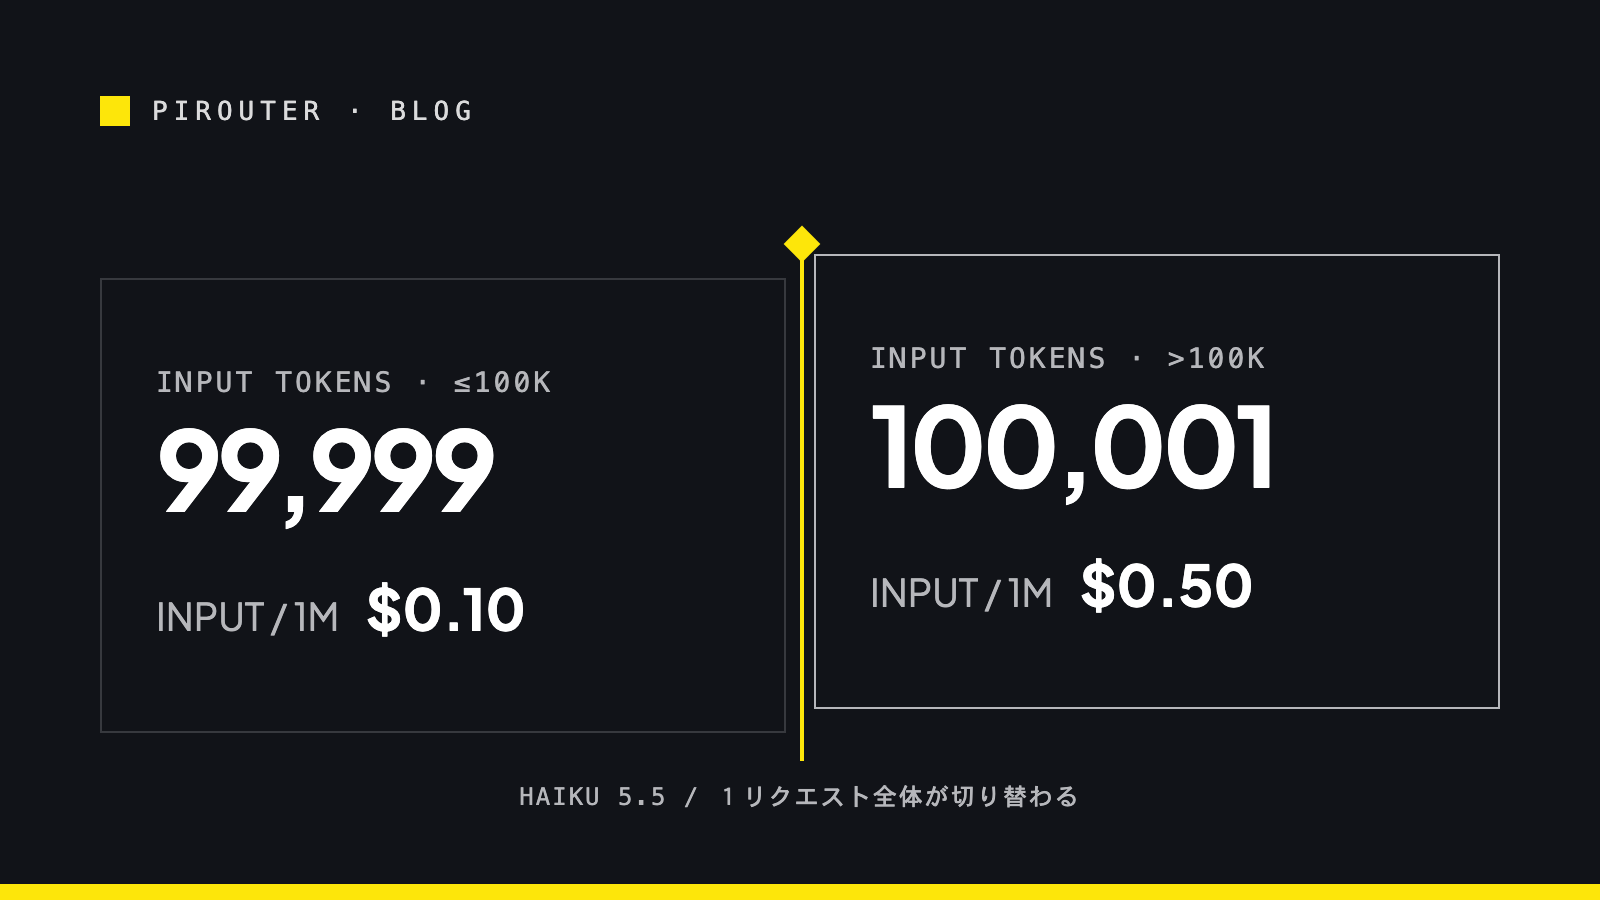
Claude Haiku 5.5では、入力が10万トークンを1トークンでも超えると、超過分だけでなく、そのリクエスト全体に高い方の単価が適用されます。Anthropicが発表した「平均で約75%安い」は、全件に適用される割引率ではありません。旧モデルのリクエスト分布と、同じ文章を数え直したときのトークン数まで含めた、同社による平均費用の説明です(Claude Haiku 5.5発表、Pricing — Long context pricing)。
たとえば、定型の問い合わせを分類する処理と、添付文書や過去の対話を丸ごと渡して分類する処理。返す答えが短くても、入力の長さは大きく違います。大量の小さなリクエストには魅力的な価格ですが、長文処理も同じ単価だと思って見積もると、請求の境目を見落とします。本稿はAnthropicの直販APIの米ドル建て価格を読み解くもので、当サイトでの取り扱いや独自の負荷試験を報告するものではありません。
10万を1トークン超えたら、請求はどこから変わる?
Anthropicの価格表が示すHaiku 5.5の基本単価は次のとおりです。単位はいずれも100万トークンあたりの米ドルです。
| 1回のリクエストの入力長 | 通常入力 | 出力 | キャッシュ読み込み | 5分キャッシュ書き込み |
|---|---|---|---|---|
| 10万トークン以下 | $0.10 | $0.50 | $0.01 | $0.125 |
| 10万トークン超 | $0.50 | $2.50 | $0.05 | $0.625 |
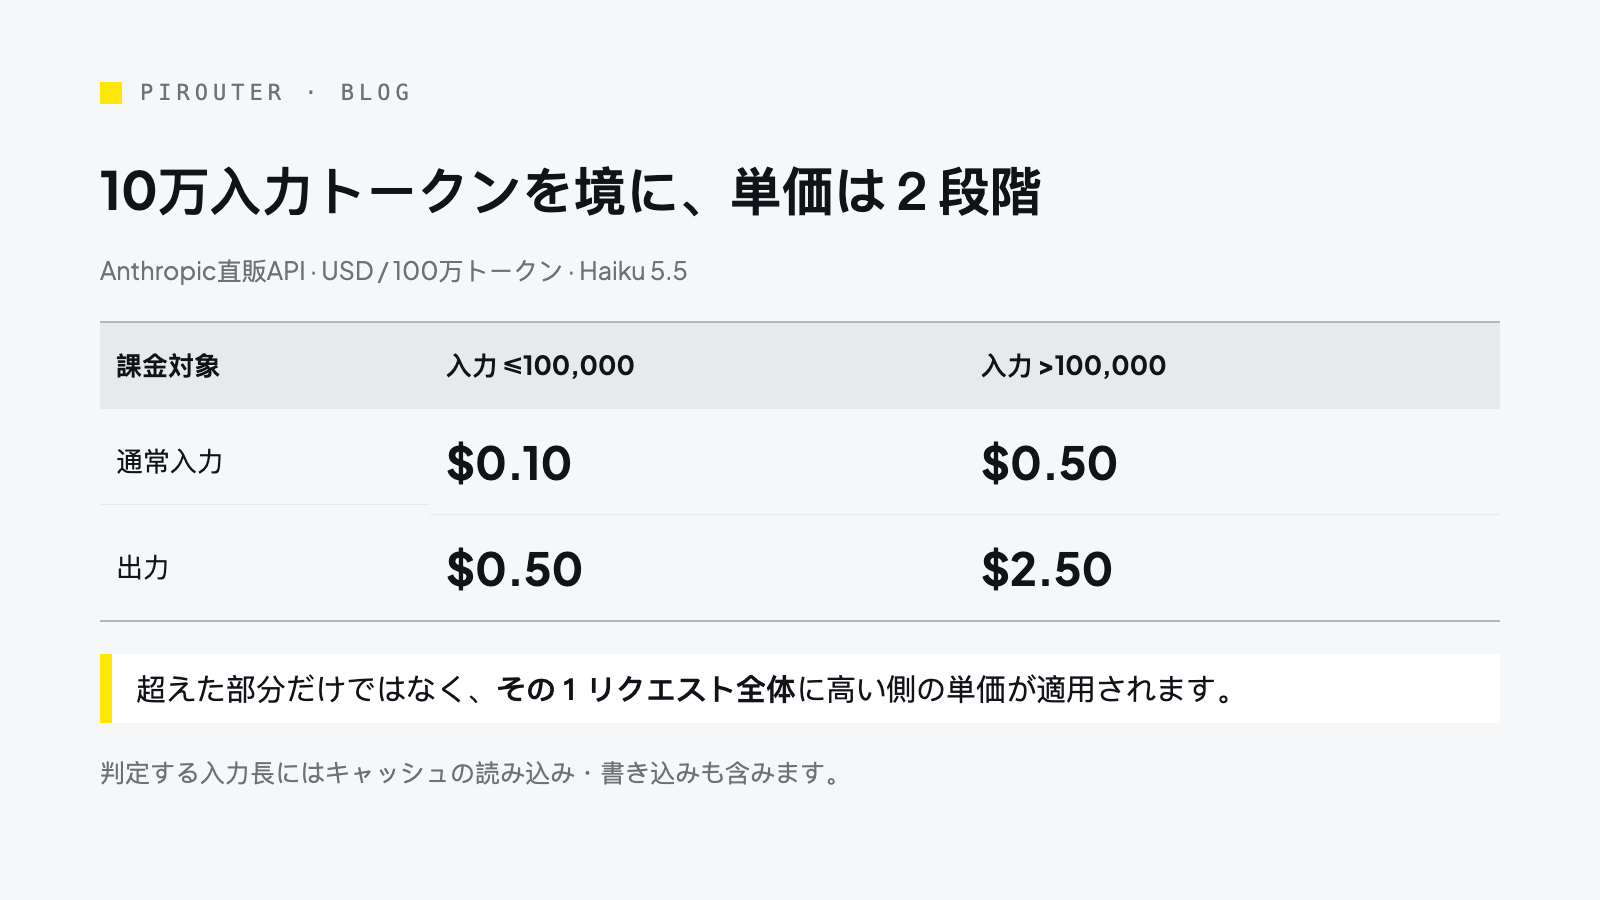
境目の判定に使うのは出力長ではなく入力長です。しかし境目を超えたあとは、出力も高い方の単価になります。「10万トークン目までを安く、超えた部分だけを高く」という段階課金ではありません。文書は「各リクエストを個別に料金判定する」とも明記しています。今回長くなっても、それより前に処理済みのリクエストに料金が遡及するわけではありません(Pricing — Long context pricing)。
境界の形を一組の仮定による計算で確かめましょう。Haiku 5.5で計数済みの入力が99,999トークン、出力が1,000トークン、キャッシュも追加の有料機能も使わないとします。通常入力は $0.0099999、出力は $0.0005、合計 $0.0104999 です。別の独立したリクエストで入力が100,001トークン、出力は同じ1,000トークンなら、入力は $0.0500005、出力は $0.0025、合計 $0.0525005 になります。これは上記の公式単価からの当方計算で、実リクエストの請求例ではありません。
入力が2トークン違うだけで合計が大きく離れるのは、単価を選ぶ単位がリクエスト全体だからです。ただし、いまの二例から「Haiku 5.5は常に5倍になる」とは言えません。短い入力の仕事、出力の長さ、キャッシュの利用割合が違えば、実際の合計も変わります。境界に近い業務ほど、平均文字数ではなく、リクエストごとの入力分布を見たいところです。
キャッシュヒットでも、10万の判定から消えない
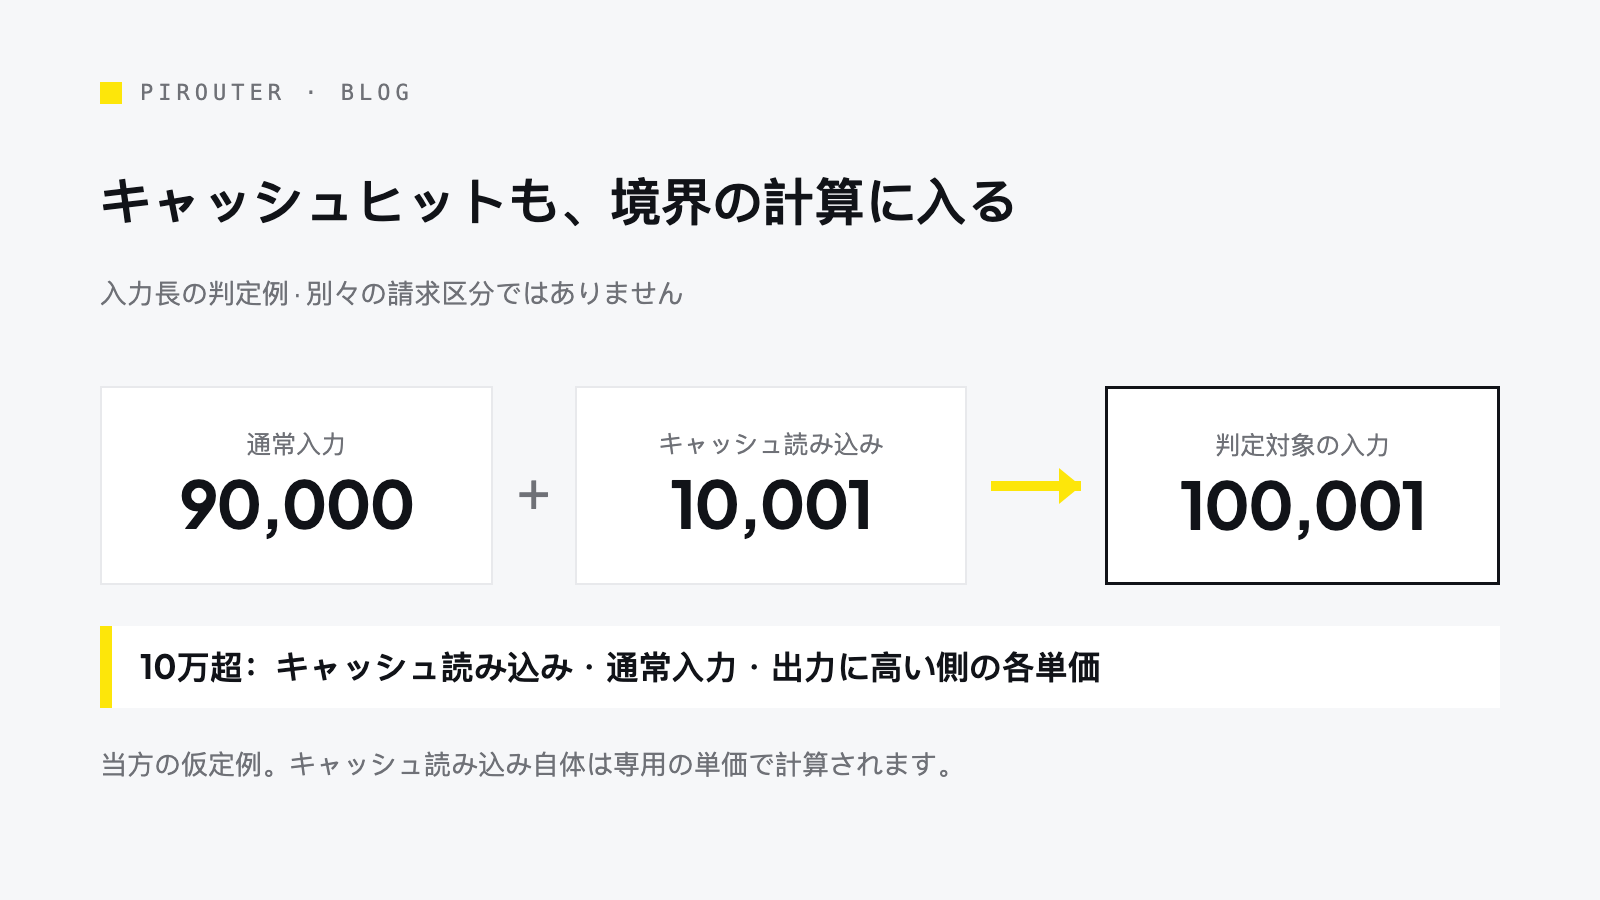
長い文書を繰り返し参照するならキャッシュで安くなるはず、という発想は自然です。実際、短い側のキャッシュ読み込み単価は通常入力の10分の1です。けれども安く請求されるトークンは、入力長の判定から除外されません。公式の長文料金規則は、キャッシュ読み込み・書き込みのトークンも入力長に含むと定めています(Pricing — Long context pricing)。
仮に通常入力が90,000トークン、キャッシュから読んだ部分が10,001トークンなら、判定対象は合計100,001トークンです。ヒットした10,001トークンには長い側のキャッシュ読み込み単価が適用され、通常入力と出力も同じリクエストの長い側で計算されます。キャッシュが役に立たないという意味ではありません。同じ料金区分内では読み込み単価が通常入力より低いままです。ただ、キャッシュで「10万の壁を回避する」という見積もりは成立しません。
もう一つ混同しやすいのが「最短512トークンからキャッシュ可能」という変更です。Haiku 4.5の4,096トークンに対して、Haiku 5.5では短い共通プロンプトも設定すれば対象になります(What’s new in Claude Haiku 5.5)。これは毎回無条件でキャッシュが有効になるという意味ではありません。Prompt cachingは、トップレベルの cache_control を置く自動キャッシュと、ブロックに明示するブレークポイントを案内しています。どちらの方式でも、対象になることと実際にヒットすることは別です。
検算するときは使用量に出る通常の input_tokens だけで判断せず、cache_read_input_tokens と cache_creation_input_tokens も合わせます(Prompt caching — Usage)。定型の指示文を短くできたとしても、ツール定義や対話履歴が増えれば判定対象の入力は増えます。キャッシュは適用される課金カテゴリを変えますが、閾値は通常入力・キャッシュ読み込み・書き込みの合計で判定します。安く読めても、そのトークンが10万の判定から消えるわけではありません。
「約75%安い」は、どの仕事の平均か
Anthropicの発表では、Haiku 4.5の通常入力 $1.00・出力 $5.00/100万トークンに対し、Haiku 5.5の短い側はそれぞれ $0.10・$0.50。**同じトークン数を前提にした価格表上の差は90%です。長い側の $0.50・$2.50 なら50%**です。これと「平均75%安い」は別の数字で、どれか一つをすべての仕事の割引率として使うことはできません。
同社の脚注は、旧モデルHaiku 4.5へのリクエストの約90%が当時10万トークン以下だったと説明します。Haiku 5.5で再計数した後も同じ比率になるとは示していません。その分布に加え、モデル更新で同じ仕事を処理するときのトークン数が変わることまで考慮した結果が、同社の「平均約75%安い」です。この90%は旧モデル側の利用分布であって、どんな組織でも9割のリクエストが短いという調査結果ではありません(Claude Haiku 5.5発表 — 脚注)。
数え方の変化は無視できません。公式の変更点によると、同じ入力文はHaiku 4.5よりおおむね30%多くトークン化されます。増加幅は内容によって異なります。つまり以前「およそ8万」と記録した文章を、文字列も運用も変えずに新モデルへ渡しても、新モデルでも8万とは限らない。旧モデルで境界近くにいるリクエストほど、新モデル側の計数で確認すべきです。30%を全件に機械的に掛けて請求額を断定するのも避けましょう。
短文分類なら低単価の件数が多いかもしれません。一方、対話履歴を積み重ねるワークロードでは、同社によればHaiku 5.5は以前のassistantのthinkingブロックも入力コンテキストに保持します。新しいtokenizerによる差に履歴分が重なれば、初回は短い側でも、後続ターンで境界を越える可能性があります(What’s new — Earlier thinking blocks)。長文書の検索と多ターン対話を、同じ一件あたり費用で予算化する理由はありません。
effortを固定して比較しないと何を見落とすか
Haiku 5.5は適応的なthinkingが標準で有効で、output_config.effort の標準値は medium です。これはHaiku系で初めて調整できる設定で、low にすれば必ず同じ答えが安く得られる、と保証するものではありません。公式文書は、effortがthinkingだけでなく回答文やツール呼び出しを含む出力トークン全般に影響すると説明しています(Effort — How effort works、What’s new — Adaptive thinking)。
次の図は10万トークンの料金境界を測ったものではありません。OSWorldという特定課題での精度と1回あたり費用の比較であり、自社業務の成功率や費用にそのまま当てはめることはできません。
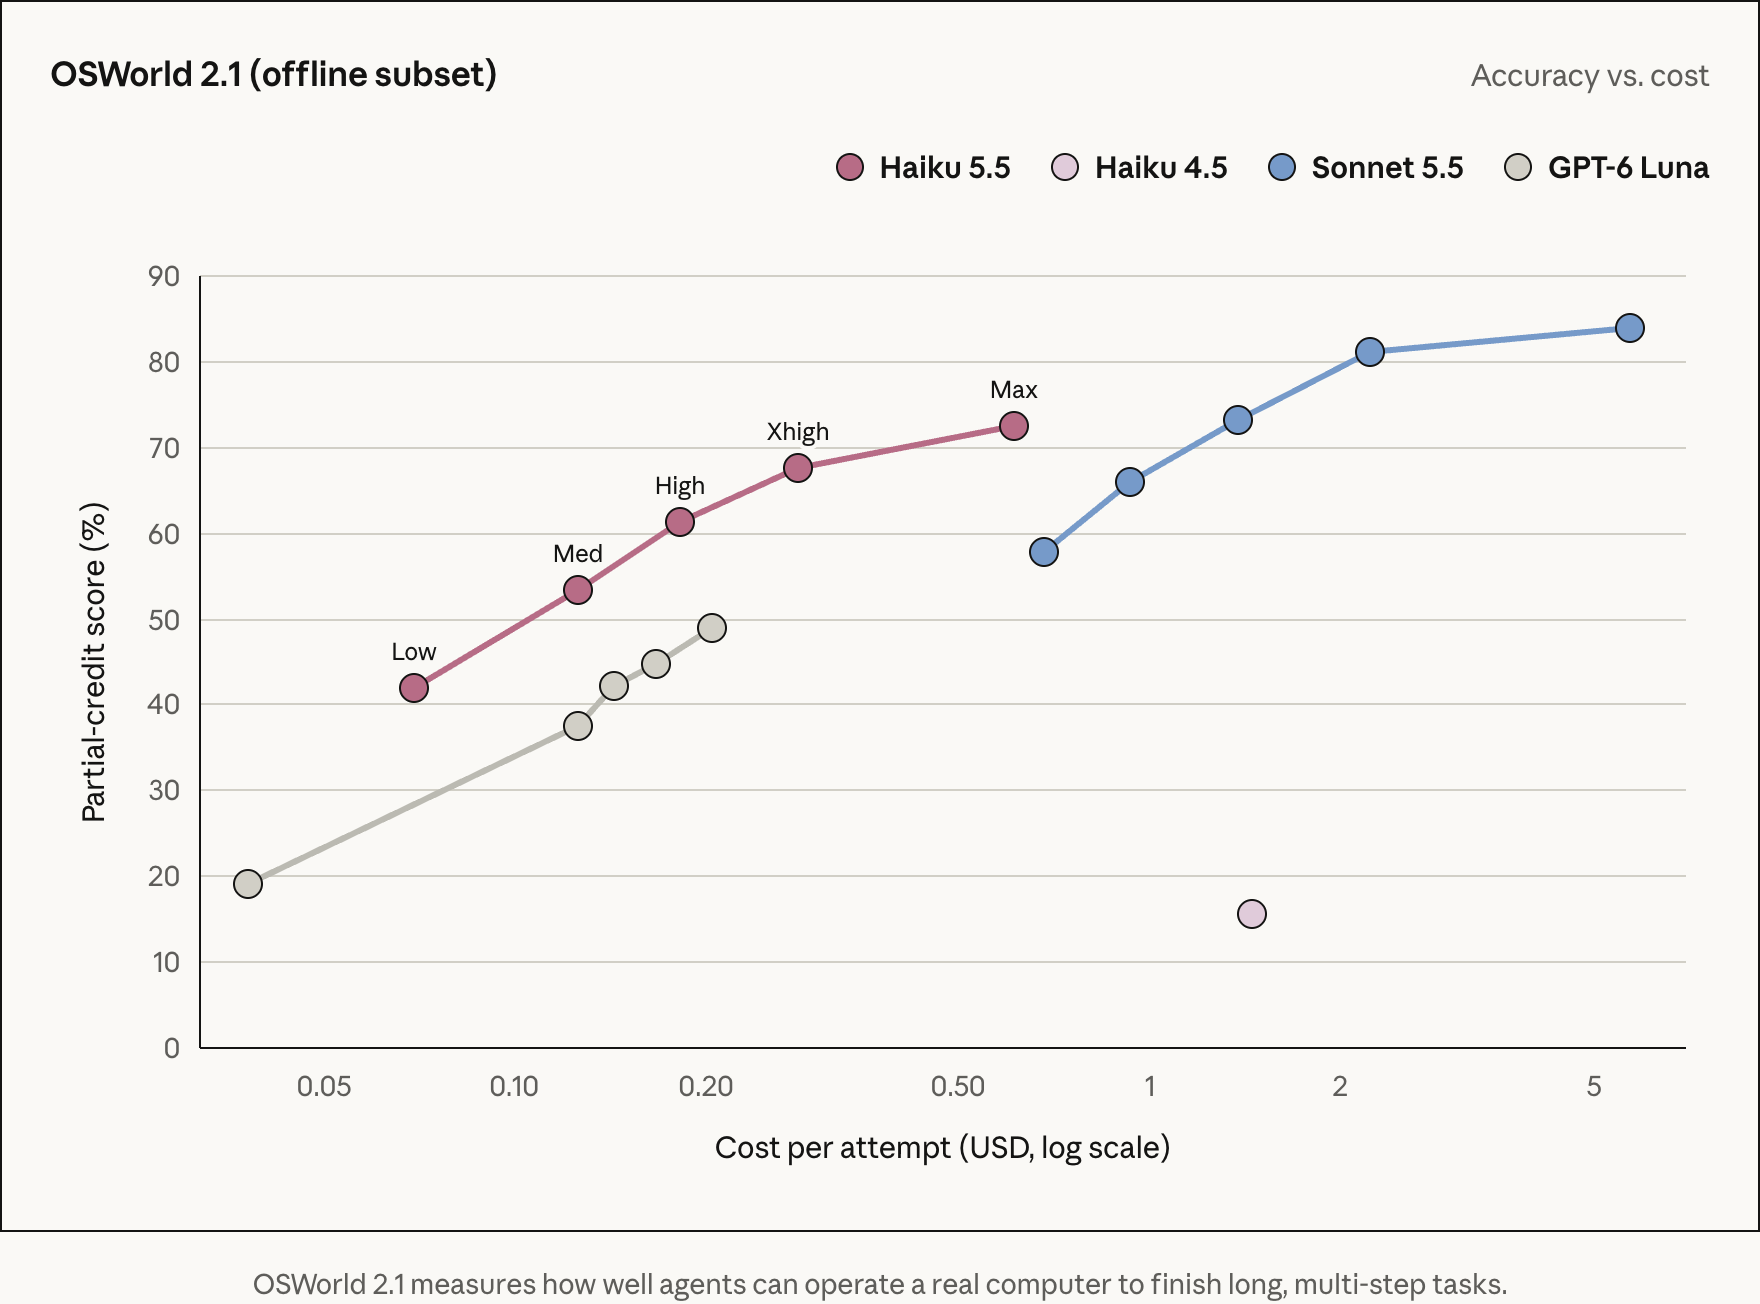
短い答えを求める分類と、複数のツールを使って結果をまとめる下位エージェントでは、同じ入力長でも出力数や追加ターンが違います。料金表にeffortごとの別単価があるのではなく、使うトークンの量や処理の進み方が変わり得る、ということです。実運用で比較するなら、同じ評価用リクエストを揃え、medium を基準に品質・完了までのターン数・入力と出力の使用量を記録する必要があります。本稿にはその測定値がないため、特定の設定で何%速い、何%安いとは言いません。
日本からの利用:JP Geo CRISと料金表は別の話
日本の担当者には、価格と利用場所も分けて確かめる必要があります。CRISはAWSのクロスリージョン推論プロファイルで、呼び出し経路を指定するための仕組みです。AWSのHaiku 5.5発表は、Amazon Bedrockの bedrock-runtime で**JP Geo CRIS(jp.)**を含む推論プロファイルを案内し、対応するAWS Regionの全一覧については別途Bedrockの文書を見るよう求めています。jp. という表記だけから「どのRegionからでも呼べる」「任意の日本Regionで同じ経路になる」とは言えません。
ここまでのドル単価はAnthropic直販APIの価格です。Bedrockを使う場合の実際のRegion可用性、請求単価や適用条件はAWS側の最新資料と利用先の設定で確認してください。JP Geo CRISが載った事実を、そのままBedrockの円建て費用や当地での動作保証へ読み替えないことが、価格表を正しく使う最後の条件です。
最初にすべきことはモデル名を置き換えることではなく、いまのワークロードの入力長をリクエスト単位で数え直すことです。キャッシュの読み書きを含めて10万以下と超の件数を分け、次に出力とeffortの条件を揃えて費用を試算する。同じ実業務のリクエスト群で、キャッシュ読書き、出力、effort、完了品質と再試行回数を記録し、合格した仕事あたりの総費用を現行モデルと比較してください。Haiku 5.5の安さは実在する価格差ですが、その境界をまたぐ仕事の予算は、誰かの平均値ではなく自分のリクエスト分布からしか出せません。