
NEC の「トークンコスト 10 分の 1」は四層の掛け算で届く。モデル世代・effort・キャッシュ・ルーティングの倍率を自分のトークン構成で計算する
NEC の小玉浩氏は 9 月 9 日、全社の AI 利用の実質的なトークンコストを 4 月基準で「上期中に 5 分の 1、下期中に 10 分の 1」にする目標を示しました。目標であって結果ではありません。本稿はこの 10 分の 1 をモデル世代・effort・キャッシュ・ルーティングの四層の掛け算に分解します。effort は出力に、キャッシュは入力に、ルーティングは回した分にしか効きません。DeepSeek の 9 月 10 日価格表、技術レポート §5.3.3 の effort 曲線、Zenn の GPT-6 Astra 実測を出典に、各層の目安の倍率と効く条件を表にし、自分の入力・出力・ヒット率で埋める式を置きます。
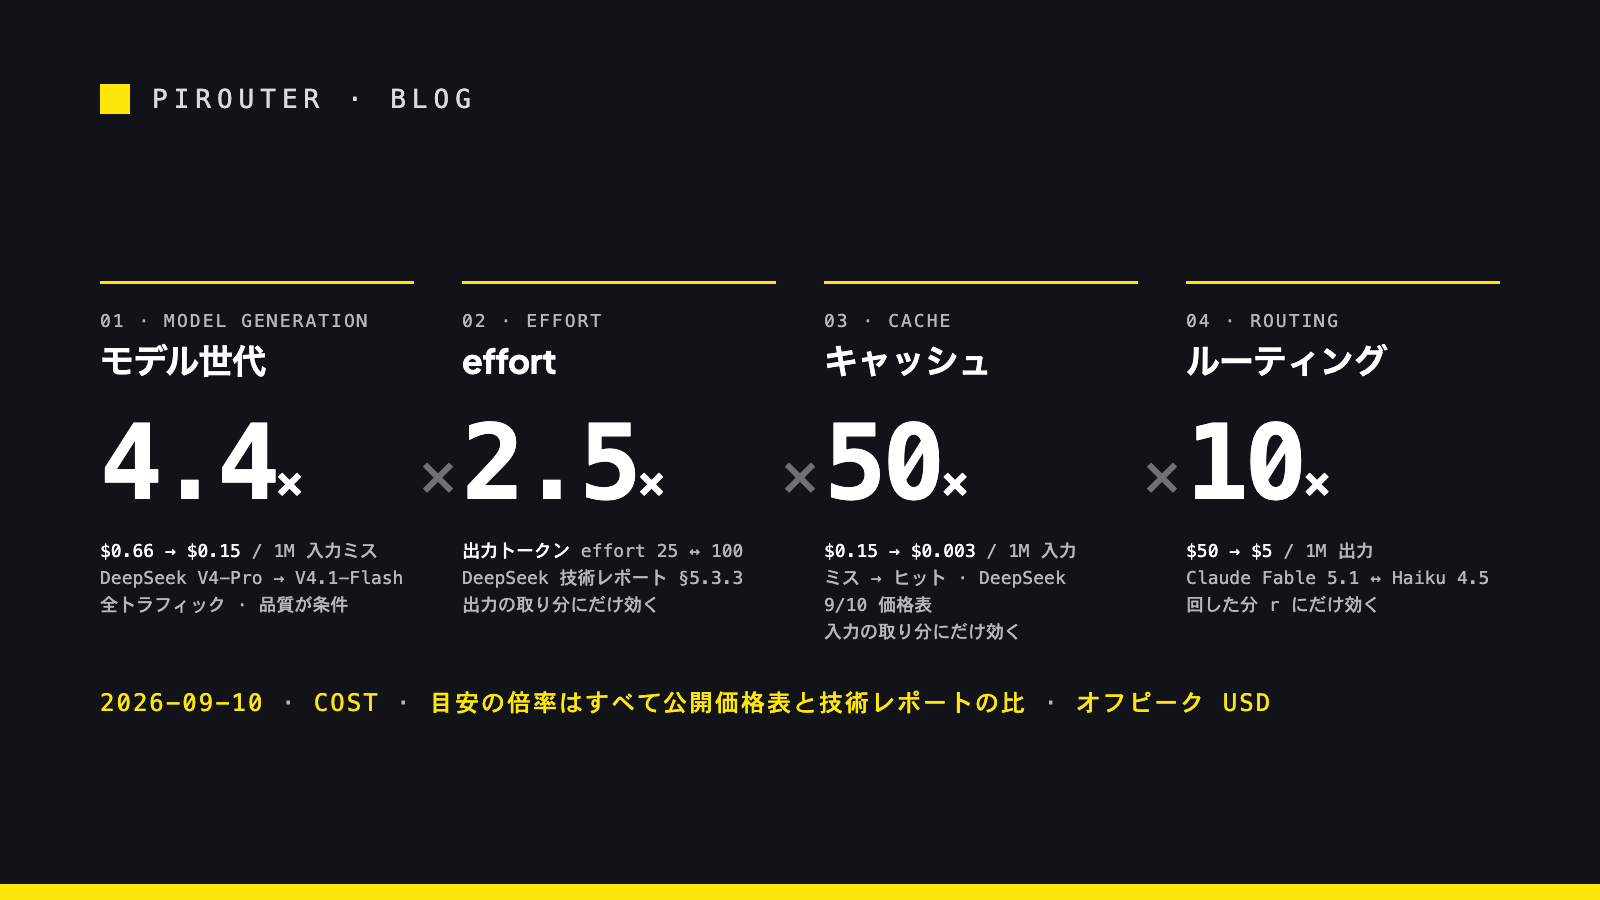
先に答えを書きます。トークンコストの 10 分の 1 は、一つの動作では出ません。①モデル世代、②effort、③キャッシュ、④ルーティング、四つの倍率の掛け算です。しかも四層は請求書の同じ場所に効きません。effort が動かすのは出力トークンだけ、キャッシュは入力だけ、ルーティングは回した分だけ。モデル世代だけが全部に効き、その代わり品質の成立が条件です。倍率を借りる前に、自分の請求書の割れ方を測ってください。
きっかけは NEC です。小玉浩氏(執行役 Corporate EVP 兼 CAXO)は 9 月 9 日、全社の AI 利用に掛かる「実質的なトークンコスト」を「(2026年の)上期中に5分の1、下期中に10分の1に下げる」と説明しました。基準は 4 月時点の利用状況、「(4月時点と)同じ使われ方だったら10分の1にするという考え方」で、利用量は増える見通しです(NEC、社内の“AIトークン節約”に注力)。先に二つ釘を。この数字は目標であって結果ではなく、四層に割り振る比率は我々のモデルで NEC の開示ではありません。
NEC の五つの手段は、四層と「その外側」二つに分かれる
NEC が挙げた手段は五つ。同じ日に ML_Bear 氏が公開したLLMのトークン効率化で気をつけたいことまとめが、同じ論点を現場側から並べています。一つの表に載せると、こう。
| NEC の手段 / ML_Bear 氏の助言 | 落ちる層 | 動く変数 |
|---|---|---|
| ルーティングの適用 | ④ ルーティング | 回した分 r の単価 |
| フロンティアとオープンウェイトの使い分け | ① モデル世代・④ | 単価そのもの |
| キャッシュの活用 / effort とモデルを固定 | ③ キャッシュ | ヒット率 h |
| (NEC の言及なし)/ まず effort を下げる | ② effort | 出力トークン数 |
| コンテキストデータの整備 / MCP の断捨離 | 外側・その 1 | トークン数 |
| 固定料金型サービス | 外側・その 2 | 計量単位 |
外側の二つは扱いません。固定料金は単価ではなく計量単位を変える動作で、分岐はサブスクリプション篇に。
第 1 層 モデル世代:同じ会社の価格表が一日で 3〜7 倍動いた
第 1 層の教材は、たまたま同じ日に出ました。DeepSeek は 9 月 10 日に V4.1-Flash を公開し、同日 04:00 UTC から価格表を改定。旧世代の V4-Pro が同じページに並び、世代交代の倍率が一枚で読めます(Models & Pricing。1M トークンあたり、オフピーク。ピークは UTC 平日 01:00–04:00 と 06:00–10:00 で 2 倍)。
| 1M トークンあたり(USD、オフピーク) | V4-Pro | V4.1-Flash | 比 |
|---|---|---|---|
| 入力・キャッシュヒット | $0.022 | $0.003 | 7.3 倍 |
| 入力・キャッシュミス | $0.66 | $0.15 | 4.4 倍 |
| 出力 | $1.98 | $0.60 | 3.3 倍 |
比の列は当方の割り算です。この世代交代は選択でもありません。注記では 9 月 14 日 12:00(北京時間)以降、deepseek-v4-pro へのリクエストは V4.1-Flash に振り向けられ、Flash 価格で課金されます。旧モデル名は残りますが、旧モデルは残りません。opt-out の記載はなく、あるのは「将来 V4.1 Pro が出るまで」の但し書きだけ。
条件は一つ、品質が自分のタスクで成立することです。DeepSeek の比較表でも、V4.1-Flash は DeepSWE v1.1 と Terminal-Bench 2.1 で V4-Pro を上回る一方、GPQA Diamond と HLE のテキスト部分集合では Pro が上です(モデルカード)。「総合的に上回った」と「全行で勝つ」は別の主張で、どの行に近いかは自分で試すしかありません(三分法は ITmedia)。
①の倍率 g は旧単価 ÷ 新単価をトークン配分で加重した値で、入力ミスが支配的なら 4 倍台、ヒットが支配的なら 7 倍台です。
第 2 層 effort:出力トークンは 2.5 倍動くが、請求に効くのは出力の取り分だけ
effort の倍率には、珍しく一次資料があります。技術レポート §5.3.2–5.3.3 は、effort を 25 から 100 に上げると、推論系 8 ベンチマークの平均 Pass@1 が 67.1% から 76.3%、DeepSWE v1.1 が 66.0% から 74.2%、Terminal-Bench 2.1 が 82.4% から 90.6% に上がり、代償は「roughly 2.5× more output tokens」だと報告しています。実務で効くのは続く一文です。「the 60–80 range already recovers most of the accuracy of the maximum setting at less than half of its token budget」、100 への最後の一段は「lengthens agent trajectories by 1.6–1.8× for only marginal improvements」(DeepSeek-V4.1-Flash Technical Report §5.3.3)。API の low / high / max は effort 50 / 75 / 100(同 §5.1.4、Table 2)。
同じ形が、別のモデルで第三者からも出ています。Zenn の oubakiou 氏は GPT-6 Astra の 4 段を同じ実装課題で 3 反復ずつ回しました(gpt-6-astraはEffortによってどのように性能が変わるのか)。
| effort | 自動テスト評価(3 反復の平均) | 出力トークン(中央値) | 子コスト |
|---|---|---|---|
| low | 90.88 | 7.1k | $0.990 |
| medium | 91.76 | 8.2k | $0.981 |
| high | 100.00 | 15.1k | $1.597 |
| xhigh | 97.54 | 29.9k | $2.969 |
数字は氏のもので、課題は 1 つ、反復は 3 回。子コストは親が呼んだ子モデル側の費用で、氏の計上基準です。xhigh → high で子コストは 46% 減ってスコアは上がり、high → low では 38% 減って 9 点落ちます。「最後の一段は薄い」が、ここでも同じです。
ただし②が請求に効くのは出力の取り分だけ。s_out を出力の取り分、e を下げた後の出力トークン比とすると、
② の倍率 = 1 ÷ (1 − s_out × (1 − e))e = 0.5 なら、s_out 0.9 の推論タスクで 1.8 倍、s_out 0.2 のエージェント負荷で 1.1 倍。
順序について、ML_Bear 氏は「安いモデルに行く前にまず effort を下げるのがおすすめらしい」と伝聞として紹介しています。テストがあるなら「低 effort で走らせて、落ちたやつだけ高 effort で実装をやり直す」。Low で通るテストを既定の High で通し直して請求が 4.0 倍になった実測はサブスクリプション篇に、harness の掛け算は四層乗数に。
第 3 層 キャッシュ:ヒットとミスの 50 倍差は、入力にしか効かない
DeepSeek の新価格で、入力のキャッシュミスは $0.15、ヒットは $0.003。50 倍です。Context Caching は既定で有効、先頭部分が「完全に一致」したキャッシュ単位だけがヒットし、結果は usage の prompt_cache_hit_tokens と prompt_cache_miss_tokens に出ます。「best-effort」で保証はない、とも書かれています(Context Caching — DeepSeek API Docs)。Anthropic 側も同じ桁で、Fable 5.1 の cache read $0.25 は base input $10 の 40 分の 1(cache read crossover)。
③の倍率は入力側だけに掛かります。h をヒット率、c をヒット単価 ÷ ミス単価(DeepSeek 0.02、Fable 5.1 0.025)とすると、
k(h) = (1 − h) + h × c          # 入力側の単価係数(全ミス = 1)
③ の倍率(入力側) = k(改善前の h) ÷ k(改善後の h)
c = 0.02 なら k(0.5) = 0.51、k(0.85) = 0.167、k(0.9) = 0.118。ゼロから 0.9 で 8.5 倍、0.5 から 0.85 で 3.1 倍。ミスが 1 割残るだけで 50 倍は 8.5 倍まで落ちます。ただしこれは入力側だけの倍率で、請求全体に効くのは入力の取り分だけ。h は usage を 1 週間足せば出ます。
h を下げる操作は ML_Bear 氏がまとめています。セッション途中の effort やモデルの切り替え(Claude Code 上の Fable 5.1 は例外)、休憩による期限切れ、system prompt 先頭の日付やリクエスト ID、1 本も通さずの並列投げ。どれも「安くしようとしてやること」で、逆に高くなります。切り替えるなら作業の区切りで。よく当たっている読みを安いモデルへ回すと回した先が高くつくこともあり(トークンの大半は I/O)、③は④より先に決めます。
第 4 層 ルーティング:安いモデルへ回した分の割合にしか効かない
r を安いモデルへ回した請求の割合、q を安い側と高い側の単価比とすると、
④ の倍率 = 1 ÷ (1 − r + r × q)r = 0.5、q = 0.1 で 1.82 倍。q がいくら小さくても r が小さければ効かず、q は品質が成立する範囲でしか使えません。Anthropic の価格表では出力が Fable 5.1 $50、Haiku 4.5 $5 で 10 倍(Pricing、英語刊で 9 月 3 日に読み取り)。GPT-6 Astra の出力 $50 に対し V4.1-Flash は $0.60 で 83 倍ですが、使えるのは「Flash で通る作業」だけ。判定軸は三つ——出力が既存パターンから推定できるか(定型的な変換や整形)、行番号が要るか、ファイル横断の因果があるか。
ルーティングは分業ではなく振り分けです。サブエージェントに同じ資料を二度読ませた瞬間、④で稼いだ分を①〜③の分母で失います(ML_Bear 氏)。
四層の計算表と、10 分の 1 の一つの組み合わせ
自分の値を入れる表です。「目安の倍率」列は公開価格表と技術レポートの比。
| 層 | 何を変える | 効く条件 | 目安の倍率(出典) | 自分の値 |
|---|---|---|---|---|
| ① モデル世代 | 単価 g = 旧 ÷ 新 | 品質が自分のタスクで成立 | 3.3〜7.3(V4-Pro → V4.1-Flash、行による) | トークン配分で加重 |
| ② effort | 出力トークン比 e | 出力の取り分 s_out が大きい | 出力 2.5 倍(§5.3.3、25 → 100)。xhigh → high で 1.86 | 1 ÷ (1 − s_out(1 − e)) |
| ③ キャッシュ | ヒット率 h、単価比 c | 先頭が安定、期限内、切替なし | c = 0.02。入力側なら h 0.5 → 0.85 で 3.1 | 入力側 k(h₀) ÷ k(h₁)、請求全体 1 ÷ (s_in × k(h₁)/k(h₀) + s_out) |
| ④ ルーティング | 回す割合 r、単価比 q | 出力が推定可能な作業 | q = 0.1($50 ↔ $5)。r = 0.5 で 1.82 | 1 ÷ (1 − r + rq) |
記号:s_in・s_out = 入力/出力の取り分。h = ヒット率。c = ヒット単価 ÷ ミス単価。k(h) = (1−h) + h×c。e = 下げた後の出力トークン比。r = 安いモデルへ回した割合。q = 安い側 ÷ 高い側の単価比。
合計はおおよそ四つの積ですが、「おおよそ」に意味があります。②は③を切ることがあり、③が入力を削ると②の効く取り分が増え、④は③の分母を動かします。①と④は特に重なります——④で回した分はすでに安い単価で課金されており、①をもう一度掛けると同じ改善を二度数えます。①は「④で回さなかった分」に効く、と読んでください。順序は③、②、④、①は品質検証の後。
10 分の 1 の一例を置きます。取り分を入力 0.6・出力 0.4、h 0.5、c 0.02 として順に掛けます。以下はすべて請求全体に対する倍率で、入力側だけの値(③なら 3.1)ではありません。③ h を 0.85 へ上げて 1.68 倍、② e 0.55 で 1.43 倍(③の後は出力の取り分が 0.67 に増えています)、④ r 0.5・q 0.1 で 1.82 倍、① g 2.5 を残りの単価水準に適用して 2.5 倍。積はおよそ 10.9、どの層も 3 倍を超えていません。10 倍は一層の奇跡ではなく、四層の平凡な改善の積です。逆に s_out 0.1・h 0.9 なら②③に残りはなく、①と④で稼ぐしかありません。
削減率を目標にしない
NEC の 10 分の 1 の分母は「同じ使われ方なら」の一句です。利用量が増えるとき、その一句が守るのは単価であって請求額ではありません。どの層で何倍を見込むかは開示されていない——書けるのはここまでです。
それでも一つ。四層のうち三つは、自分の usage にすでに数字が出ています。ヒット率は prompt_cache_hit_tokens、出力の取り分は completion_tokens、世代交代の比は価格表に。残る r も、ワークロード別に足せば一週間で出ます。
①に opt-out がない点も、測ってから効きます。9 月 14 日以降に Flash の品質が足りなかったときの選択肢は三つ。オープンウェイトを自前でホスト(単価は下がるが GPU と運用が自分の負担)、別ベンダーへ移す(再検証の工数が要り、キャッシュは積み直し)、品質差を受け入れて②〜④で埋める(安いが、落ちた行を知らないまま使うことになる)。どれも、先に自分のベンチで落ちた行を特定してからです。
我々はゲートウェイ側で、この四つの取り分を key 単位で同じ画面に出すことを設計の軸にしています。設計であって、提供の約束ではありません。表を先に埋めてください。倍率は後から掛かります。