
Decision 3.0をMacで動かす:3つの小型モデルで何を判定し、何を任せないか
d3-lite、d3-nano、d3-miniのCore ML版がApple Siliconに登場。PRの仕分け、画面操作、映像判定という公開デモを起点に、速度、ダウンロード容量、精度の読み方と導入前の確認点を整理します。
Decision 3.0のCore ML版は、Mac上で文章を書くモデルではない。入力を読み、あらかじめ決めた選択肢に確率を付ける、小さな判定器だ。 d3-lite、d3-nano、d3-miniの3種について、公開元はM5 Pro搭載・メモリ24 GBのMacBook ProでPRの仕分け、ウェブ操作、映像判定を披露した。ここで見えるのは「判定を端末に置ける」という選択肢であって、日本語の自社データで正しく動くという保証ではない。本稿は公開資料の解説であり、当編集部によるモデル実行・性能測定ではない。
「答えを書く」のではなく、選択肢に確率を付ける
たとえばサポート窓口に「届いた商品が壊れていて、レシートがある。今日交換してほしい」という連絡が来たとする。必要なのは長い返事を自動生成する前に、担当窓口を返品・請求・技術支援から選び、領収書の有無と緊急度を決めることだ。これらを人が定義した質問としてモデルに渡す。モデルは自由文を完成させる代わりに、Choice(候補から選ぶ)、yes/no、Score(順序のある段階)の答えと確率を返す。どの候補を用意するか、候補の説明をどう書くかは利用側の仕事になる(d3-liteのモデルカード、Core ML配布ページ)。
「一度に複数の質問を渡せる」は「すべてを単一の演算で解く」ではない。公開元の説明では各質問にforward pass、つまり質問ごとに1回の推論が必要で、同じリクエスト内の画像処理は共有できる。Core ML版ではモデル本体と画像のエンコーダーをCore MLで動かし、埋め込みの参照、位置情報の計算、最大255候補の確率を作るFP32の読み出し部分をホスト側が扱う(Apple Silicon版の技術記事、FluidUseのDecision 3.0節)。文章を作らないぶん出力の形は限定できるが、選択肢を間違えないわけではない。
この違いが効くのは、判断が文章作成より先に来る仕事だ。振り分け結果で担当者を呼ぶ、画面上で次の操作候補を選ぶ、映像の一部に動きがあるかを判定する。自由文を最後に書く必要があるなら、その工程は別に残る。以前取り上げたJevによる振り分けと確率の読み方とは、ここが共通の出発点だ。ただし今回はAPIサービスの評価ではなく、Mac端末上の3モデルとその配布・運用条件を見る。
1,000件のサンプルPRを仕分けるデモは、何を肩代わりするか
公開元のデモでは、d3-liteが1,000件のサンプルPRからタイトル、説明文の冒頭、変更されたファイルを読み、7つの作業グループのどこへ回すか、変更の種類は何かを選ぶ。公開元の計測はPR当たり0.12秒。1件につき2つの判定なので、同記事は毎秒8.3件のPR、16.5件の判定と表現している。1,000件なら計算上はおよそ2分。これは投稿・レビューを自動完了した時間ではなく、用意した項目を分類する処理の時間だ。
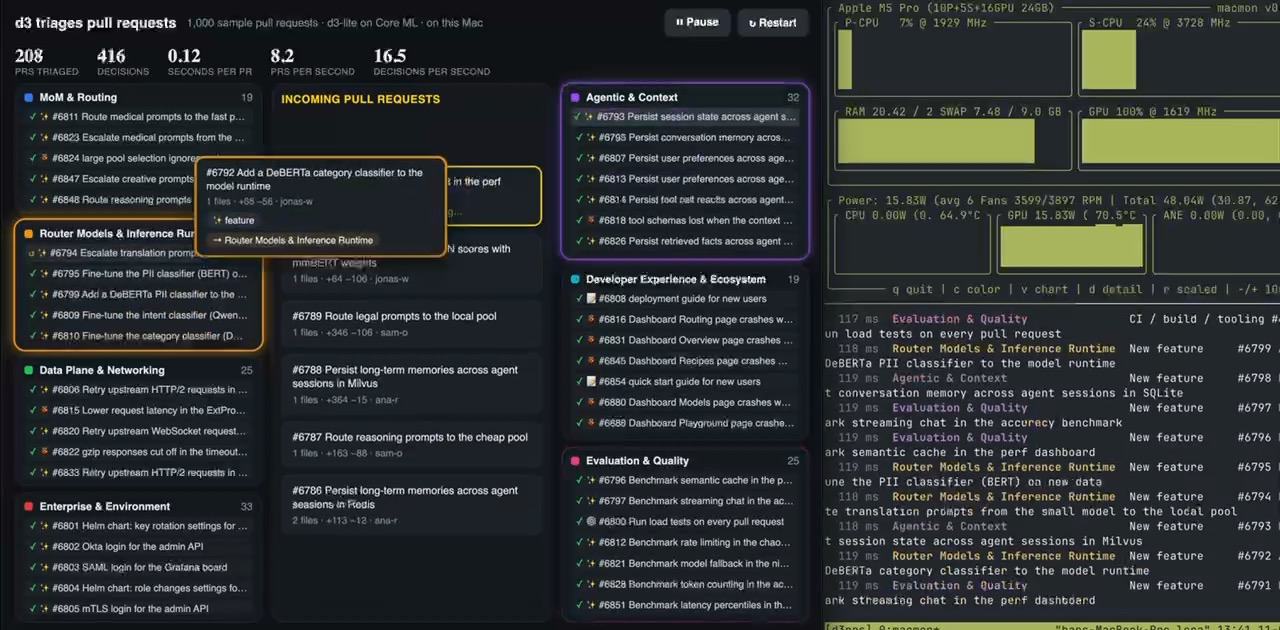
別の実PRを用いた公開元の確認では、d3-miniが担当グループのラベルで134/168件、変更種別で153/182件、メンテナーの付けたラベルと一致した。前段の1,000件を処理したd3-liteの速度と、このd3-miniの一致件数は、モデルも集合も異なる。同じ「PR仕分け」の見出しの下にあるからといって、0.12秒で134/168件の正しさを実現したとつなげてはいけない(公開元のPRトリアージ結果)。
実際のチームで先に決めたいのは、自動承認できるかではなく、どの判定を人に回すかだろう。担当グループが曖昧な変更、複数の領域にまたがるPR、選択肢に「該当なし」が必要なケースを別に集める。正解を一つに固定できない仕事なら、メンテナーのラベルとの不一致もすべてモデルの失敗とは限らない。速さは、保留と確認の経路ができて初めて役に立つ。
画面のクリックと映像の監視は、違う種類の「見る」仕事
d3-miniは画像も読み取れる。公開元は書籍サイトのスクリーンショットにリンク番号を付け、「旅行分野で星5つの本を開く」といった目標から次のクリックを選ぶデモを公開した。書籍カードの情報をコードで照合する条件では17/17の目標を達成し、クリック1回当たりおよそ2.2秒だった。一方、ページ全体を一度に渡して選ばせる方法では9/17。同じd3-miniでも、画面から候補を絞り、操作後に確認する設計が結果を変える(公式ブラウザーデモと条件)。
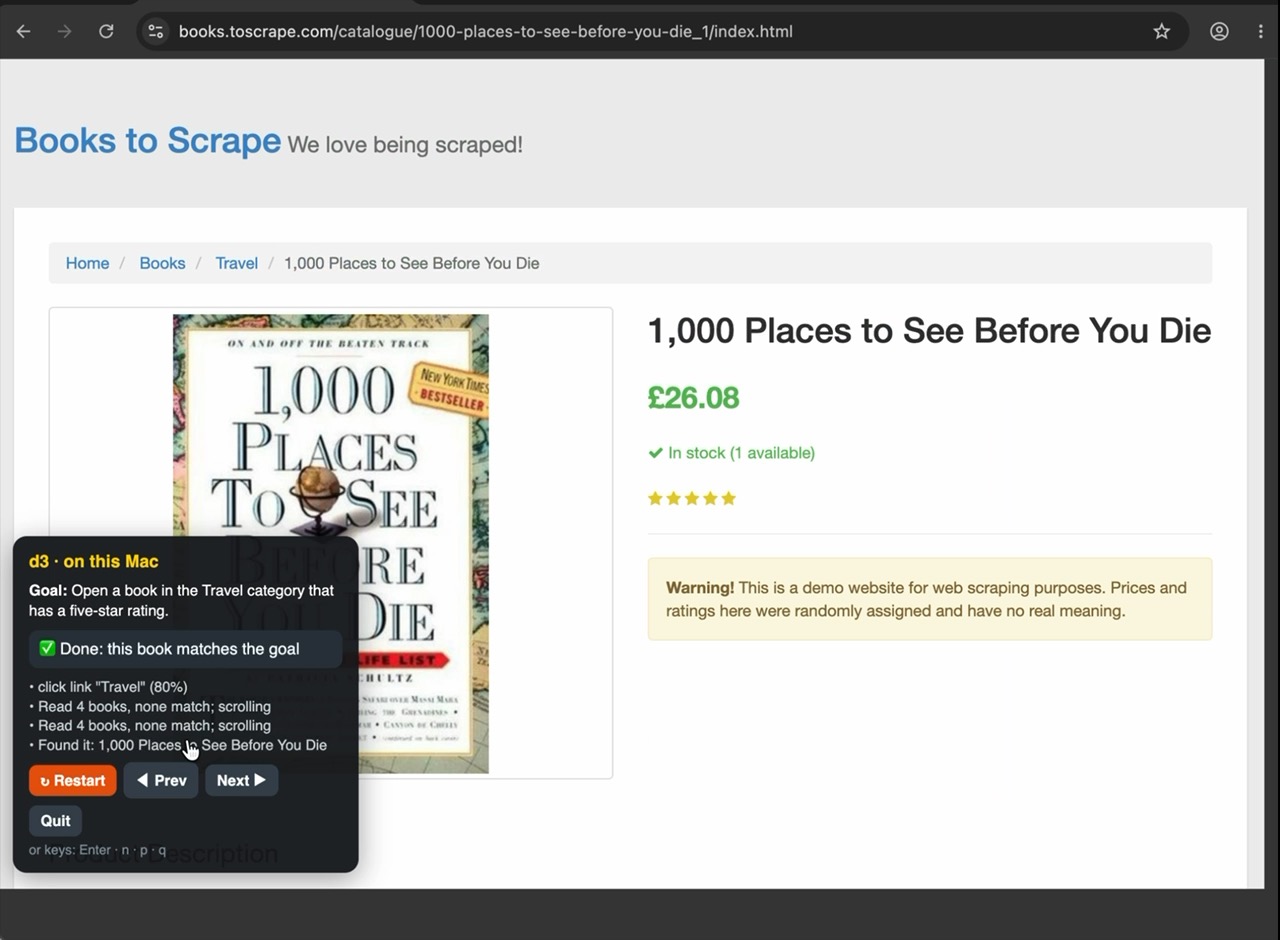
「スクリーンショットを見てクリック先を選ぶ」ことと、「サイトを安全に自律操作できる」ことは別だ。前者は判定モデルの出力、後者には画面状態の取得、リンクの対応付け、遷移後の検証が必要になる。デモでコードによる照合が使われた点を消して成功率だけ引用すると、アプリ側の仕事が見えなくなる。
映像では直近**4秒間の8フレーム(毎秒2フレーム)**をd3-miniに渡し、車が動いているか、自転車に乗る人がいるかを繰り返し尋ねる。公開元の1回の処理はCore MLで1.1秒、同じMacのPyTorchでは2.4秒で、表示される答えは再生位置から約2秒遅れるという。リアルタイム映像のすべての瞬間を認識したという話ではなく、時間窓を切り出した反復判定だ(公式ライブ映像デモ)。
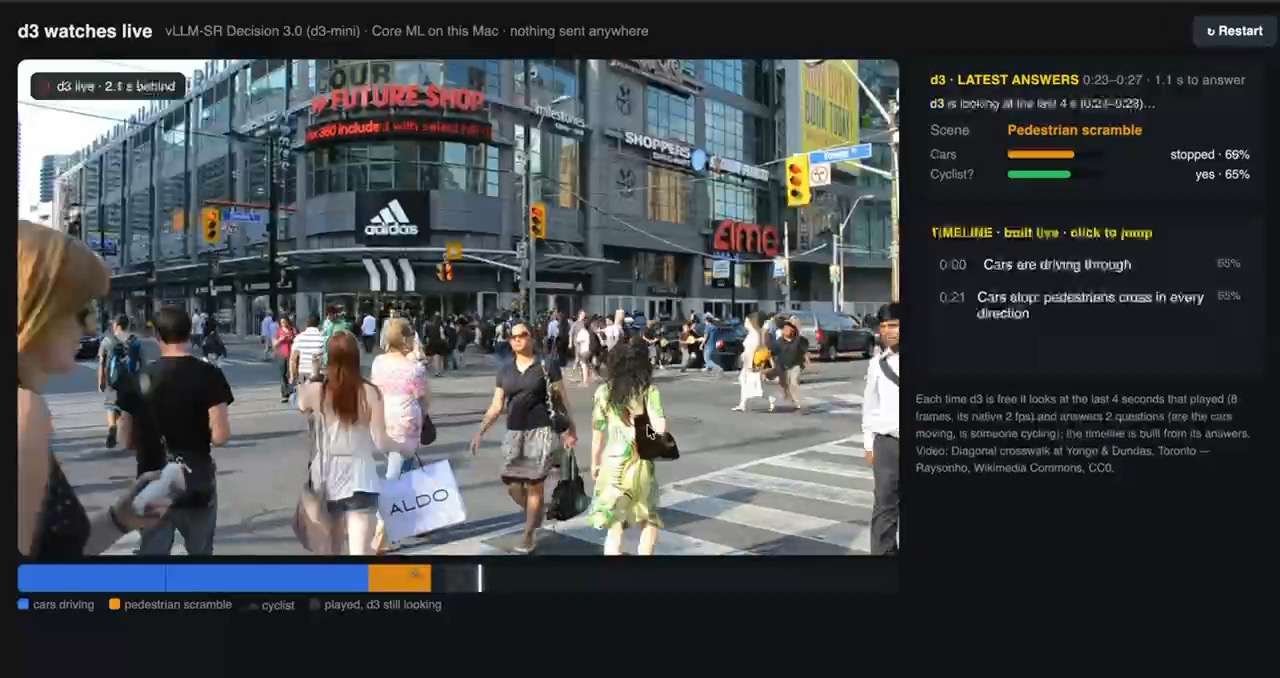
画面操作は一手ずつの確認、映像は更新間隔と後追いの許容が焦点になる。例えば数秒遅れてもよい観測と、即座に止めなければならない制御では要求が違う。後者にこの映像デモの数値だけで導入可否を決めるのは無理がある。
lite、nano、mini――速度と容量は同時に見る
公開元が比べたのは同じM5 Pro搭載MacのGPU上で動くPyTorch(bf16)とCore MLで、両方とも1リクエストずつ処理し、ローカルHTTP往復も計測に含める条件だ。JevBench公開セット231タスクのリクエスト中央値はliteが204→53 ms、nanoが173→69 ms、miniが438→169 ms。公開元は2.5~4倍の高速化と整理する。同じ表の正解率はCore ML側で順に74.0%、75.8%、81.8%。ただしこれはJevBenchの公開セットにおけるラベル一致率で、非公開問題を含むランキングの総合点ではない(公式比較表と注記)。
| モデル | Core ML版のダウンロード量(公開元の記事) | JevBench公開セットの正解率 | リクエスト中央値 |
|---|---|---|---|
| d3-lite | 3.7 GB | 74.0% | 53 ms |
| d3-nano | 10.5 GB | 75.8% | 69 ms |
| d3-mini | 19.6 GB | 81.8% | 169 ms |
表の各行は公開元の同じMacでの結果であり、当編集部の再測定ではない。SwiftのFluidUse READMEには初回取得する固定スナップショットとして別の容量(3.2 / 9.1 / 16 GB)が記されている。対象のファイル集合や計上方法を同一と確認できないため、ここでは公式記事の「Download」列に統一した。どちらの数字も、Macの空き容量や初回導入時間が無視できないことは示している。
miniを軽率に選ばない理由は重みの大きさだけではない。公開元によると、半精度のminiテキストグラフは入力長の区切り一つで6.7 GBを使い、二つ読み込むと24 GBのMacでGPUのページングが起き、処理が1ステップ8~12秒になった。今回の移植は重みに8ビット量子化を使い、別途長い入力向けに4,096トークンのグラフも用意する。入力長ごとに異なるグラフを持つため、「モデルが載る」ことと「必要な長さで快適に動く」ことは同じではない(Core ML移植の技術説明)。
日本語で選ぶ前に、自分の判定を作って測る
Core ML配布ページにはlite / nano / miniの各フォルダにテキスト用グラフ、画像エンコーダー、ホスト側データとPython実装があり、FluidUseにはSwiftのD3Managerがある。FluidUseの記載ではmacOS 15またはiOS 18以降に対応し、初回にモデルを取得する。これは「すべてのApple Silicon端末で上表と同じ時間で動く」という意味ではない。特に上表のMacはM5 Pro・24 GBで、端末のメモリとGPU条件が変われば結果も変わりうる。
公開元のPyTorch比較はMac上の参照実装との比較であり、別環境の高速なカーネルとの勝負ではない。また、元のモデルカードに載るMI325X上の遅延とは、ハードウェアもランタイムも測定対象も違うため横に並べて速さを論じられない。日本語PR、国内ECの画面、独自の映像に対する正解率や確率の較正も、この公開デモからは分からない。
容量と速度を優先する最初のPoCならliteから始め、実際に分類したい50~100件ほどの入力と、保留すべき例を人がラベル付けする。担当先の誤分類、判断を保留する比率、質問数と画像の有無による遅延を測り、足りない場合だけnano、miniへ進む。件数は本稿のPoC案で、公開元による推奨値ではない。自動処理してよい項目、人手へ戻す項目を先に分ければ、小さなモデルの速度を活かしながら誤判定の代価を限定できる。
現時点で選べるのは、定義した問いに端末内で確率付きの答えを返す道具だ。クラウド往復を避けたい判定には魅力がある。一方、どのモデルを採用するかは公開ベンチの順位ではなく、自分たちの言語・入力長・端末・失敗時の運用を揃えてから決めたい。