
Jev は LLM の振り分けに使えるか:埋め込みと LLM 分類のあいだに置くなら、任せない判定は 4 つ
文章を書かずに型付きの判定と確率だけを返す Jev(TypeSafe)を、日本語 52 問の振り分けで見た三層(ルール・埋め込み・LLM 分類)のあいだに置いたとき、何を試し、何を任せないかを整理します。Jev の数値は TypeSafe の公表値と第三者の計測値です。
Jev は振り分け判定の候補にはなります。ただし日本語で当たるかは、まだ誰も示していません。 Jev は TypeSafe が 2026 年 9 月に公開した、文章を書かず、定義済みの選択肢・段階・yes/no に確率付きで答えるモデルです。置くなら埋め込みと LLM 分類のあいだに、「自信がない」と言わせる層として。任せないのは、語で決まる分岐、数値と日付、返答の生成、悪意ある入力の最終防御の四つ。窓口の選択、圏外の門前払い、LLM に回すかの判断は、日本語で測ってから任せる候補です。 私は本稿で Jev を測っていません。Jev の数値は TypeSafe の公表値か、第三者の計測値です。
前作 semantic-router と Qdrant で LLM を呼ばずに振り分ける では、Zenn の shogo_h 氏が日本語の問い合わせ 52 問(5 窓口に当たる 40 問+圏外 12 問)で測った結果を三層に置き直しました。埋め込みは速いが正解率 67.5%、LLM 分類(gpt-5.6-luna)は 100% だが 1 秒かかる、という結果でした。
Jev とは何か:文章を書かず、型付きの判定と確率だけを返すモデル
入力は判断材料の state と、聞きたい questions。質問は三つの型のどれかで、同じ state に対して並列・独立に評価されます(Primitives)。
| 型 | 聞くこと | 返るもの |
|---|---|---|
| Choice | どの選択肢か(最大 255) | 選んだ選択肢、全選択肢の確率(和は 1)、confidence |
| Score | 自分で書いた 2〜10 段階のどこか | 位置(段階のあいだもありうる)、各段階の確率、confidence |
| Noul | yes か no か | yes の確率 0〜1 のみ |
confidence は確率分布の尖り具合を 0〜1 に畳んだ値です(Confidence)。Noul は Vercel の AI Gateway 経由だと boolean と呼ばれます(Vercel changelog)。「ハルシネーションしない」は定義外のキーや型を返さないという意味で、選択肢の中では間違えます(karaage0703 氏のまとめ記事)。
本番に置く前に読む条件:レート制限、データの行き先、退路
公式の Models(2026-09-23 確認)では、入力 100 万トークンあたり 0.042 ドルで出力は課金なし、1 リクエスト 64k トークン、テキストのみ。レート制限は毎秒 25 万トークン・毎分 1,200 リクエスト(毎秒 20 件ほど)で、超えると 429、公式 SDK は既定で待って再試行します。上限は「予告なく変わりうる」、引き上げは custom / enterprise プランです。SLA は公開資料に見当たらず、利用規約はサービス保証の条項を除き「as is」「as available」での提供です。そして言語は英語が主で、CJK は「扱えるが同等ではない」。日本語では、これが一番重い条件です。
本文を state に入れる前の確認リストです(法的な評価はしません)。
- サービスは米国でホストされている(Privacy Policy)。
- 顧客のリクエストと応答で学習はしない。データ処理契約(DPA)は公開されている(Legal)。
- ゼロデータ保持(ZDR)は enterprise 顧客向け。それ以外の保持は DPA で「必要な期間」。
- 個人情報は伏せ字にしてから送る。域外提供の扱いを社内で確認する。DPA と ZDR が自社の契約形態に及ぶかを読む。
退路も先に。Jev は early access で、顧客データでの微調整(LoRA を含む)はせず全アカウントが同じ重みを使い(Models)、重みは非公開、API の形も独自です。自前で持てるオープンソースの Laya には多言語版(mmBERT 322M)がありますが、既定の入力長は 512〜1,024 トークンです(Michał Chromiak 氏の比較記事)。質問は選択肢名と説明の対応表として持ち、当面は PoC に留める。それが私の判断です。
三層のどこに入るか:94 ms と 1,048 ms のあいだ、費用は試算で幅がある
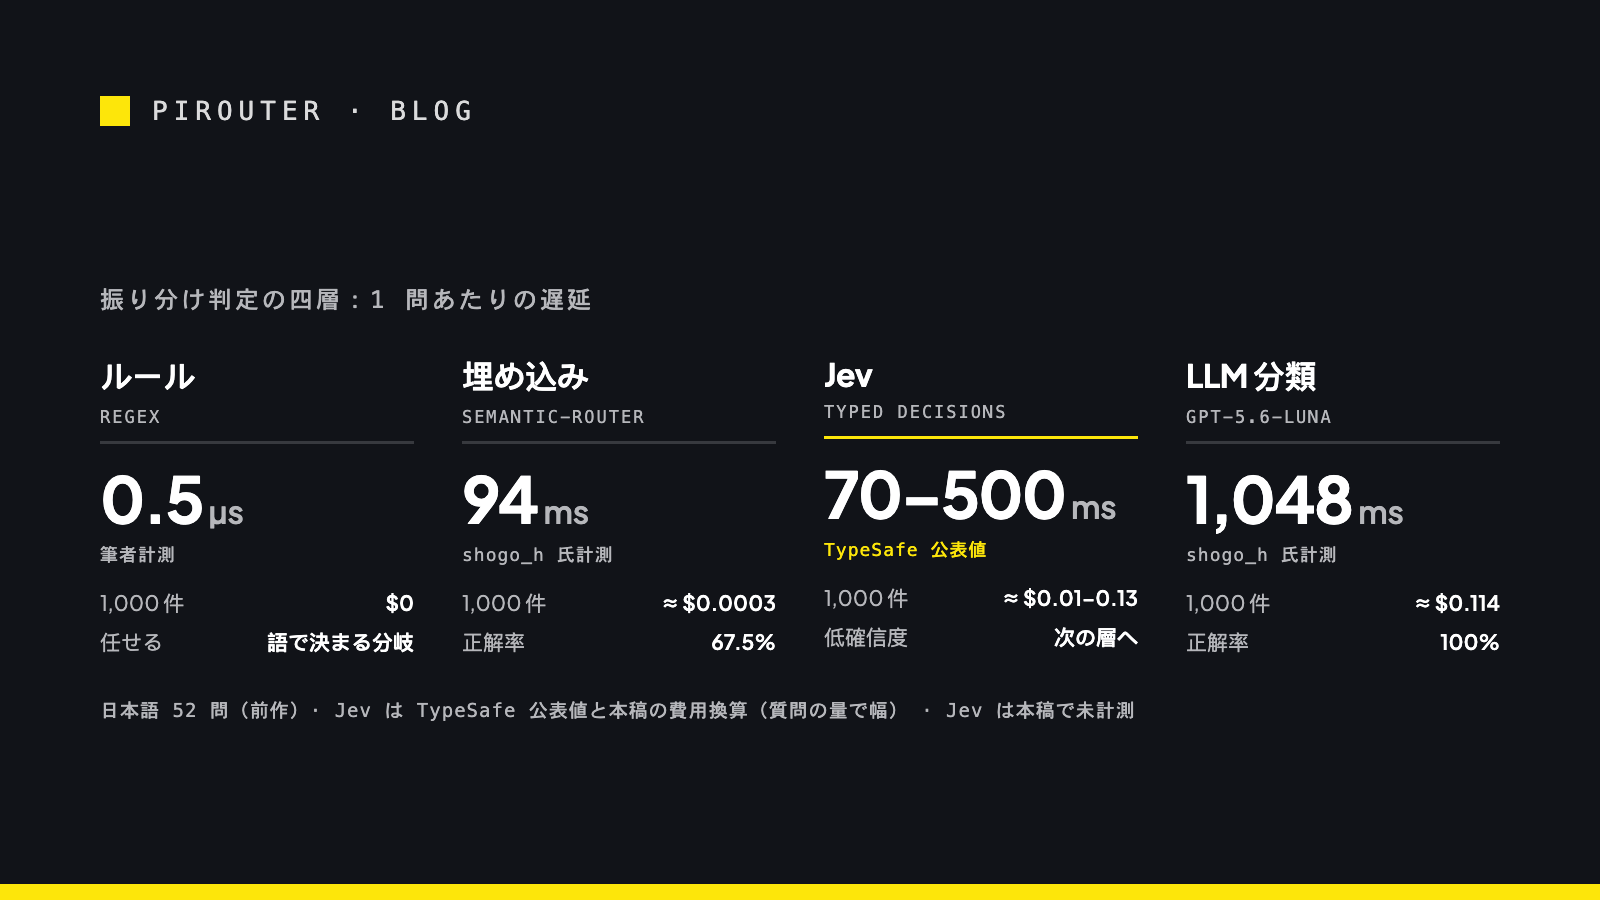
前作の数字をそのまま並べ、Jev の行を足します。
| 層 | 遅延(1 問) | 費用(1,000 件) | 出典 |
|---|---|---|---|
| ルール(正規表現) | 0.5 µs | 0 ドル | 前作・筆者計測 |
| 埋め込み(semantic-router + Qdrant) | p50 94 ms | ≈ 0.0003 ドル | shogo_h 氏計測+前作試算 |
| Jev | 70–500 ms(公表値) | ≈ 0.012〜0.134 ドル(下記) | TypeSafe・第三者 |
| LLM 分類(gpt-5.6-luna, effort none) | p50 1,048 ms | ≈ 0.114 ドル | shogo_h 氏計測+前作試算 |
70–500 ms は公式ブログの値で、計測は「たいてい米西海岸のラップトップから」です。日本からは第三者の単発の値だけで、kikuziro 氏の Qiita 記事では 1 問の Choice が 241 ms、Score 20 問の 1 リクエストが 290 ms。nwn 氏は、公開デモのハーネスを自分の環境で動かすと遅延がおよそ 3 倍だったと書いています。
費用(1,000 件あたり、本稿の換算)は、何をどれだけ聞くかで一桁動きます。1 問の短い Noul は公式 API 例の入力 296 トークンで ≈ 0.012 ドル。範囲を文章で書いた 3 択の門前払いは kikuziro 氏の計測で 0.044 ドル。8 問を 1 回にまとめた watany 氏の記録(Vercel 経由、入力 3,180 トークン・677 ms)は約 0.134 ドルで、前作の LLM 分類 1 問より高い。前作の 540 トークンを当てた ≈ 0.023 ドルは、トークナイザが別物なので代理値です。
月 100 万件でも LLM 分類は約 114 ドルで、費用は層を分ける理由になりません。理由は、圏外を返せるか、自信がないと言えるか、日本語で当たるかです。
前作の弱点に効くか:押し込みと、スコアが当たり外れを分けない問題
前作の埋め込み層は、外した 13 問のうち 12 問を別の窓口に押し込み、圏外(None)は 1 問だけ。誤判定と正解のスコア(0.301–0.526 と 0.359–0.571)も重なっていた。
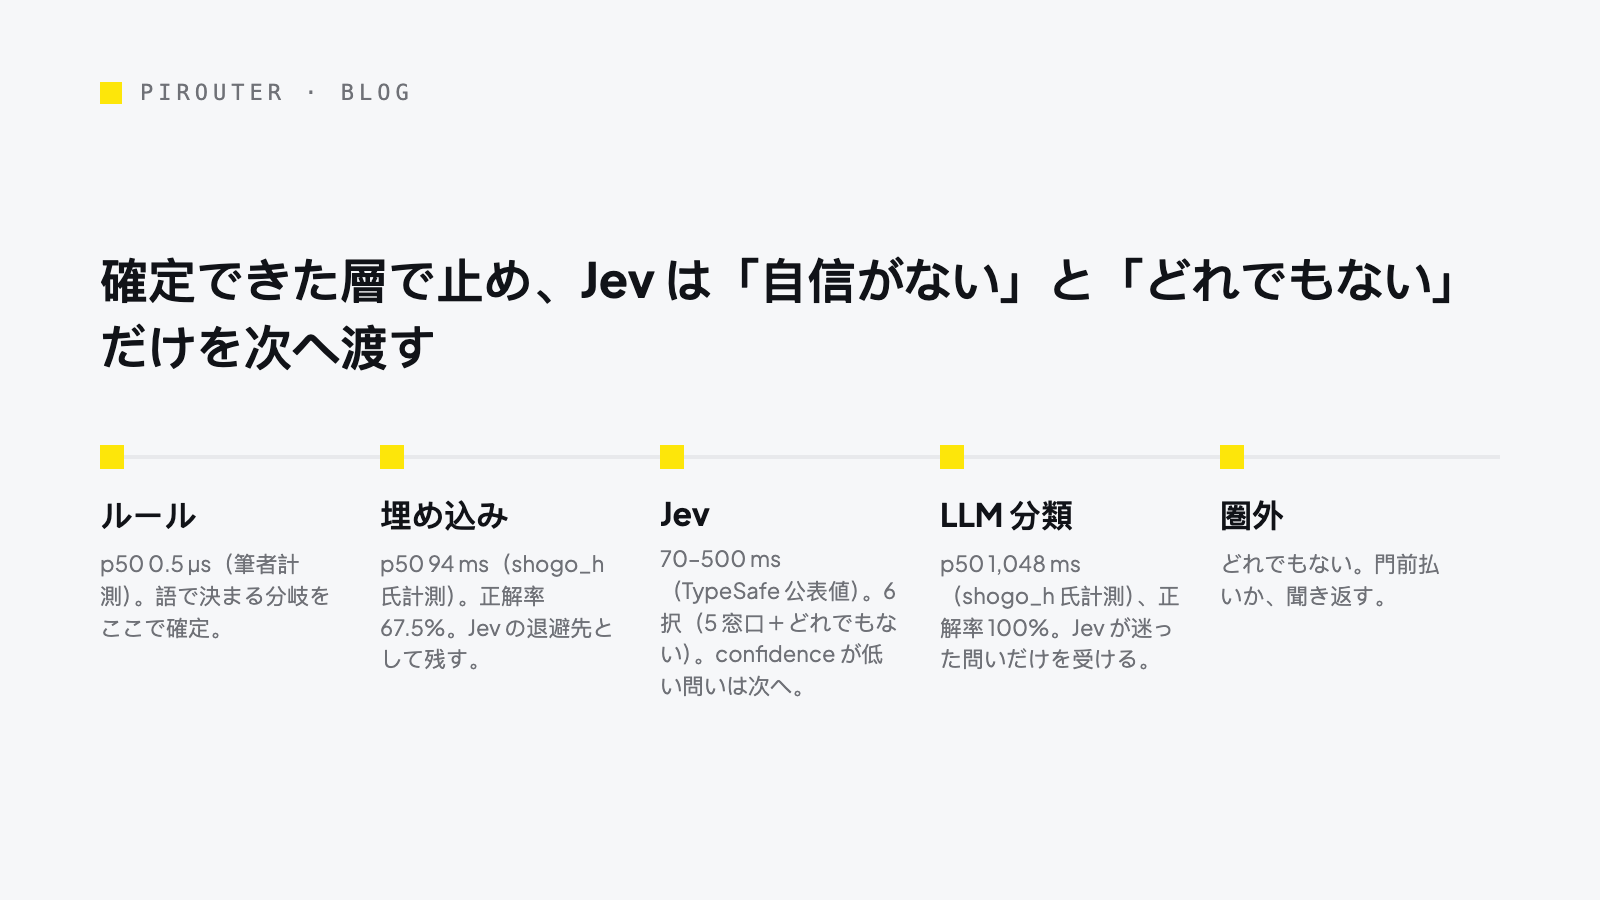
押し込みは、Choice にしても構造としては残ります。 確率の和が 1 なので、5 窓口だけを並べれば圏外の問いの確率は一番ましな窓口に乗る。公式も網羅できないなら none of the above を足せと書いています(Primitives)。前作なら 6 択(5 窓口+どれでもない)です。
圏外の判定は、説明文の書き方で変わります。 kikuziro 氏の社内規程の門前払い(in_scope / out_of_scope / unclear)では、範囲を「人事・経理・総務・IT・安全衛生」の 5 語で書くと、原文が抜き出した 34 問のうち 5 問を誤って止め、規程を書き下すと 0 問に。全体では範囲内 100 問の誤拒否 2、無関係 20 問の拒否 19、意味をなさない 10 問はすべて unclear でした。窓口は名詞でなく、何を受けるかを文章で書く。前作の「行動で切る」と同じ方向です。
確信度が当たり外れを分けるかは、日本語では誰も測っていません。 これが本稿の要点です。TypeSafe は RLCD という学習で「確率が高いほど正解の見込みが高い」よう較正(キャリブレーション)したと述べますが(AI primer)、公式ブログとドキュメントを読んだ範囲に較正曲線(確信度の区間ごとの正解率)はありません(2026-09-23 確認)。
公式の既知の弱点一覧(jev-1.13)の例が効きます。「サイズ感に不満がある。どんな選択肢がある?」に「返金を求めているか」を聞くと、Noul は 0.22、yes/no の Choice は yes 0.01 で confidence 0.97。別の「二重に請求された」では、「返金」と「返金以外」の Noul が 0.72 と 0.47、合計 1.19 です。高い confidence は、型をまたいだ正しさを保証しません。型を変えたら閾値は決め直しです。
LLM の logit で同じことはできないのか
nwn 氏の記事「TypeSafeのJevを正しく驚く、それってLLMでできませんか?」は、候補を 1 トークンずつに割り当てて logit を読めば 1 回の forward pass で判断が取れると示し、Gemma3 270M で JSON 生成より 77 倍速かったと報告しています。ただしその値は次トークンの相対比で、較正された確率ではありません(monochromegane 氏の分類記事)。
TypeSafe 自身の比較が workflow evals で、四つの業務フローの答えを GPT-6 Astra と Fable 5.1 の平均と突き合わせた一致率です。
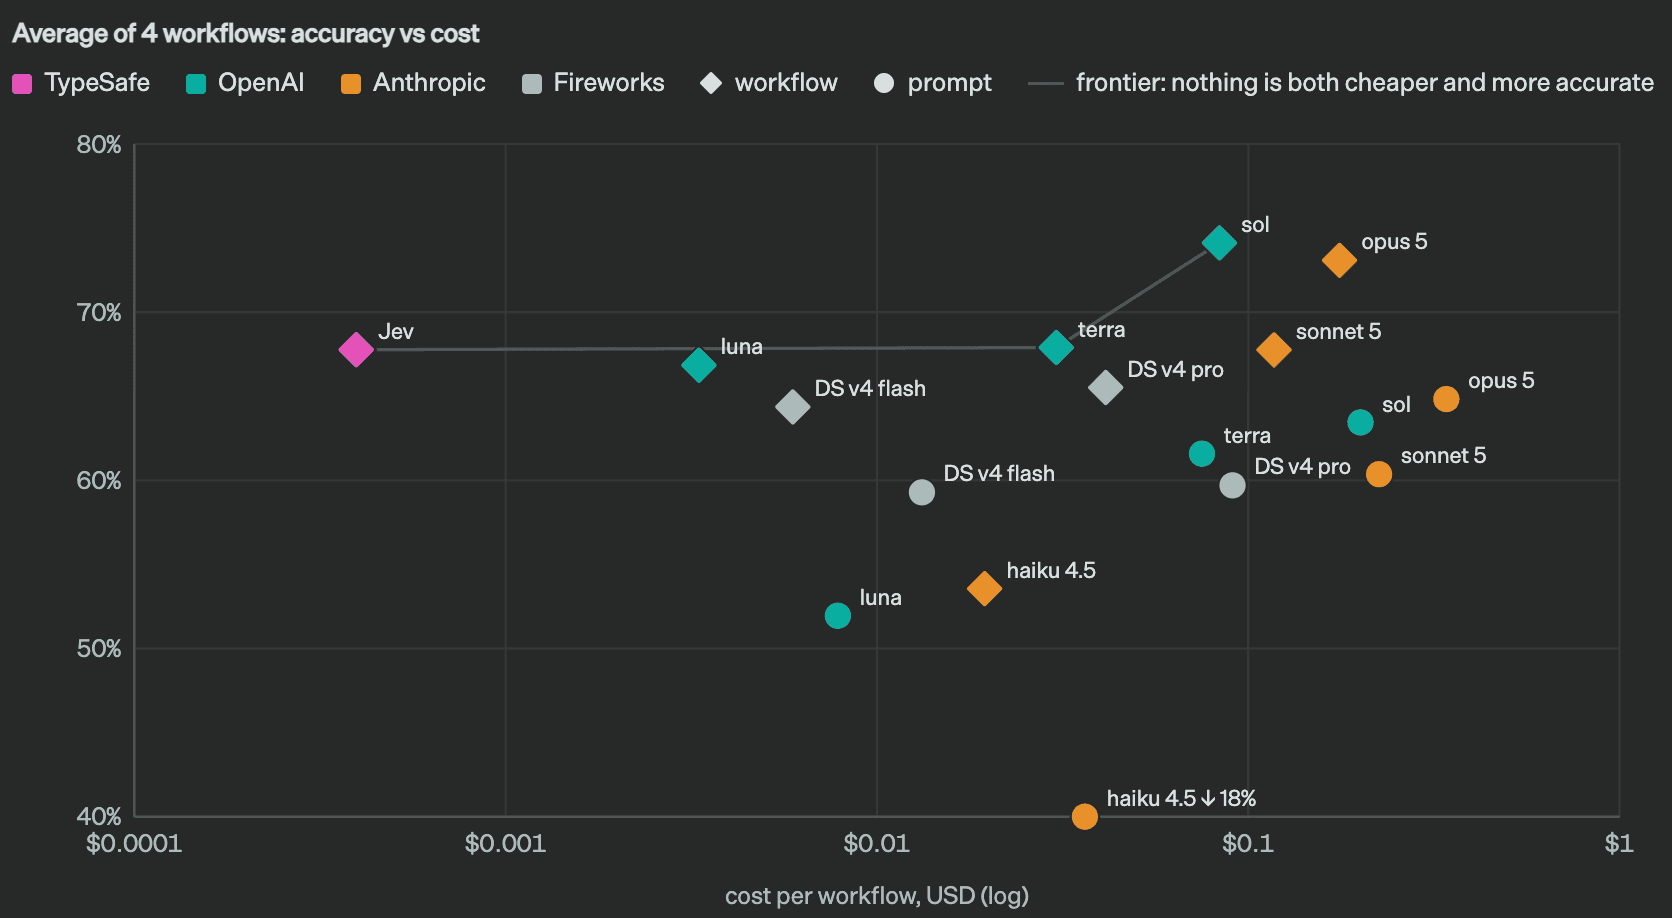
四フロー平均で Jev は 67.8%・1 件 0.0004 ドル・0.4 秒。evals の luna(版の表記なし)は 66.8%・約 0.0033 ドル・12.9 秒、最上位の sol は 74.1% で Jev と約 6 ポイント差です。ここでの 1 件は多数の質問を順に聞く一本のワークフローで、LLM 側は TypeSafe の包装層(確率付きの判定を出させるもの)を通しており、公式ブログ自身が「遅く高くなりがち」と書いています。12.9 秒は前作の 1,048 ms とは比べられません。
私の読みでは、Jev の新しさは LLM にできないことではなく、較正された確率を返す契約を API として売った点です。自前で logit を読むなら、logprobs を返さない推論モデルが多く、較正も自分で測って保守することになります。
何を任せ、何を任せないか:判定の種類ごとの置き場所
印は私の判断で、日本語の本番データで測り直す前提です。
| 判定の種類 | ルール | 埋め込み | Jev | LLM |
|---|---|---|---|---|
| 型番・エラーコードなど語で決まる分岐 | ここで確定 | 語の一致に弱い | コードで確定できることは聞かない | 払う理由がない |
| 数値・日付・件数の比較 | コードで計算 | 数え上げ・日付比較は公式が弱点と明記 | ||
| 意味で決まる窓口の振り分け(前作の該当 40 問) | 13 問中 7 問が無一致 | 27/40(67.5%)、閾値 0.35 で 9/40 を押し込み | 6 択+confidence。日本語は未検証 | 40/40 |
| 圏外の門前払い(前作の圏外 12 問) | 閾値 0.35 で 11/12 | 第三者の別データで難度が違う | 12/12 | |
| LLM・人に回すかの判断(confidence ゲート) | スコアが分けなかった | 仕組みはある。日本語で分けるかは未測定 | 過信しがち(TypeSafe の主張) | |
| 窓口・緊急度・担当者希望の同時判定 | 一度に一つ | 1 回で並列 | 1 秒と出力 | |
| 返答の文章 | 生成はしない | |||
| プロンプトインジェクションなど悪意ある入力 | 公式が「state を敵対的とは扱わない」 |
語で決まる分はルールで確定し、残りを Jev の 6 択に通し、confidence の低いもの(公式例は 0.5 未満、Intent routing)と「どれでもない」だけを LLM 分類か人に渡す。緊急度や担当者希望も同じリクエストに足せ、公式によれば遅延はほぼ変わらず、費用は足した分だけ増えます(Primitives)。
Jev には遅延の予算(たとえば 500 ms)を決め、超えたときや 429・5xx では埋め込みか LLM 分類に落とし、失敗が続けば切り離す。埋め込み層を残す理由は、速さではなくこの退避先です。
導入前に手元の 50 問で測ること
前作で勧めた 50 問のセットに、次を足します。
- 窓口の Choice(5 窓口+「どれでもない」、受けるものを文章で)と Noul「人間の担当者を求めているか」を同じリクエストに入れる。
- confidence を「0.9 以上/0.5〜0.9/0.5 未満」に分け、区間ごとの正解率を表にする。上の区間ほど正解率が高ければ較正は効いている。結論には各区間 30 問ほど要るので、50 問は目安取りです。
- 自社のリージョンから p50・p95 と
429の率を記録する。 - 閾値を決める前に
jev-1.13.0に固定し、版を上げるたびに表を取り直す(エイリアスjev-latestは動く、Models)。 - 同じ 50 問を埋め込み層にも通し、Jev が押し込みを減らしたのか、「どれでもない」を増やしただけなのかを分けて数える。
この表ができるまで、Jev は PoC の中に置いておきます。