
LFM2.5-24B-A2BをMacに常駐させる前に、確かめたい3つの条件
LFM2.5-24B-A2BはMacの常駐エージェント候補。ただし184 tok/sはM5 Maxでの公式値です。mlx-lmの必要バージョン、M4・16GBの独立テスト、思考用トークンと商用ライセンスから導入条件を整理します。
LFM2.5-24B-A2Bは、Macで動かす常駐エージェントの候補になりました。ただし、公式の184 tok/sを手元のMacでも出せるとは限りません。導入前に確かめたいのは、正しく動く実行環境、思考を含めたタスクの予算、そして商用利用の条件です。
たとえば、作業フォルダーを読み、変更点をまとめ、必要なときだけ道具を呼ぶ助手。そんな用途で欲しいのは、短い質問に一度答える速さより、ほかのアプリと一緒に動き続けられる余裕です。ファイルへのアクセス、道具の実行、継続運転を担うのは、モデルにつなぐエージェント用ソフトです。モデルを起動するだけで、これらが自動的に備わるわけではありません。今回の公開資料は判断の入口ですが、全Mac共通の動作保証ではありません。
184 tok/sはM5 Maxの条件付きデータ
Liquid AIは10月13日、総パラメーター24B、トークンごとの有効パラメーターを公式の概称で約2Bとするモデルを公開しました。モデルカードの詳細値は2.45Bです。最大コンテキストは131,072トークン。長い会話や道具の実行履歴を扱う設計ですが、最初から上限いっぱいに設定すべきという意味ではありません(LFM2.5-24B-A2B公式発表)。
目を引く184 tok/sはApple M5 Maxでの公式測定値です。公式モデルカードのEdge Inferenceには、llama.cpp、Q4_K_M量子化、4Kトークンの入力という条件が載っています。これはMLXで測った数字でも、長い履歴を抱えた常駐タスクの完了時間でもありません。
一方、最大21K出力tok/sは、単一のNVIDIA B300で高い同時実行数を保ったときの合計処理量です。BF16、入力1,024、最大出力256トークンという別の試験であり、一人のMac利用者が待つ速さには置き換えられません。
公式のエージェント・ツール利用評価で有望な結果が出たことと、自分の仕事を任せられることも別です。まずは「毎朝の資料整理」のように、入出力と正解を確認できる仕事へ絞るのが現実的です。
MLXで動かすなら、mlx-lm 0.32.0以上を確認する
Macには複数の実行経路があります。この節の版の条件はMLXを選ぶ場合のものです。Apple Silicon向けにはMLX形式の4bit版が公開されています。MLXはMacでモデルを実行するための仕組みで、量子化は重みの表現を小さくして扱う方法です。ダウンロードする形式と、それを読む実行環境を一組で選びます。
ここで見落とせないのが、mlx-lm>=0.32.0という条件です。公式モデル文書のQuick Startは、以前の版ではエキスパートを誤って振り分けると明記しています。エキスパートとは、入力に応じて選ばれるモデル内の計算部分。旧版の問題は、単に処理が遅いという話ではありません。
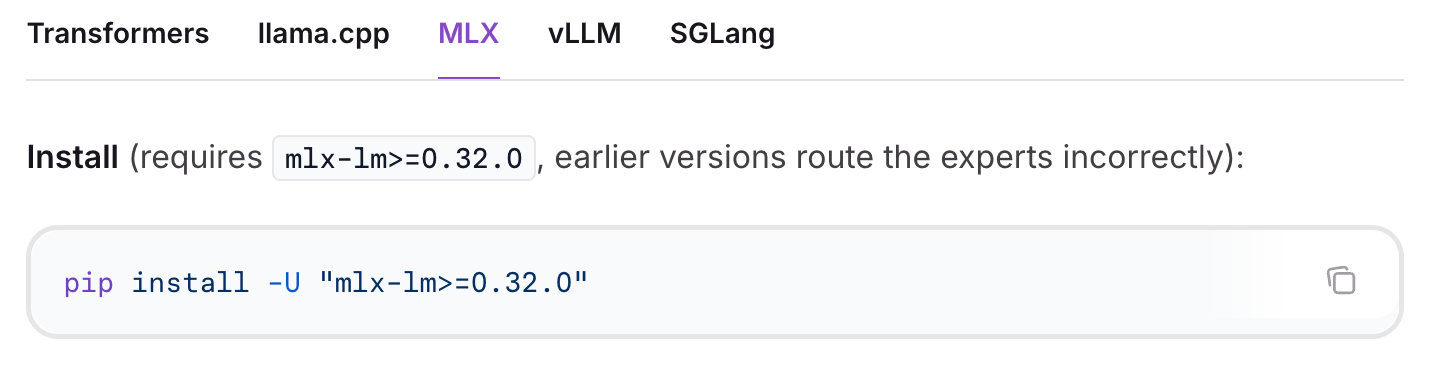
以前のモデルが動いていた環境でも、そのまま品質を評価しないほうがよいでしょう。確認対象は基盤のmlxだけでなく、モデルの読み込みと生成を担うmlx-lmです。環境を更新したらバージョンを記録し、短い既知の質問から確かめます。
既存のllama.cpp環境を使いたいならGGUF版が候補です。同じモデル名でも、MLX用ファイルとGGUFは交換して使うものではありません。また、公式モデルカードの配布形式一覧にあるDSparkの補助モデルは「Coming soon」。高速化を助ける予定の仕組みであり、今ある導入手順の前提にはできません。
M4・16GBの失敗例は、買い替えの結論にはならない
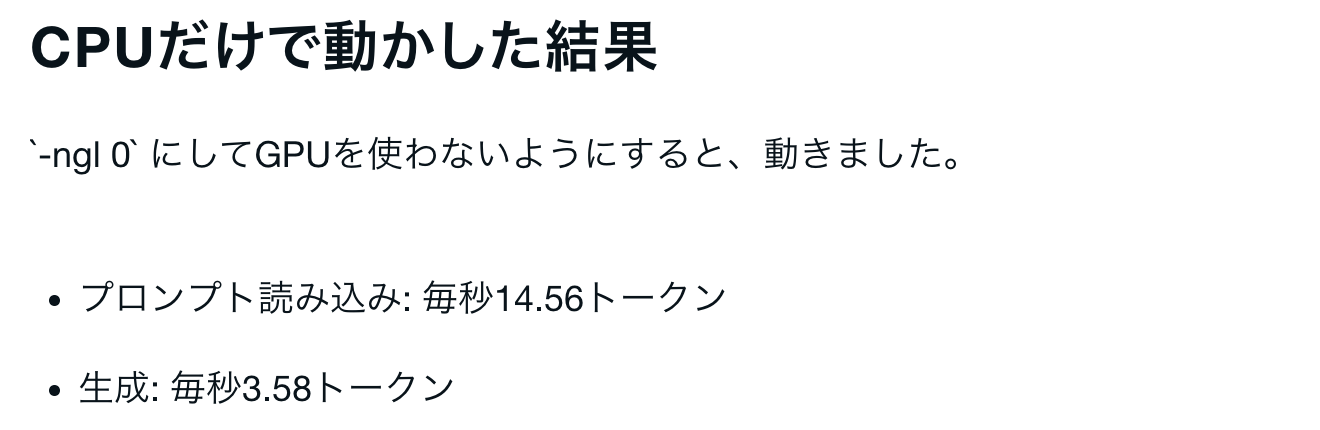
日本語の独立した観察も出ています。Hack-LogはM4・メモリ16GB、llama.cpp b10964、約13.6GBのQAD-Q4_0版で、GPU実行がメモリ不足になったと報告しました。CPUのみでは、llama-benchの512トークン入力・128トークン生成という短い基準で3.58 tok/sでした。常駐タスクの完了速度ではありません(Hack-Log:M4・16GBでの実行記録)。
その記録ではGPUへ載せる層を減らしても失敗しましたが、この点の原因の切り分けは完了していません。編集部の追試でもなく、MLX版の結果でもありません。「16GBなら必ず失敗する」「24GBなら必ず成功する」という線引きには使えないデータです。
それでも、購入前の注意としては重要です。ファイルが保存できる容量と、OSやブラウザーを動かしながら推論できる余裕は違います。有効パラメーター約2Bという値だけで、必要メモリを2Bモデル相当と考えることもできません。
公式M5 MaxとこのM4の数字は、機種も量子化形式も実行条件も異なります。速度比を計算するより、手元で使う形式を固定し、短い入力での起動、普段のアプリを開いた状態、履歴が伸びた状態を順に確かめるほうが、常駐させる判断に役立ちます。
記録するなら、モデルのファイル名、実行ソフトの版、入力の長さ、完了までの時間、メモリプレッシャーやスワップを一組にします。これなら失敗したときに、モデルの選択を変えるべきか、履歴を短くすべきかを比較できます。動いたという一回の結果だけで、仕事中も常駐できるとは決めないことです。
「常に考える」分を、待ち時間とツール接続に織り込む
LFM2.5-24B-A2Bは、答える前に毎回推論を生成するモデルです。公式文書は、チャット用テンプレートが各回答を<think>で始めること、生成上限にはその思考部分の余地を残すことを説明しています。最終回答が数行でも、生成量が数行分で済むとは限りません。
したがって、常駐時に測りたいのは、文字が出始めるまでの時間だけではありません。思考、道具の選択、実行、結果の読み直しを経て、仕事が終わるまでの時間です。生成上限を削って待ち時間を抑えようとしても、肝心の道具呼び出しや回答の手前で途切れれば意味がありません。
接続側にも確認点があります。公式モデルカードのTool Useでは、標準の道具呼び出しは特殊トークンで囲んだPython風の形式です。システム指示でJSON形式に変更できるとされていますが、エージェント側が期待する形式に合うかは別途確認が必要です。
道具の一覧を渡し、呼び出しを解釈して実行し、その結果をtool役割のメッセージで戻す。この往復が成立して初めて、自動で仕事を進められます。ローカルのAPIサーバーにつながっただけでは、接続確認の半分です。
試すなら、最初はファイルの読み取りと要約だけに絞るのがおすすめです。書き込みや送信の権限は後から加えればよく、推論が端末内で済んでも、検索や外部サービスを呼ぶ道具まで通信しなくなるわけではありません。
商用ライセンスとAPI料金は、別々に判断する
重みが公開されていることは、あらゆる商用利用に無条件で使えることを意味しません。LFM Open License v1.0はThresholdを次のように定義しています。
“Threshold” shall mean annual revenue of 10 million United States dollars ($10,000,000) or more.
第5条(a)は商用利用の権利に「not exceeding the Threshold」という条件を置き、(b)では次のように記しています。
Any Commercial Use of the Work or a Derivative Work by a Legal Entity that exceeds the Threshold is not licensed under this Agreement.
収益基準は年間1,000万米ドルです。Legal Entityの定義には、支配・被支配・共通支配の関係にある関連主体も含まれます。単一のプロジェクトや部門の売上だけで適用を判断しないでください。ただし、ここで「ちょうど同額ならどうなるか」まで独自に結論を出すことはできません。定義と適用条項を一緒に確認し、組織への適用や収益の対象範囲は、提供元や法務担当者へ確認してください。
ローカル導入の手間をかける前に、APIで用途を確かめる選択肢もあります。公式発表の料金は100万トークン当たり、入力0.10米ドル、キャッシュ済み入力0.05米ドル、出力1.00米ドルです。これはAPI料金であって、Macの電力・購入費・保守を含めたローカル実行の原価ではありません。APIでの確認は用途と基本的な品質の初期評価です。本格的なローカル導入前には、最終的に使う量子化ファイル、実行環境、道具の接続方法で同じ課題を再検証します。APIの結果から、本機のメモリ余裕や道具呼び出しの安定性までは判断できません。
手元にデータを置く必要が強ければ、正しい版の実行環境で、小さな読み取り専用タスクから始める。用途がまだ定まらず、外部処理も許容できるなら、APIで品質を先に確かめる。LFM2.5-24B-A2Bの公開はその選択肢を増やしましたが、常駐を決める最後の材料は、手元の環境で一つの仕事を最後まで終えられるかどうかです。