
ChatGPT、Claude、Grok 同时宕机时,多供应商 failover 为什么没救到你?名单上有三家,不等于有三个故障域
9 月 3 日晚 Claude、Grok、ChatGPT 的故障窗口在 UTC 12:37 到 17:05 之间错落重叠,三家状态页同时处于故障态的只有 78 分钟。根因无官方定论:媒体早期指向 Azure,官方口径指向别处——OpenAI 说是自家路由错误,SpaceXAI 为 Memphis 算力中心故障向「compute partners」道歉,而 Anthropic 五月刚租下整座 Colossus 1。这晚考的是多供应商 failover 的三个前提:故障域独立、健康信号来自请求、重试不放大故障。附一张云归属图的画法与每项代价。
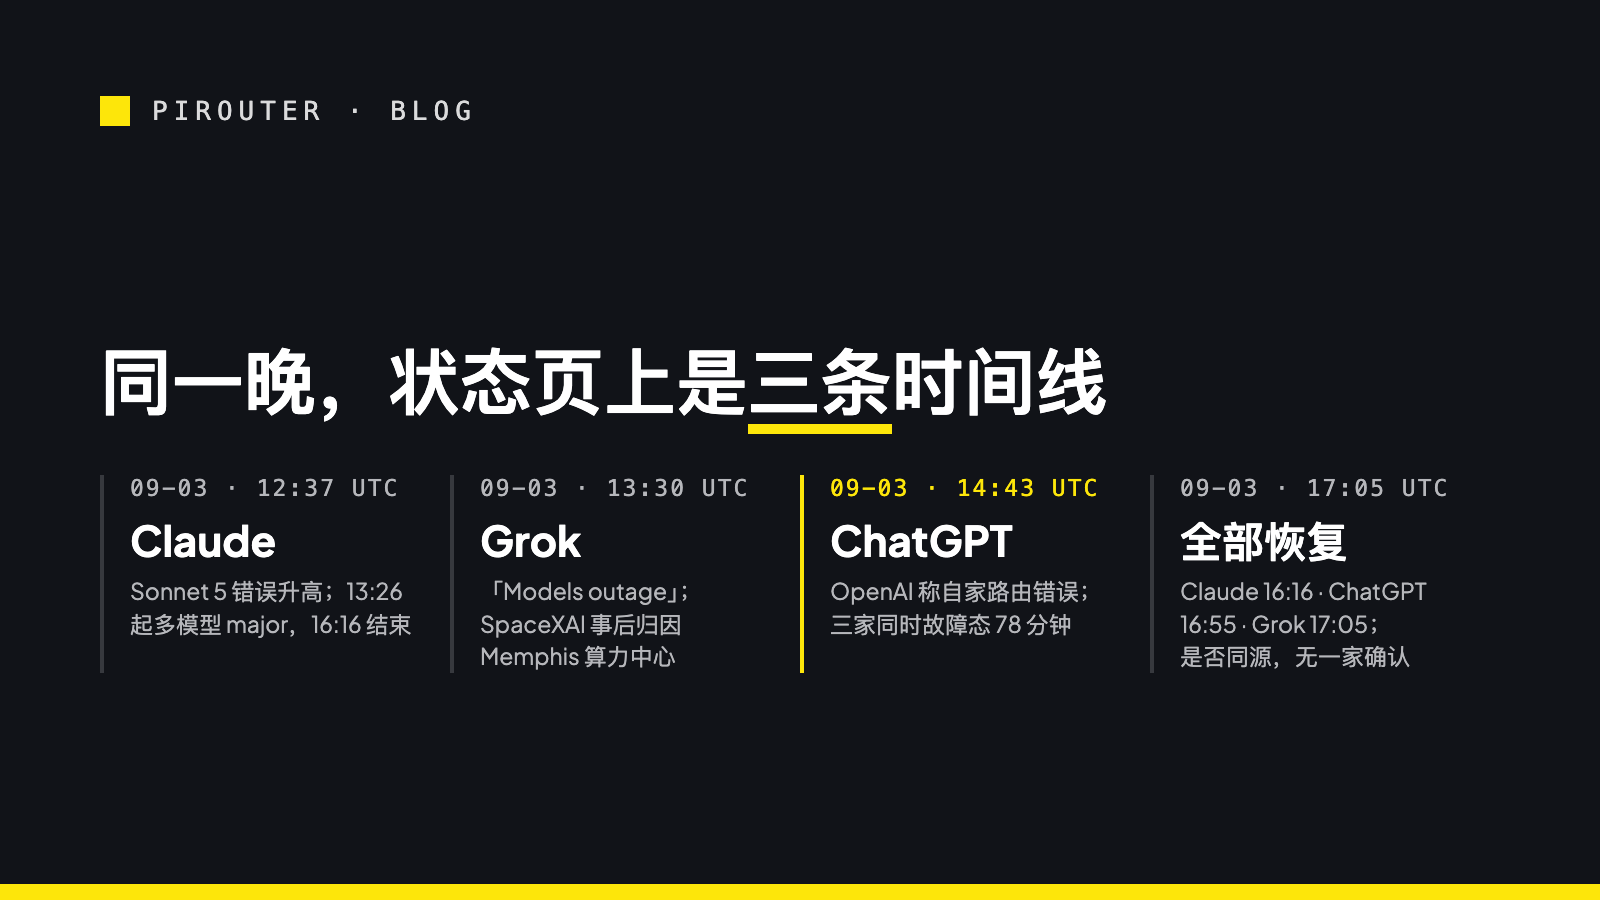
failover 没救到你,不是因为名单太短。多供应商 failover 成立要三个前提:故障域彼此独立、 健康信号来自你的请求而不是别人的状态页、重试不把别人的故障放大成你的。9 月 3 日晚 (北京时间 20:37 起)Claude、Grok、ChatGPT 的故障把这三条各考了一遍。把三家状态页的 incident 记录读下来,「同时宕机」其实是三条错落的时间线,真正重叠的只有 78 分钟。根因到 今天没有官方定论:媒体早期指向 Azure,官方口径却指向另一处。这篇按状态页时间线逐条对 这三个前提,最后给一张你今晚就能画的云归属图。
先说口径。下面所有时刻来自三家状态页的 incident 记录(UTC,括号里是北京时间),发言人的 话来自 WIRED 与 The Register 的直接引述;掘金上流传最广的那篇时间线只作对照。
状态页上的 9 月 3 日:三条时间线,不是一条
| UTC(北京时间) | 事件 | 出处 |
|---|---|---|
| 12:37(20:37) | Claude:Sonnet 5 错误升高,级别 major;12:56 恢复 | Claude Status — Elevated errors for Claude Sonnet 5 |
| 13:26(21:26) | Claude:Mythos/Fable 5.1、Mythos/Fable 5、Opus 5、Opus 4.8、Opus 4.6 错误升高,major;组件含 claude.ai、API、Claude Code、Cowork | Claude Status — Elevated errors for multiple models |
| 13:30(21:30) | Grok:「Models outage — Investigating」 | xAI Status — Models outage(Grok Web) |
| 14:43(22:43) | ChatGPT:路由错误开始(OpenAI 发言人口径,7:43 PT) | WIRED — Nobody Is Saying Why OpenAI and Anthropic Had Outages Today |
| 14:58(22:58) | OpenAI 状态页建立 incident:ChatGPT 与 Codex 错误升高,级别 minor | OpenAI Status — Elevated errors across ChatGPT and Codex |
| 15:17(23:17) | ChatGPT:修复上线(8:17 PT);15:50 状态页转 monitoring | 同上两条 |
| 15:25(23:25) | Claude:只剩 Opus 4.8 与 Opus 5 受影响 | Claude Status 同上 |
| 16:16(次日 00:16) | Claude:影响结束,16:23 标 resolved | 同上 |
| 16:55(00:55) | ChatGPT:resolved | OpenAI Status 同上 |
| 17:05(01:05) | Grok:resolved(10:05 PT,WIRED 转述状态页) | WIRED 同上 |
| 9/4 07:00–10:46(15:00–18:46) | ChatGPT:APAC 区域错误升高,minor,单独 incident | OpenAI Status — Users in APAC region may face increased error |
几个算术。三家的开始时刻相差 2 小时 21 分。三家同时处于故障态的窗口是 14:58 到 16:16, 78 分钟(OpenAI 按状态页建立时刻算;按发言人的 14:43 算是 93 分钟)。Claude 从 Sonnet 5 那条算起 3 小时 39 分,对得上掘金文里的「约 3 小时 40 分」;Grok 3 小时 35 分;ChatGPT 的 核心故障按 OpenAI 自己的口径是 34 分钟,状态页窗口 1 小时 57 分,级别标的是 minor。掘金文说 ChatGPT「恢复明显更慢」,状态页上能对应的是次日一条单独的 APAC incident,3 小时 46 分—— 是不是同一件事的延续,OpenAI 没说,我也不替它说。
掘金文引用的报告峰值(Grok、ChatGPT、Claude 各一个数)我没有找到可链接的原始快照,另一路 检索给出的分配方式与它不同,所以这里一个都不印。Downdetector 统计的是用户报告数;当晚 Cloudflare、Azure、AWS、GCP 四家的 Downdetector 页面同时出现尖峰,而 Cloudflare 明确否认,另外 三家的状态页干净(评论者 kibae 的观察,Hacker News — Ask HN: Why were OpenAI, Claude, and Grok simultaneously down?, 采集时 404 分、705 条评论)。人在找原因的时候,会把每一个可疑对象都点一遍。
根因:媒体指向 Azure,官方口径指向另一处
「多家媒体指向 Azure」是真的。Axios — ChatGPT, Claude and Grok all simultaneously hit outages 写的是「Microsoft Azure, which provides cloud services for all three models, is also experiencing outages」,这一句没有给出依据,「suggested」一词链向的是 9to5Google;9to5Google — ChatGPT, Claude, and Grok are all down in confirmed outages 写的是 Azure「also seeing a spike in outage reports」,随后补了一句「Microsoft says that this is not the case」。 The Register — ChatGPT, Claude, and Grok all had outages at the same time 去问了 Cloudflare,得到的回答是「any reporting that deviates from this is incorrect」,并指出 AWS、Google Cloud、Azure 三家状态页当天没有相关异常。
官方口径分三路。OpenAI 发言人对 WIRED 与 The Register 的说法一致:「A routing error starting around 7:43 am PT … made ChatGPT and Codex unavailable for some users」,8:17 PT 修复——自家 基础设施,没有提任何外部依赖。SpaceXAI 当天下午在 X 上道歉, Engadget — SpaceXAI apologizes for outage that affected Grok and other ‘compute partners’ 逐字转述:「We are sorry for the issues you may have experienced with Grok following an outage at our Memphis compute center this morning. We’d also like to apologize to our impacted compute partners.」没有说明原因。Anthropic 对 The Register 说是「an infrastructure issue」,对 WIRED 拒绝进一步评论。
然后是一件五月的公开事实。Anthropic 5 月 6 日宣布「use all of the compute capacity at their Colossus 1 data center」,300 兆瓦以上、超过 22 万张 NVIDIA GPU (Anthropic — Higher usage limits for Claude and a compute deal with SpaceX); Colossus 在 Memphis(SpaceXAI — Memphis)。把三件事排在一起:Claude 与 Grok 的故障窗口 13:26–16:16 与 13:30–17:05 几乎重合;SpaceXAI 说 Memphis 算力中心出了故障,并 向「compute partners」道歉;Anthropic 是 Colossus 1 的整租客户。没有任何一家把这三件事连成 一句话,WIRED 的标题因此叫「Nobody Is Saying Why」。我也不替他们连。能写的只有一句:如果 它们相关,名单上的 Claude 和 Grok 在 9 月 3 日就是同一个故障域;OpenAI 那 34 分钟按它自己的 说法是独立事件,恰好落在同一个小时里。
顺带一句。掘金上另一篇当晚发出的帖子,作者坦白时间线和原因分析是让 Gemini 生成的,里面有 BGP 抖动、级联过载、「自伤型 DDoS」,条条有鼻子有眼,条条没有出处 (掘金 — 天才陨落了!三大 AI 集体不可用!)。 这不是挑作者的毛病,他自己写明了来源。它说明的是另一件事:关于「为什么」的叙事永远比证据 跑得快,而 failover 配置恰恰不能建在叙事上。
不管最后哪种解释成立,对配 failover 的人教训是同一条:名单上有三家,你并不知道其中两家是否 共用一座机房。下面三节,一个前提一节。
前提一:供应商不等于故障域,先画云归属图
「故障域」(failure domain)在这个系列的第一篇里指的是「能一起 把你的服务弄停的那一组东西」。多供应商 failover 的隐含假设是每家供应商各是一个独立的故障域。 9 月 3 日之前,这个假设在多数团队的配置里从没被写出来核对过。
先把公开能查到的算力归属摆出来,只写有出处的:
| 供应商 | 公开的算力归属 | 出处 |
|---|---|---|
| OpenAI | Azure 保留 API 独占(「Azure API exclusivity until Artificial General Intelligence (AGI)」),但微软自 2025-10 起不再有算力优先购买权;2025-11 与 AWS 签 380 亿美元算力协议,用途含 ChatGPT 推理 | Microsoft — The next chapter of the Microsoft–OpenAI partnership;About Amazon — AWS announces new partnership to power OpenAI’s AI workloads |
| Anthropic | AWS 是「primary training and cloud provider for mission-critical workloads」;Google Cloud 最多 100 万 TPU;Azure 300 亿美元;SpaceX Colossus 1 整座(2026-05);另有 Fluidstack | Anthropic — Anthropic and Amazon expand collaboration for up to 5 gigawatts of new compute;Anthropic — Expanding our use of Google Cloud TPUs and Services;Anthropic 5 月公告同上 |
| xAI(SpaceXAI) | 自建 Colossus,Memphis | SpaceXAI — Memphis 同上 |
两点。第一,掘金文里「OpenAI 的推理全部跑在 Azure 上,这是公开事实」在 2026 年已经不成立: 公开协议写的是 Azure 拿 API 独占、微软失去算力优先权、OpenAI 另签了 AWS。第二,也是更麻烦 的一点:这张图会过期。你在四月画的 Anthropic 那一行没有 SpaceX,五月之后有了。供应商的 算力合同一年换好几次,你的 failover 配置多半一年不动。
还有一维叫地域。同一家云的单区域故障不是假想:Google Cloud 8 月 20 日 us-west1 故障
2 小时 22 分,9 月 1 日 us-central1-b 网络降级 4 小时 11 分,两份都是官方 incident report
(Google Cloud Status — us-west1 多产品降级,2026-08-20、
Google Cloud Status — us-central1-b 网络服务降级,2026-09-01)。
注意这两次的层级不同:us-west1 是一个 region,us-central1-b 是它下面的一个 zone。
这正是判故障域要分层的原因——两家都在同一个 zone,几乎一定是一个故障域;同 region 不同 zone,
要看它们是否共用该 region 的网络与控制面(us-central1-b 那次恰恰只打到一个 zone);同一家云
不同 region,多数时候是两个故障域,但控制面与全局网络是例外。能确定的只有一句:同云同 zone
就是一个故障域,不管它们的 logo 差多远;再往上,你需要的是证据不是直觉。
云归属图不需要工具,一个 YAML 就够。下面这段是记录用的形状示例,不是能跑的产品配置—— 字段名随你改,重点是填不出来的格子老实写 unknown:
# Cloud-ownership map — illustrative shape, not a product config.
# Fill a field only when a public source supports it; otherwise write "unknown".
providers:
  provider-a:
    compute: [azure, aws]            # public contracts as of 2026-09
    regions: unknown                 # the API response does not tell you where it ran
    cdn_edge: unknown
    source: "vendor press releases, 2025-10 / 2025-11"
  provider-b:
    compute: [aws, gcp, azure, spacex-colossus-1]
    regions: unknown
    source: "vendor announcements, 2026-04 / 2026-05"
  provider-c:
    compute: [self-built]
    regions: [memphis]
    source: "vendor site"
failover_policy:
  require_distinct: [compute]        # at least one target must not share this list
  review_every: 90d                  # contracts change; the map rots
代价写在旁边:一张全是 unknown 的图看起来很难堪,但它比一张全是猜测的图有用——它告诉你 名单上的独立性是未验证的,而不是让你以为已经验证过。90 天复核一次,每次半小时,读几份 新闻稿。
前提二:健康信号来自请求,不来自状态页
9 月 3 日的状态页有三处值得看。OpenAI 发言人说路由错误 14:43 UTC 开始,状态页的 incident 14:58 建立,中间 15 分钟;HN 上 14:51 UTC 已有人在问为什么 status.openai.com 上还没有 (评论者 tducret,在上文那条 Ask HN 讨论串里)。三家对同一晚的定级各不相同:Anthropic 标 major,OpenAI 标 minor, xAI 标 outage。The Register 对云厂商状态页的评语适用于所有状态页:「don’t always reflect problems in a timely manner」。
所以状态页是事后的文献,不是实时的信号。机制在这个系列的第三篇里 讲过:七家网关的 failover 触发条件全部是响应状态码,带 cooldown 的几家都靠计时器把供应商放回 轮询,没有一家默认在放回之前先探一次(LiteLLM 的健康检查路由是 opt-in 的例外)。反过来看,9 月 3 日对 failover 来说其实是容易题——三家返回的是真实错误, 不是那篇文章担心的「200 但内容变了」;只要你的 fallback 目标不在同一个故障域,按请求触发的 failover 在这晚是能工作的。没救到你的,大多是前提一。
信号从你自己的请求来。每个供应商与模型组合的错误率与延迟按分钟滚动;再加一路探针,走真实的 completion 路径、用独立的 key,让它的花费成为账单上独立的一行。代价:探针每天烧掉几百次最小 请求的钱,以及一个「探针说健康、用户说不健康」的调查时刻——后者比前者更常见。
前提三:重试不放大故障
HN 两条讨论串里都有人提出的解释是级联:一家倒了,用户和自动 failover 把流量倒向下一家,把下一家 也压倒(Hacker News — ChatGPT outage – Resolved 里 wavemode 的猜测,采集时 362 分、318 条评论;Ask HN 串里 Insanity 的说法相同,两人都自称是猜)。这个解释没有任何一家证实,OpenAI 明确说自己是路由 错误。但机制本身是真的,只是这次不一定发生了:这个系列的第二篇里 GitHub 8 月 17 日的事故,一个 token 服务被重试从每秒 7–9K 请求推到 70–100K,凶手是每一层都 合理的重试次数相乘。
放到多供应商 failover 里,问题多了一层:你的 fallback 目标,是别人的 primary。你在 Claude 报错的那一分钟把全部流量切到第二家,和你配置相同的几千个团队也在同一分钟切过去。第二家看到的 不是你,是所有人。
要做的事那篇文章写过四条,这里只重复与 failover 直接相关的两条,各带代价。一,重试预算按
供应商算,不按请求算——一个供应商在滑动窗口里只能拿到成功数的一成作为重试额度;代价是真故障
时更多请求当场返回错误,而不是「再试一次也许就好了」。二,fallback 目标也要有自己的预算和熔断,
不能无限承接主路的溢出;代价是你要接受「两家都不行」这个状态存在,并给调用方一个带
Retry-After 的 503,而不是让它自己再来一轮。
今晚就能做的三件事
一,画云归属图。把名单上每家供应商的算力归属、地域、CDN 边缘填进去,公开来源填得出的填, 填不出的写 unknown,标上日期。它只回答一个问题:名单上任意两家,有没有公开证据说明它们不共用 机房。
二,判定你现在的 failover 目标是不是同一个故障域,并把结论记下来。这一条今晚就能做完:
拿第一步的图,对着名单上每一对供应商回答「有没有公开证据说明它们不共用机房」。答案是「没有」
或「unknown」的,就在配置旁边标注清楚——换供应商是采购决定,不是今晚的事,但今晚可以让
下一个看这份配置的人知道它到底保了什么。真要换的时候,代价有三样,一并写在那里:
跨地域的延迟、两家之间的价格差、以及能力与参数差——第二家可能不支持你请求里的 response_format
或工具调用,四家网关对此的默认处理各不相同,这个系列的第四篇
的「决策 4」列了表。能力差比延迟更贵,因为它以 200 的形式出现。
三,给 fallback 配预算与探针,别让它只在事故时第一次被调用。一个月没跑过流量的 fallback, 鉴权状态、配额、账单三样都是未知数。我们自己的网关设计为把「算力供应商」当作与「模型供应商」 并列的故障域维度参与路由决策——同源探针、按故障域分预算——这是设计取向,不是已上线的承诺。
9 月 3 日晚上的教训不是「AI 不可靠」,也不是「多备几家」。是名单是给采购看的,故障域图才是给 值班的人看的;而后者,大多数团队今天还没有。