Lovable 数据暴露调查:登录了,不等于只能读自己的数据
一次 AI 建站数据暴露调查,把登录和逐行授权的差别摆上台面。用自有环境的权限矩阵检查 Supabase RLS、服务端访问与发布门禁。
封面:编辑部使用 GPT Image 生成的概念插图,非真实事件照片或产品界面。
一个应用有登录页,不代表每个人登录后只能读自己的数据;有些数据甚至可能在没有登录时就被送到浏览器。登录解决的是“你是谁”,逐行授权解决的是“你能读哪一条”。Crissy Field 的调查报告让这个区别再次引发讨论,但其样本不代表全部 Lovable 应用;以下验收方法只适用于你自己的、或已获得明确授权的环境,而不是对第三方站点的测试指南。
11 月 14 日的讨论,不是 11 月 14 日才发生的发现
这轮关注有两条时间线。研究者原文提到,相关发现已由媒体于 2026 年 11 月 2 日报道;它说自己给出了比该报道更新的数字,却没有写出研究页本身的首次发布或修订日期。11 月 3 日的后续报道也将早期媒体报道定位在 11 月 2 日。Hacker News 记录显示,指向研究页的帖子发布于 11 月 14 日。准确的表述是:旧有调查在这一天重新获得社区关注,不是凭帖文时间倒推出“新发现的零日漏洞”。
报告首先通过 Common Crawl 找到 159,041 个 Lovable 项目,来源跨度为 2025 年 12 月至 2026 年 9 月;其中 34,545 个使用 Supabase。研究者说,24,664 个站点在访客初次加载时、无需登录就会返回某些数据库记录。这个观察值得追问,但它本身不等于“24,664 个站点都泄露了私人数据”:商品目录、公告等内容原本就可能设计为公开。
研究者随后通过额外的只读请求,在这 24,664 个站点中的 7,403 个站点实际取得了含邮箱地址的记录,涉及 10,560 张表,约占这一层站点样本的 30%。这里的分母不是 159,041,也不是全部 Lovable 应用。报告明确警告,不应把 30% 当作已确认的泄露率,并说明抓取到的样本并不代表平台整体。读者不需要先相信一个夸张的普遍比例,才能认真对待敏感数据可能暴露的风险。
报告还举出某一处论坛超过 20 万条私聊消息、某一处机构超过 1,000 条包含身份证件详情的记录。这是研究者报告的个案数量,不是 20 万个受影响网站,也不是“1,000 本护照”。本文既没有核对这些应用的现时配置,也没有获取其中的记录;目前无法根据公开材料判断每一个所涉应用后来是否完成修复。事实边界先摆清楚,后面的工程决策才不会建立在传闻上。
一个登录页,到底替谁开了门?
设想一个虚构的预约应用:用户甲可以查看自己的预约,用户乙也能登录。页面先要求输入密码,看起来像是私密区域。如果后端只检查“请求者已登录”,它仍可能允许甲读取乙的预约。**认证成功只是拿到一张入场券;授权还要回答入场者能坐哪个位置。**这不是在描述调查中任何具体站点,而是说明两个条件为什么必须分别验收。
在 Supabase 的 Row Level Security 指南里,authenticated 只意味着调用者具有已登录身份。允许某种操作、以及这项操作可以作用于“哪些行”,仍要由对应的数据库权限与行策略决定。Lovable 的数据库访问文档也强调,用户数据的策略应把请求者与该行的所有者关联起来。换言之,“必须登录”并不是“必须是记录本人”。
还要区别第三种情形:页面没有显露数据,但浏览器初始化时拿到了本不需要的记录。视觉上把内容藏在按钮之后,和服务器根本不把越权数据返回,是不同的保护。验收时必须按实际响应与最终可见结果判断,而不只看页面上有没有“登录”字样;具体怎么测试,只针对你的测试环境和授权账号。
反过来,不能把“一次读不到”直接当成通过。测试账号可能没有任何数据,于是合法请求与错误授权都只得到空结果。更可靠的测试是事先为两个自有测试账号准备可区分的虚构记录:本人应该看到自己的那条,另一个账号不应该看到它;未登录时也不应该拿到受保护内容。允许的正例和必须拒绝的反例都要出现,否则你还不知道策略是否真的按人分隔。
自动扫描是提醒,不是替你签字的发布经理
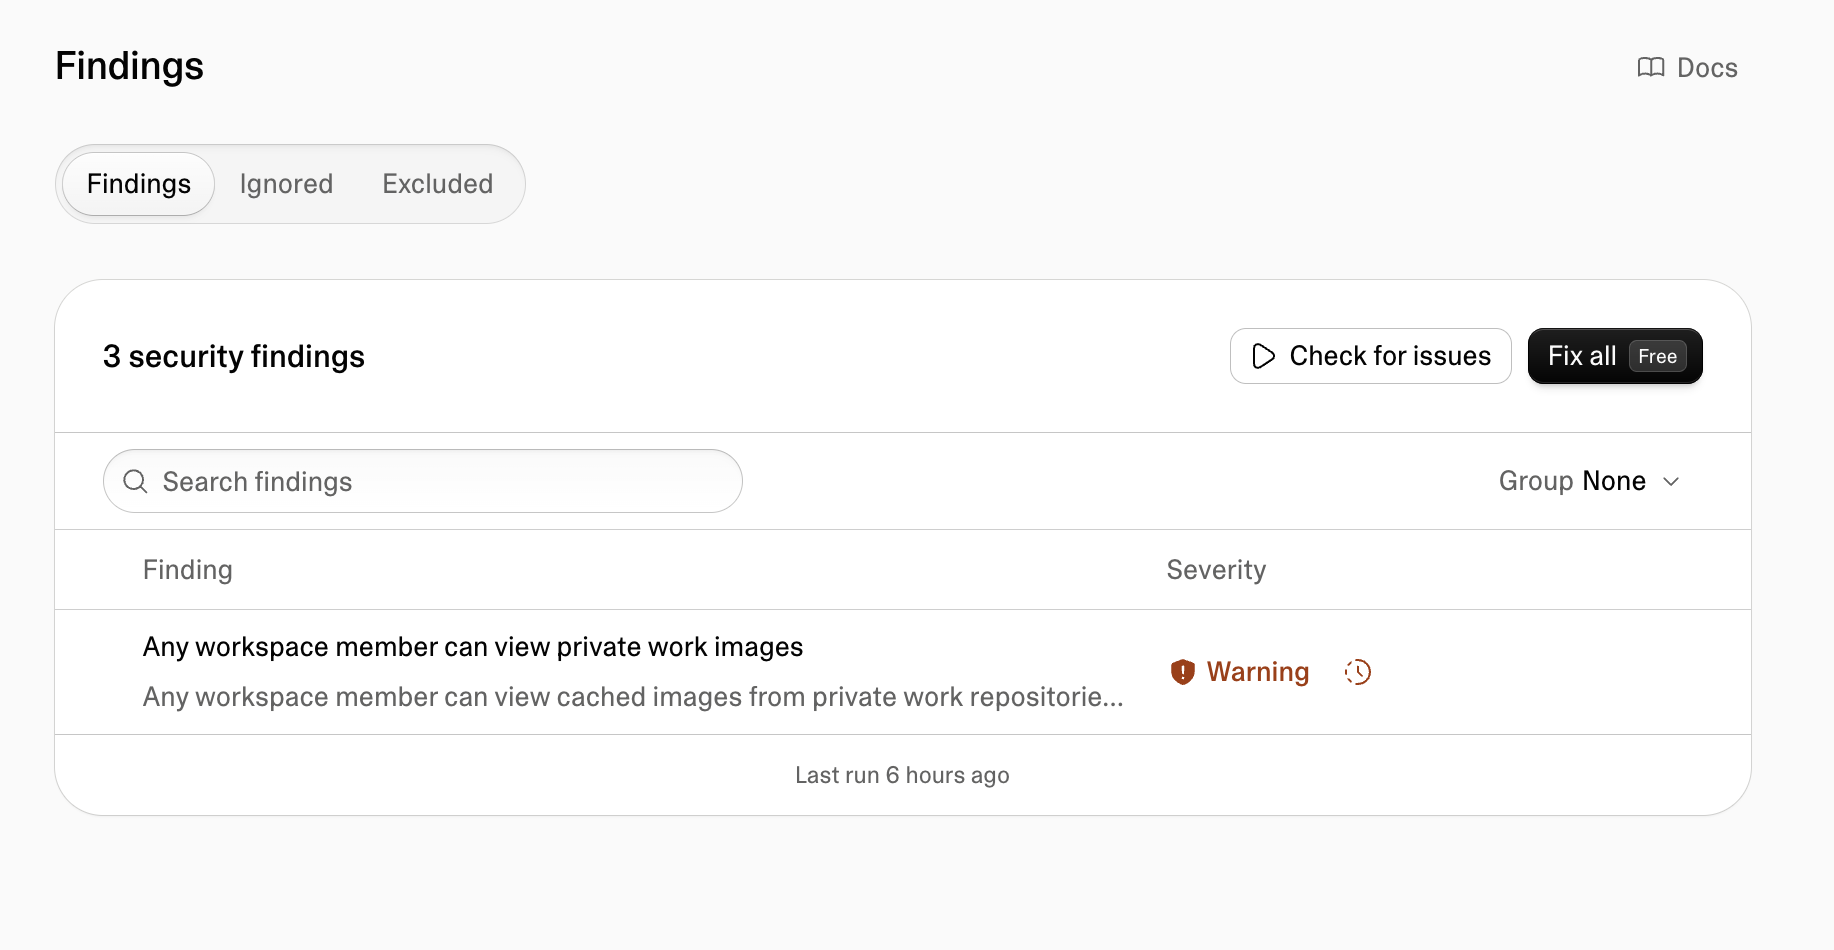
按照 Lovable 的 Security view 文档,Quick scan 每次发布时自动运行。11 月 10 日发布的厂商安全说明还称提供能在存在 critical findings 时阻止发布的控制选项。这两条描述证明平台有检测与发布控制能力,却没有证明某个工作区已经启用了阻断。自动扫描能减轻人工盲区,但不能凭“扫描运行过”推出“所有访问策略都经过业务确认”。
读公开文档时必须把证据限定在原文:我们核对的 Security view 页面未说明发布阻断的默认状态,也不能据此断言“critical 默认允许发布”或“critical 默认禁止发布”。对自己的工作区,应由发布负责人实际检查当前发布控制是否启用、哪类发现会拦截发布,以及允许谁处理例外;条件不明时,按团队自己的暂停规则先不放行。
扫描发现的问题还要落到业务判断。以虚构的预约应用为例,“公开可读”的产品目录与“仅本人可读”的预约记录可能处在同一数据库中。工具可以指出可疑配置,却不能凭表名理解团队对每一种数据作出的公开承诺。错误的修复也可能把本该公开的信息锁死,或让隐藏的数据走另一条服务端路径露出。因此,自动修复之后同样应重新验证预期行为,而不是把绿色提示当作业务验收报告。
还有一条很容易被 UI 遮住的边界。Lovable 的文档说明,策略视图供审阅但本身是只读的;通过具备 service_role 权限的服务端请求不受这些 RLS 策略约束。Supabase 的指南也说明了这种高权限路径。若应用有后台任务、管理员动作或代用户执行的服务端逻辑,它们需要独立的身份与操作授权检查。这里讨论的是你自己系统的设计审查,而不是尝试访问他人的高权限入口。
上线前,写一张能判“通过”或“退回”的权限表
小团队不必先建一整套复杂审计平台。挑出最敏感的两三类自有业务数据,为每类写下四个访问者:未登录、记录本人、另一名已登录用户、确有业务需要的服务端任务。再针对读取与修改分别填“允许什么、拒绝什么、为什么”。如果团队连公开目录和私密记录的界线都尚未约定,就先暂停发布,而不是让工具替业务作决定。
| 请求者(甲乙没有共享授权) | 读取甲的预约 | 修改甲的预约 | 读取乙的预约 |
|---|---|---|---|
| 未登录访客 | 不允许 | 不允许 | 不允许 |
| 用户甲 | 允许 | 按业务规则允许 | 不允许 |
| 用户乙 | 不允许 | 不允许 | 允许 |
| 已授权服务端任务 | 独立核验授权与业务目的 | 独立核验授权并留痕 | 独立核验授权与业务目的 |
这只是示例产品的验收条件,不是 Lovable 或 Supabase 的默认配置声明。表格要随真实业务调整:团队协作应用可能合法允许共享记录,客服可能需要有限范围的代理操作。关键是明确主体、对象、动作和例外的批准人。写明“共享给哪些人”,比含糊写“团队可见”更容易验证,也更容易在需求变动时发现权限扩大。
服务端一行也需要具体用例。仍以虚构预约应用为例:预约提醒任务只获准读取当天待提醒预约的必要字段,并写入发送状态;它不应提供一个可由普通用户触发、导出任意人的全部预约的入口。服务端负责人要分别验证前者正常完成、后者被应用层拒绝,再由发布负责人核对记录。这里的拒绝来自服务端授权逻辑,不能指望高权限角色自动受到 RLS 的保护。
在自有测试环境中,用两个授权测试账号和虚构数据逐项验证:该允许的结果确实返回;不该允许的跨账户结果确实被拒绝;未登录不能获取私有记录;写入后的归属没有偷偷变化。再检查同一种数据是否还有服务端任务或管理员流程。只测“别人看不到”却忘了确认“本人看得到”,会把一个坏掉的应用误判为安全;只测浏览器界面又会漏掉另一条调用路径。
每个发现只需保留足以复核的非敏感证据:哪一类数据、哪个角色、原本的预期、实际结果、修复者和复测结论。不要把真实用户记录塞进工单或截图。测试发现权限超出预期时,先纠正自己的配置和数据访问代码,再重复完整的正反向验收;一次修复可能同时改变合法用户的访问能力。
什么情况应当按下暂停键?
如果敏感数据的预期受众说不清、本人和其他账号的隔离不能证明、或者高权限服务端路径无人审查,就不要把“有登录页”“Quick scan 已跑完”当作发布理由。若出现 critical finding,最朴素的规则是先指定负责人、解释具体影响、修正并复测,再决定是否放行;团队应核对并按业务要求配置厂商提供的发布控制,同时指定维护例外与后续变更的人。
读完调查最容易得到的冲动,是立即给所有 AI 建站应用贴上“不安全”的标签。现有证据不支持这个推断,也没有证明报告涉及的应用已经全部修复。更有用的结论小得多,也更能执行:在自己的产品里,把“谁能登录”与“谁能读取哪条记录”写成两项独立的上线条件。下一次功能变更增加共享、后台任务或新数据类型时,这张权限表也必须跟着重做。