
Opus 5.5 真的变笨了吗?有人开始用同一道题连测 30 天
Opus 5.5 上线后的体感争论,Livenerf 试图用冻结题目、对照组和预注册门槛回答。截至 2026 年 10 月 2 日,公开进度仍只报告至基线第七天,没有漂移判定;读懂它能测什么、漏掉什么,以及自己该怎样保存证据。
Opus 5.5 上线后,关于“是不是变笨了”的争论,终于有一个项目愿意把同样的题连续测下去。但它还没有证明模型已经降智,也没有证明用户的体感是错觉:截至 2026 年 10 月 2 日核对,Livenerf 的公开 README最近带日期的采样报告仍停在 9 月 30 日,十天基线完成七天,后续对照窗口尚无结果。此后项目实际采了几天,公开资料没有告诉我们。
这件事有意思的地方不在七天的曲线究竟往上还是往下,而在它逼着一个流行的问题变得具体:同一道题、同一执行路径、同一验收规则,持续做了以后,成绩会不会稳稳地变?
一次失败,究竟是哪一层变了?
例如你上周让模型改一处 bug,测试一次就过;本周相似的改动,它绕了半天却没修好。失望当然真实,但两次并不是天然相同的实验。题目细节、积累在会话里的失败尝试、工具权限、CLI 版本,乃至你是否换过系统指令,都可能改变结果。反过来,不该用“都是心理作用”抹掉可以稳定复现的问题。
HN 的讨论把这些观察混在一起:有人讲特定时段的任务体验,有人提套餐额度波动,也有人提醒任务可能越来越难。额度消耗不是正确率;任务没做好,也不自动指向模型权重或服务端路由被改。讨论帖负责提出待验证的问题,不能替实验判原因。
有一个很容易被忽略的设置差异:官方 effort 文档写明 Opus 5.5 的 API 默认投入是 medium,前代 Opus 5 默认 high。直接横比两个型号而不显式指定档位,可能测到的是默认设置和模型能力的混合效果;但这个事实不能解释“同一型号隔几天变了”这种时间上的主张。Livenerf 显式传入 effort,不能说它忘记控制该项。分清“旧版与新版谁强”和“同一个版本随时间变没变”,是所有后续讨论的起点。前一个问题需要同时比较两个型号的质量与设置;后一个问题先得把一个型号的早期状态留住。错过了基线,再用“我记得刚上线时更聪明”做对照,就没有可复查的坐标。这正是 Livenerf 抢在发布后启动长期采样的理由。
把每天的九十次调用拆开看
项目 README记录:Opus 5.5 在 9 月 22 日发布,持续采样自 9 月 24 日 22:10 UTC 开始。作者从知识问答与竞赛数学等 2336 道候选题中,选出模型有时答对、有时答错的 78 道做主测,再用 Opus 5 跑 12 道对照题,所以每天共 90 个样本。选择“会摇摆”的题是为了让正确率变化有机会浮出水面,不是声称这九十道题覆盖全部工作。
测量路径同样关键:它用 Claude Max 订阅下的无工具 headless Claude Code 单轮调用,不是裸 API,也不是复杂的编码代理。作者固定题目、评分、CLI 与本地 harness;9 月 30 日的已公开进度称七天没有漏采,前七天使用相同 harness hash 和固定 CLI 版本,并把一天的预算防护例外记入偏差日志。做这些事是为了减少外部噪声,不是为了说服务端的每个环节都被锁住。
这里还有一处选样取舍:只测每次都答对的题,分数长期贴着天花板,小幅下降可能要很久才露面;只测从来答不出的题,同样难以观察。因此作者挑出“有时对、有时错”的题来提高敏感度。但代价是面板与人们日常工作的距离更远:你在意的代码审查、文件编辑与工具调用都没有进入这 78 道知识和数学题。设计越适合回答一个窄问题,越不能替全部用户体验作总体裁决。
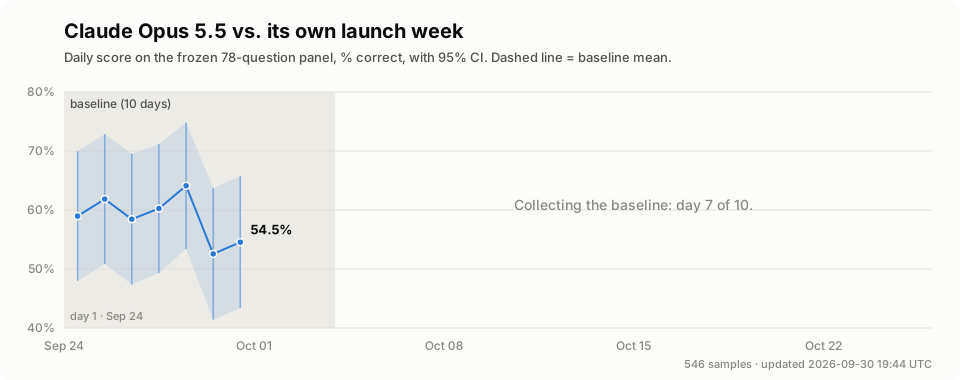
别让图上的横轴替你脑补数据。项目的最新 GitHub 提交在 10 月 1 日 17:20 UTC,但该次差异只把 README 中许可证的“尚未选择”改为 MIT,并没有公布第八天成绩。公开报告未更新,不等于内部一定停测;今天可以核验的事实仍只是最近一次公开进度为基线七天。Results 栏仍标 baseline collecting,不能拿它当已经出现的对照结果。
它要看到怎样的变化才会举手?
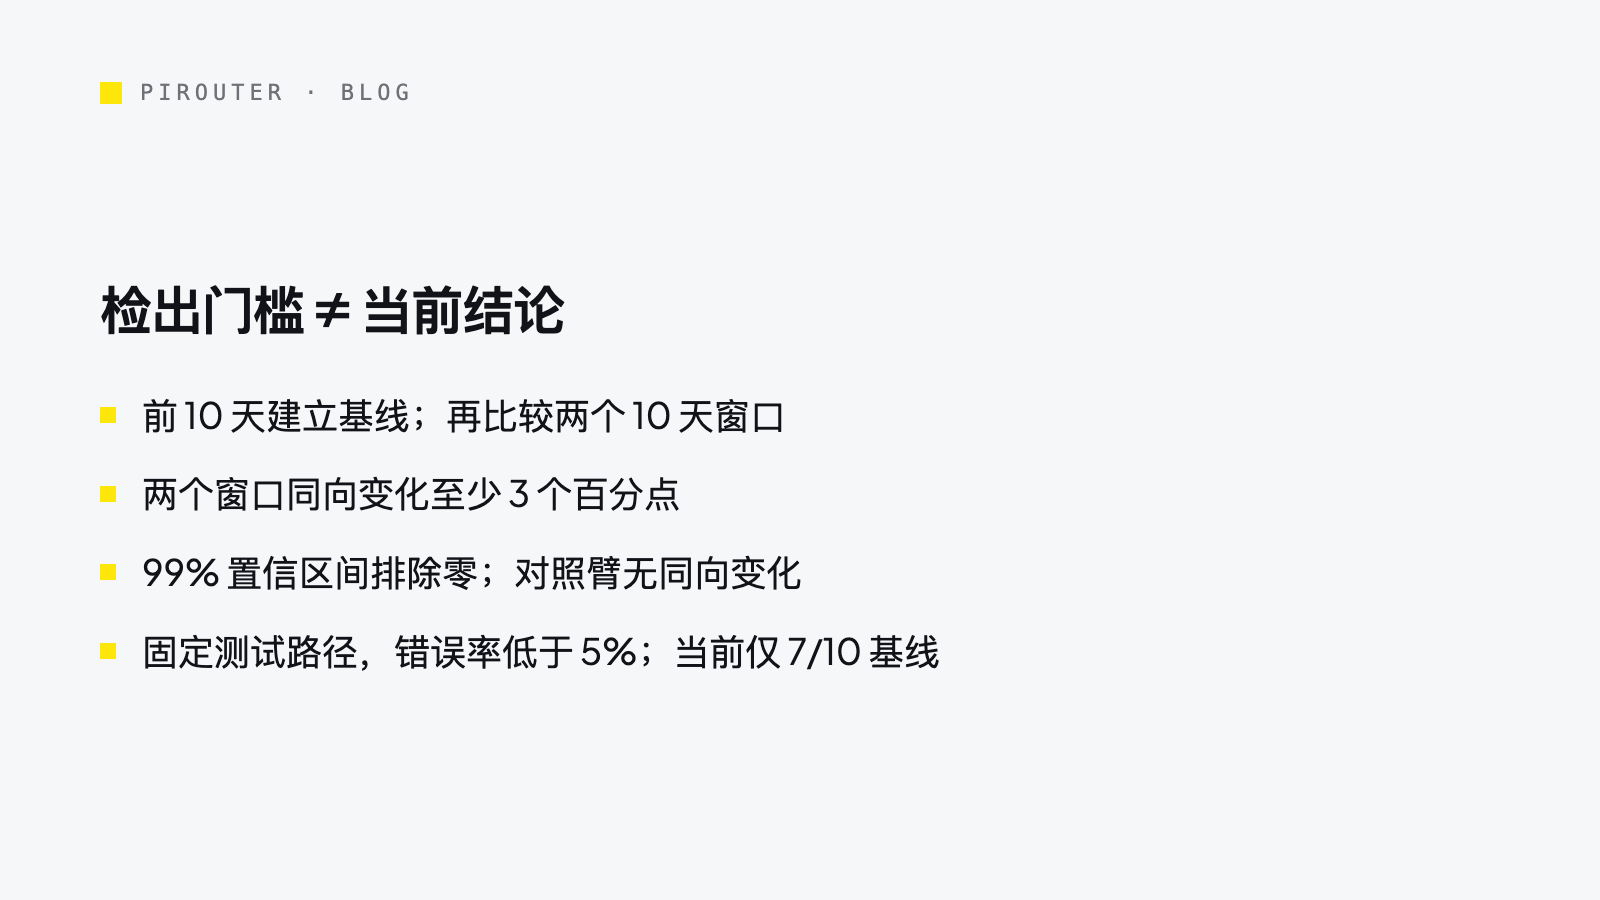
项目把规则写进了预注册协议:前十天建立基线,之后连续两个十天窗口都与之相比。每道题和它自己的基线配对,而不是把今天答对的难题和明天答错的简单题硬比。对一项会日常波动的能力,这比事后挑几张最陡的截图靠谱。预注册的意义还在于约束观察者自己:即使某一天出现很吓人的低分,也不能临时缩短观察窗口,或换一个宽松的置信区间来抢先宣布结果;如果出现上升或没有检出变化,同样按约定报告。项目在结果出来以前把裁决条件公开,读者才有机会检查它以后有没有移动球门。
要按协议报出变化,两个后续窗口必须同方向、每窗至少 3 个百分点、各自 99% 置信区间排除零;Opus 5 对照臂不能出现符合规则的同方向变化,还要满足 harness 一致、错误率低于 5% 等条件。假设两个窗口的点估计都下降了 4 点,其中一个区间仍跨过零,按规则也不能宣布检出。这是解释门槛的假设,不是项目已经测得的下降。
为何多一道 Opus 5 对照?假如两个型号同一天都异常,先检查共同的运行环境或执行链,比立刻说“只针对新版做了什么”更合理。作者也把每题输出 token列为次级信号:高、低 effort 的预先验证确实能改变输出量,说明这套仪器能看见某些已知的设置差异;但输出少不等于答错,预实验更不是已经抓住生产环境“降智”。尤其不能从一次 token 下降推测是“算力被偷偷收回”:答案长度、题目、失败重试、保护机制也可能影响读数。正确率与输出量要分别画时间线,再对照执行条件;其中一条单独变化,只能触发进一步调查。
按 README 的采集计划,完整基线和后续窗口需要时间,约 10 月 24 日是项目预计最早可能作判断的时间,不是已经兑现的发布日期。若实际采样进度后来改变,这个预估也要跟着改。
就算将来没有检出,争论也不会自动结束
项目预估,每个十天窗口对约 7.5 个百分点的差异才有较好的检出能力;它在预实验里连一次同家族型号替换也没有按自己的 99% 门槛区分出来。这不是设计失败,而是告诉我们“未检出”有多大范围:可能存在较小变化,或在别的任务切片里变化,而这套固定面板没有足够力量看见。
题库还有诚实但棘手的瑕疵:作者标出 8 道疑似错答案、30 道表述模糊的题,承诺对剔除相关题的版本做敏感性分析,而不是看到数字不合意才临时删题。知识、数学题的走势,也不能直接代表长会话、工具调用、图像理解或中文写作。此轮仓库没有可供我们下载并逐日复算的完整原始 .eval 日志;我们核对的是公开协议和进度公告,不是对九十道题的独立复测。
反过来,若未来真的穿过全部门槛,能说的是:在这套固定题、此时段、这个订阅版 Claude Code 路径里,项目检出性能变化。若要说“厂商暗改权重”甚至“有意降级”,还需要能识别原因的另一类证据。统计检出的是现象,不是动机。
同样要小心对照臂的解释。如果 Opus 5 与 Opus 5.5 都在同一天滑落,可能是共同的执行条件扰动;若只有主臂滑落,也不能直接证明某个模型文件被替换,因为防护、服务路由或只触发主臂的条件仍未被外部实验一一隔离。对照帮我们排除部分解释,不是能打开服务器内部的显微镜。文章的标题用了人们会问的“变笨”,正文得用测量能支持的语言回答。
手上已经有一次失败的人,不必等项目三十天走完才行动。把失败时的原始任务、预期结果与验收测试、日期、入口、模型、显式 effort、CLI 和工具版本、系统指令、上下文长度、token 与停止原因一起保存,再在同一道题上重复。只有长会话失败,先固定上下文;只有换 CLI 后失败,先比执行环境;若同条件反复失败,再向服务方提交脱敏且获授权的复现材料。
Livenerf 眼下最有价值的,不是一张能替你裁判的曲线,而是提醒我们把问题问准。个人体验可以是警报,预注册和重复测量则决定警报何时足以变成结论。等公开后续窗口真的出现,再看它抓到了什么——也看它无力覆盖什么。