Claude Fable 5.2 对上 GPT 和 Gemini:Arena 有分数,还没有同口径胜负
保存的 Arena WebDev 提取件中,Fable 5.2 标为 AutoEval,未列投票名次和票数。与 Gemini 4 Carbon、GPT-6.1 Sol 比较前,先分清评价类型、名次区间与开放范围。
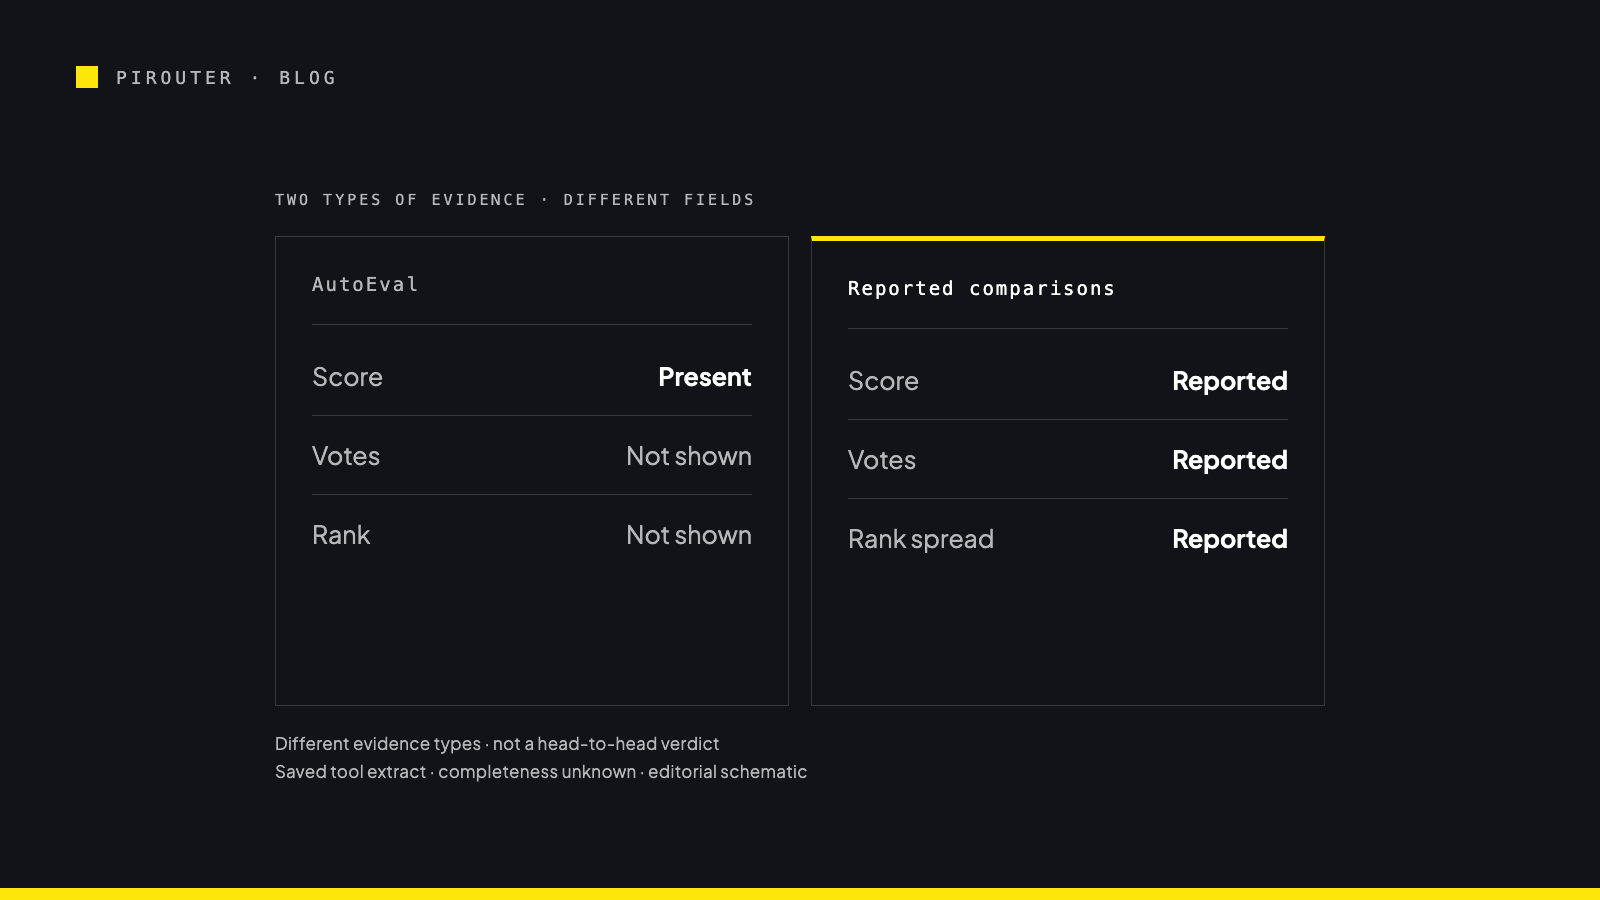
Claude Fable 5.2 已进入 Arena 的 WebDev 榜单,但现在不能据这几行宣布它击败了 GPT 或 Gemini。关键并非分数不够高,而是本次保存的提取件把 Fable 5.2 标为 AutoEval,未列出投票名次和票数;Gemini、GPT 条目则列有这些字段。这是一份值得细读的比较线索,不是一张能直接选出三方人类偏好冠军的成绩单。
Arena WebDev 的三行数字,分属两种证据
设想你要为网页开发代理选模型,打开 Arena Code Arena 的 WebDev 榜。我们在 2026 年 11 月 10 日 13:01 UTC 留存的 WebFetch 工具提取文本列出以下条目;这不是本站运行模型或保存的完整原网页。表中型号名称及括号内 effort 是榜单的显示名称,不应直接当成各厂商的 API model ID。
| WebDev 显示条目 | 提取件中的分数 | 证据标记 |
|---|---|---|
| Claude Fable 5.2 (xHigh) | 1832 ±18 | AutoEval |
| Gemini 4 Carbon (High) | 1768 ±15 | Preliminary,附比较次数 |
| GPT-6.1 Sol (Max) | 1743 ±10 | 附比较次数 |
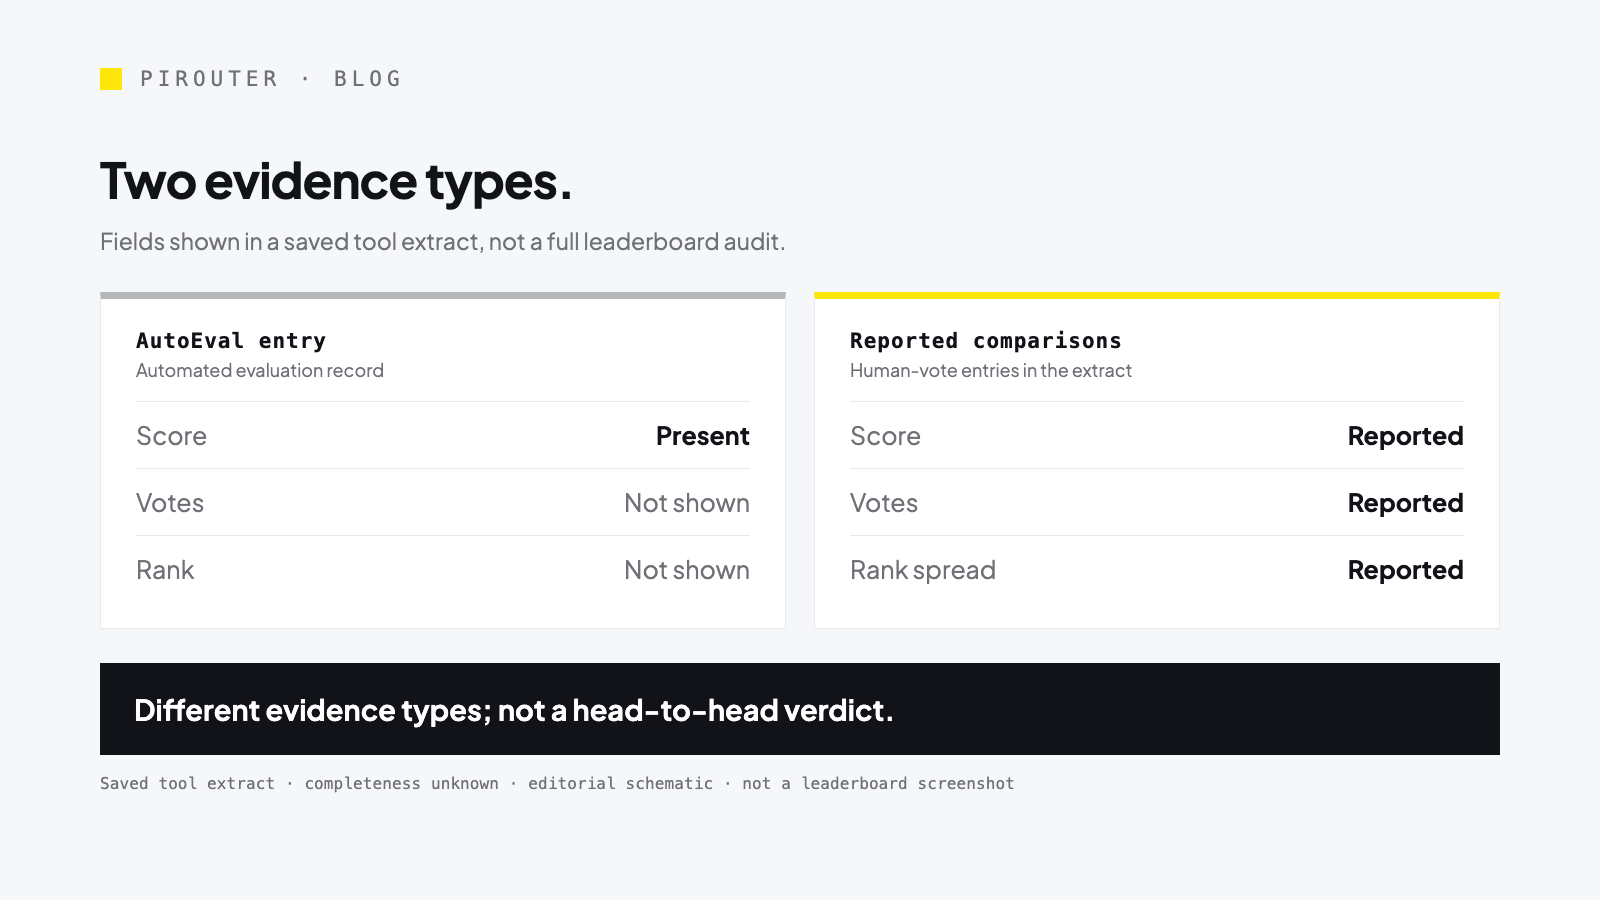
同一提取件中,Fable 的投票名次、比较次数和名次区间未列出。Carbon 显示第 3 名、2,128 次比较、名次区间 2–5;Sol 显示第 6 名、5,250 次比较、名次区间 4–7。这里的缺项只描述本次保存材料,不证明完整榜单或其他视图没有相关信息。
这张表的陷阱是把最上面较大的数字理解为『Fable 在真人投票里第一』。Fable 那一行没有给出真人投票名次或比较次数,我们也没有取得 Arena 对 AutoEval 如何计算、如何与投票评分对齐的完整定义。正确读法是:WebDev 页面显示了一个 AutoEval 结果和两个带参与比较次数的榜单条目;目前的材料不足以用三个数值排出共同冠军。这不证明 Fable 更弱,也不意味着它从未参加过其他类别的评估。
第三名与第六名,也不是确定的高下
即使只比较有投票名次的两行,名次也不是无误差的跑道终点。Arena 排名方法将 raw rank 按分数排序,而 rank spread 表示考虑分数不确定性后可能落入的名次范围;方法说明称,区间重叠的模型视为并列。Carbon 的 2–5 与 Sol 的 4–7 在第 4、5 名重叠。因此『页面列第 3 和第 6』是读数,『Carbon 确定胜过 Sol』却不是这份区间支持的结论。Arena 榜单指南也提醒,Votes 是参与比较的次数,不是赢的场数。我们未取得分数旁 ± 的具体置信水平和计算办法,不能擅自称作 95% 置信区间。
日期还有一道不能跳过的核对:Arena 更新日志记录 11 月 9 日加入 Fable 5.2 (xHigh) 的 WebDev 条目,但 WebDev 页面提取件显示的日期是 11 月 8 日。两处不一致,本文不把它们拼成『11 月 10 日统一更新的实时排名』。直接请求原站时返回 403,之后我们停止了该来源的访问,未取得原 HTML 来澄清这一差异;读者若看到后续变化,应以届时页面、类别和时间为准。
另一个容易混淆的入口是 Text Arena。Text Overall 与 Text Coding 不是 Code Arena WebDev;我们的可见提取文本被截断,未见 Fable 5.2,不能据此断言完整榜单没有它,也不能拿 Fable 5 或 5.1 的成绩替 5.2。网页开发、人类偏好中的编码问答和一般文本对话,本来就不是一项任务。
榜上型号,也不等于三个随手可用的『最新旗舰』
WebDev 这三行具体写的是 Fable 5.2 (xHigh)、Gemini 4 Carbon (High)、GPT-6.1 Sol (Max)。它们可以作为本次指定变体来讨论,却不能由榜单显示名称推断各家完整产品线、实际 API ID 或统一开放程度。尤其不能把 Sol 称为 OpenAI 唯一或最新旗舰:我们没有核到足够的一手官方定位,不用这个营销标签代替精确型号。
Google 的 Gemini 4 Carbon 公告发布于 10 月 28 日,称它是比 Argon 更强的模型,但当时仍是面向选定对象逐步扩大的有限预发布,并未给出面向一般开发者的公开 API 型号。若你今天需要能直接调用的对照组,先确认自己的组织、地区和入口实际能拿到哪一个版本;不要把『上榜』写成『人人已能采购』。榜单可比性之外,费用还要回到具体任务计算,参见Fable 5.2 与 Opus 5.5 的任务成本分析。
真要比较三家,先定义同一件事
假设团队在挑网页开发代理,与其找一个跨类别『总分』,不如先取同一批真实需求,固定输入、工具权限、超时与验收标准:页面能否运行、关键交互能否通过相同检查、人工审阅需要多少返工。每次记录实际 model ID、入口、effort、可用性和失败重跑;优先按相近配置看质量,再另看各产品默认配置的体验。先核各自账户和地区实际可采购的型号,为试选设费用上限,再按合格任务统计模型费、重试和人工返工。有限预发布型号若拿不到,就明确记为『未能测试』,不拿另一个型号填空。
如果问题专指 Arena 的人类偏好名次,下一步是等待 Fable 5.2 出现可核、同类别、同方法并有足够比较次数的条目,同时核对页面日期与方法更新。当前能下的结论更窄,却更实用:WebDev 给了三个值得跟进的具体型号,但还没有给出一场可据此宣布胜负的三方同口径投票对照。本文没有运行这些模型,也不把榜单读数冒充生产环境的选型结果。