
Jev 决策模型放在路由的哪一层?规则、语义路由、Jev、LLM 分类四层对照
Jev 是 TypeSafe 在 9 月中旬发布的决策模型,不生成文字,只回答 Choice、Score、Noul 三种带概率的题。它可以做路由判断,位置在语义路由和 LLM 分类之间。本文按延迟、成本、准确率、失败方式对照四层,说明选模型、要不要升档、请求是否敏感三类判断可以交给它,要生成参数、要给理由、要算数三类不行,并列出数据出境、限流、降级与校准这几件上线前要先想清楚的事。Jev 的数字均为厂商自报或第三方公布,我们没有实测。
Jev 可以用来做路由判断,位置在语义路由和 LLM 分类之间。 它是旧金山的 AI 公司 TypeSafe 在 9 月中旬发布的「决策模型」:你给它一段文本(state)和几道答案空间事先写死的题,它只回三种 东西:Choice(最多 255 个选项里挑一个)、Score(2 到 10 级的有序打分)、Noul(「是」的概率), 不生成一个字。放进路由里,它适合接「答案能提前列全、又得读懂语义」的判断,也就是选哪个档位 的模型、要不要升档、请求是否敏感;不适合要生成参数、要给理由、要算数的判断。价格与延迟 都是厂商自报:输入每百万 token 0.042 美元、输出免费、端到端 70–500 ms,在美国西海岸测 (TypeSafe: Introducing System One Models and Jev)。 我们没有实测 Jev,下文每个数字都注明是谁测的、在什么条件下。
Jev 是什么:一段文本进,三种带概率的类型化答案出
TypeSafe 把这类模型叫 System One,取自卡尼曼「快思考」的说法:只做几秒钟就能拍板的窄判断,
不做长链推理。一次请求放一个 state 和任意多道题,每道题独立、并行地算,官方说加题几乎不增加
响应时间(Introduction · docs.typesafe.ai)。
| 题型 | 问的是 | 返回 | 限制 |
|---|---|---|---|
| Choice | 从给定选项里选哪个 | choice、每个选项的概率、confidence | 最多 255 个选项 |
| Score | 落在你定义的哪一级 | 按概率加权的 score、各级概率、confidence | 2–10 级 |
| Noul | 这句话为真的概率 | noul(0–1) | 没有 confidence 字段 |
confidence 不是模型自述有多确定,而是从概率分布的形状算出来的:全压在一个选项上是 1,
摊得越平越低(Confidence)。
校准是它的主要卖点。用大白话说:它说「80% 是」的那一批判断里,事后核对,大约 80% 真的是。这是在一批判断上统计出来的性质,官方概念页 写明它不保证任何单条答案正确。后面所有「按 confidence 分流」的建议,都以校准在你的数据上成立为前提。
型号是 jev-1.13.0,规格见 Models 页:只按输入计费;
单请求 64k token,其中 state 加最长的一道题不超过 32k;只收文本;每账号每秒 25 万 token、
每分钟 1,200 次请求,并注明会随时调整。同一页还有两句与落地直接相关:Jev 不用客户数据微调,
所有账号共用同一套权重;英语是主要训练语言,包括 CJK 在内的其他语言「能处理但不一样好」。
发布博文写的是 early access,文档没有标注开放状态;取消候补名单是 9 月 20 日前后的事
(Jev News 转引的官方帖,2026-09-23 核对)。
掘金上争得最多的「不会幻觉」,准确含义是类型不会错:答案只可能落在你给的选项里。它不保证选对。
路由判断有四层,Jev 补上的是中间那一层
我在日文版那篇不调 LLM 做分流里拆过三层:规则、语义路由、 LLM 分类。语义路由的原理是把每条路由的示例句和请求都转成向量,看请求离哪条路由最近,够近才算命中。 那篇的数据来自 shogo_h 在 Zenn 发表的 semantic-router × Qdrant 实测: Raspberry Pi 5、52 问各跑一次,对照 LLM 是 gpt-5.6-luna(reasoning effort none)。规则层是我补测的。
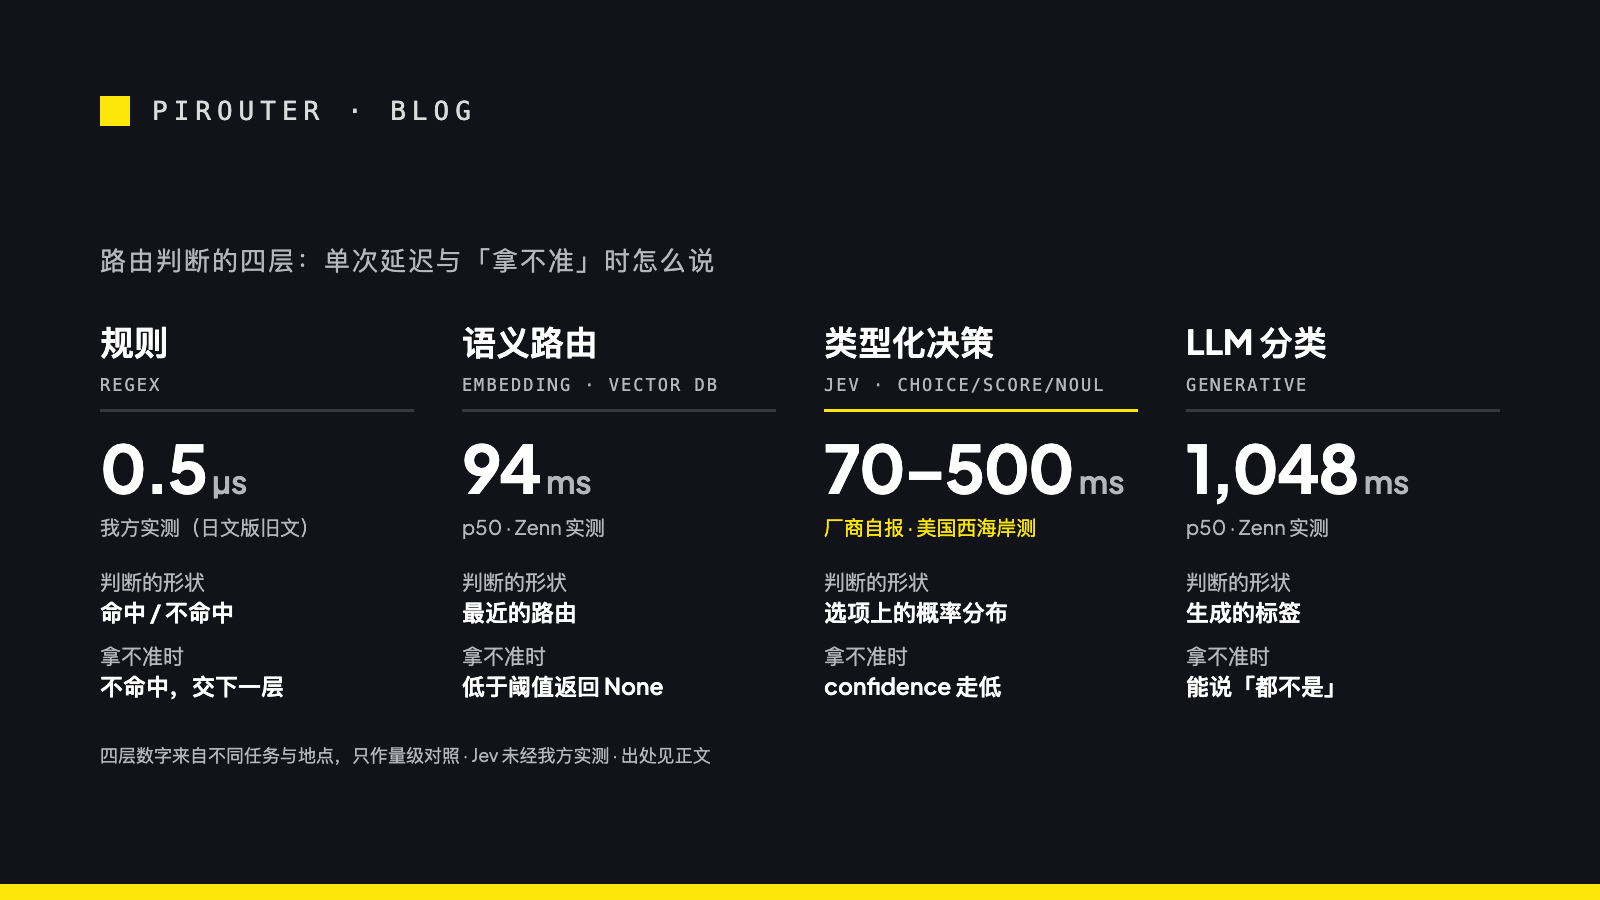
Jev 读语义像 LLM,只回有限答案像语义路由,还附上概率分布。下表不是 排名:数字来自不同任务、不同地点,只看量级。
| 层 | 判断的形状 | 单次延迟 | 1,000 次费用 | 准确率(旧文 52 问) | 典型失败 | 「拿不准」怎么表达 |
|---|---|---|---|---|---|---|
| 规则(正则) | 命中 / 不命中 | 0.5 µs(我方实测,看过错题后写的规则,仅 13 题) | 0 | 未测 | 换个说法就漏 | 不命中,交下一层 |
| 语义路由 | 最近的路由,或 None | p50 94 ms,其中 91 ms 是嵌入 API 往返(Zenn) | 约 0.0003 美元(旧文试算) | 67.5% | 相似度分数分不开对错;含明确关键词的句子也会分错 | 低于阈值返回 None |
| Jev | 选项上的概率分布 | 70–500 ms(厂商,美西);p50 约 250 ms(第三方,法国调用) | 约 0.023 美元(本文试算,见下) | 未测 | 字面理解;state 里的对抗内容能改答案;中文弱于英文 | Choice / Score 看 confidence;Noul 看概率 |
| LLM 分类 | 生成的标签 | p50 1,048 ms(Zenn) | 约 0.114 美元(旧文试算) | 100% | 慢 | 能说「都不是」,还能解释 |
第三方延迟来自 AbdelStark/jev-benchmarks。 Jev 的 0.023 美元是借用旧文 LLM 一侧每问约 540 输入 token 的计数、套官方单价算的,偏乐观。 两份第三方实测把区间撑开了:kikuziro 从日本直连、每次只问 1 题,实付约 0.044 美元 (Qiita);watany 经网关一次问 8 题、 输入 3,180 token,折合约 0.134 美元(Zenn)。 所以 Jev 每 1,000 次约 0.02–0.13 美元,比试算高到 2–6 倍,取决于 state 多长、一次问几题。 和小号的非推理 LLM(这里是 gpt-5.6-luna)比,它快约 4 倍、便宜约 5 倍;提示词一长、题一多, 优势会缩小。反过来,它比语义路由贵约 77 倍。按 540 token 算,1 亿次约 2,270 美元。
最后一列最值得看。语义路由能返回 None,不属于任何一类的请求有出口。Jev 的 Choice 必须在列表里
选一个,所以官方建议加一个 other;Noul 是绝对判断,可以对每个选项都给出低概率。
Jev「快几十到上百倍」要带着三个条件读
官方博文的原句是 40x–200x faster,限定在「System One shaped queries」;首页的 193.6x、444.6x 来自它自己的 workflow evals,博文紧接着注明这些数字大概在真实收益的高端。「20–200 倍快、 40–400 倍便宜」是创始人发布帖的 headline 口径 (The New Stack),不是文档口径。
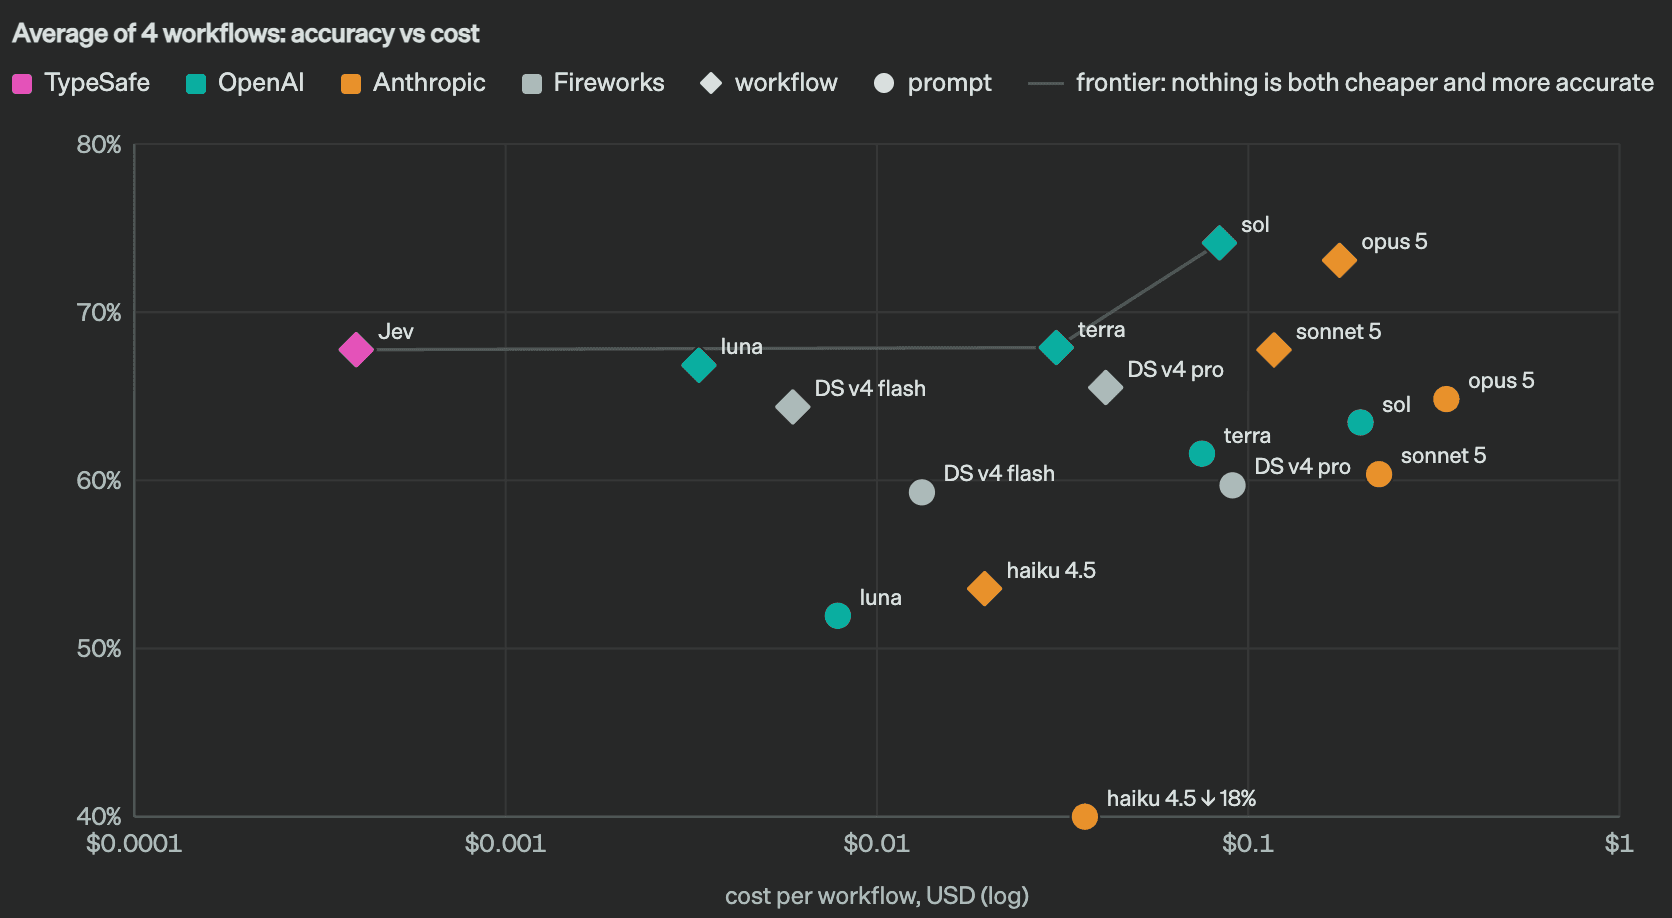
- 纵轴是一致率,不是准确率。 Jev 和两个参考大模型「想得一样」才算对。 Michał Chromiak 的对照文 读出:Jev 平均 67.8%、每件约 0.4 秒;GPT-5.6 Terra 67.9%、约 10.1 秒;最高的 GPT-5.6 Sol 74.1%。发票处理这一条上 Jev 只有 61.8%,几家 LLM 明显更高,说明平均数掩盖了单条 workflow 的差距。
- 比的单位和跑法都不是你的。 一件是一条拆好的多问 workflow;LLM 一侧经过 TypeSafe 的包装器, 官方承认这样更慢、更贵。倍数里既有 Jev 的快,也有对照组被加的重。
- 测量地点是美国西海岸,服务也在那里。 第三方从法国调用测到 p50 约 250 ms;从国内调用的 公开数字我没有看到。多出来的跨洋往返会直接吃掉一部分速度优势,要按你的机房位置重算。
Arcturus Labs 的 「Will OpenAI Eat Jev’s Lunch?」 (HN 采集时 291 分、207 条评论,2026-09-23)推测:Jev 可能就是一个常规 LLM,只读它第一步 对各选项词的概率,不往下写,壁垒在训练数据。作者还说已经找到 Jev 概率不成立的领域。推测未经证实, 但它提醒一件事:校准只在你的任务分布上成立,换了任务要重新验。
哪些路由判断适合交给 Jev:选模型、要不要升档、请求是否敏感
共同点是:答案能提前列全,依据在请求文本里,判错了有下一层兜住。一次请求问完:
from typesafe_sdk import Choice, Noul, TypeSafeClient

# Pin the version: thresholds tuned on jev-1.13.0 may not hold after jev-latest moves.
client = TypeSafeClient(model="jev-1.13.0")

resp = client.system_one(
    state={"request": user_message},
    questions={
        "tier": Choice(
            instructions="Which model tier can handle `request` well?",
            criteria={
                "small": "Lookup, rewrite or formatting; no multi-step reasoning",
                "large": "Multi-step reasoning, long code changes or an unclear spec",
                "other": "None of the above, or the request does not say enough to tell",
            },
        ),
        "sensitive": Noul(
            instructions="`request` contains personal data, credentials or payment details",
        ),
    },
)

tier = resp.choices["tier"]
if resp.nouls["sensitive"].noul > 0.5:      # placeholder threshold: calibrate on your own data
    route_to_review_path(user_message)
elif tier.confidence < 0.6 or tier.choice == "other":   # 0.6 is a placeholder too
    classify_with_llm(user_message)          # low confidence falls through to the next layer
else:
    send_to_tier(tier.choice, user_message)
选哪个档位的模型。 官方的意图路由范式 就是这个结构,intent 的 confidence 低于 0.5 转人工。放到模型路由里,低置信的出口应该接 LLM 分类, 而不是随手挑一档。
要不要升档。 更稳的问法不是事前猜「难不难」,而是事后问「便宜模型这次做错了吗」。官方 SDE cascade 示例(用的是上一版 jev-1.12): 小模型先抽取,Jev 对每个字段问一道「有错吗」的 Noul,任一超过 0.7 就升到推理模型。收益数字是 TypeSafe 的内部结果,形状值得抄,数字要自己跑。
请求是否敏感。 这一类要先过数据出境这一关。判断敏感,就得先把原文发到 TypeSafe 的 API, 服务在美国西海岸。已知事实:官方承诺不用客户请求训练,零数据留存(ZDR)只对企业客户开放 (Legal);国内主体能否注册、能否付款,截至 2026-09-23 我没有核实。 你的法务要确认的是:这类文本能不能出境、要不要先脱敏。可行的替代做法有两种:在本地先用规则脱敏 或粗筛,只把去掉敏感字段的文本送出去;或者这一题改用可以自托管的模型(见最后一节)。 另外,官方的 jev-1.13 已知问题页写明 state 里写来引导分类的文本能改变答案,所以即使能用,它也只决定「送审还是放行」,拦截仍靠规则和权限。
不该交给它的三类:要生成参数、要给理由、要算数
要生成参数。 改写提示词、给下游定一个具体的 max_tokens 或预算,都是生成,不是在列好的
选项里挑。官方说它没被训练去生成,硬用 Choice 串起来又慢又差。Score 也不能插值:文档明确说
可以拿 score 过阈值,但别用它反推两级之间的具体数值。
要给理由。 路由结果要进审计日志、要向用户解释「为什么转人工」,Jev 给不出一句话。 它的概率只说明有多确定,不说明为什么。
要算数。 同一已知问题页列了计数、数值比较、日期比较。「还剩多少额度」「是否在限流窗口内」交给代码。
还有一条跨题型的坑,同样出自官方。第一张工单「尺码不合适,我有什么选择?」,问「客户在要退款吗」: Noul 给 0.22,写成是 / 否两个选项的 Choice 给「是」0.01、confidence 0.97。第二张工单「同一笔订单 扣了两次款」,「要退款」和「不是要退款」两个 Noul 加起来是 1.19。在 Noul 上调好的阈值不能搬到 Choice 上,反过来也一样。
数据不能出境或不想被锁定:开源 Laya 能顶到哪一步
锁定面有三处:私有接口、阈值绑定版本、不能微调。
Laya(Apache-2.0)是目前最完整的开源对照:同样三种题型,
编码器加判别头,一次前向答完所有题。它的 README 写明自带服务讲的是同一个 POST /v1/systemone
协议,现有 Jev 客户端改 baseUrl 即可,这就是一条退出路径。答案不会一样,阈值要重新校准。
| Jev(托管) | Laya(自托管) | |
|---|---|---|
| 模型 | 结构未公开 | 英文版 ModernBERT-large 421M;多语言版 mmBERT-base 322M |
| 单题延迟 | 厂商 70–500 ms;第三方 p50 约 250 ms | T4 GPU 上 33–40 ms;笔记本 CPU 约 330 ms |
| typed-decisions 基准(多数类基线 0.461) | 0.727(Laya README 引用的公布值) | 基础版约 0.36;0.766 来自在该基准训练集上微调的版本 |
| Banking77 | 0.870(72 个标签) | 0.425(77 个标签),作者建议单题不超过约 20 个选项 |
语言要单独说。Laya 英文版遇到非拉丁文字会崩,而且仍然高置信:高棉语准确率 0、置信度 0.952, 所以要先按文字路由到多语言版。在 MASSIVE 20 类意图的简体中文子集上,两版都在 0.62–0.63。 社区贡献的中文职场消息诊断 是另一组参照:64 题、4 个标签,场景和参考标签都由 AI 辅助编写,没有独立标注;2026-09-21 快照里 单选题 Laya 多语言版 20/64,Jev 64/64。在这组 64 题合成诊断上,Laya 基础版不经微调判中文 明显落后。它的价值在能用自己的数据微调、能本地跑、数据不出机房,代价是训练和评测的工你自己出。
Jev 上线前的五件事:校准、限流、降级、版本、实测延迟
我们在做 LLM 路由服务,这一层正是我们每天在想的问题,所以这篇只谈判据,不谈我们自己。
- 先校准,再定阈值。 从真实流量抽样,人工标真值,按 confidence 分桶,看每桶实际对错率是否 随 confidence 单调上升,再按判错的代价定阈值。分桶数要配样本量:50 条样本切 10 桶,每桶只有 5 条,看不出东西,切 3 桶更实在。标注最贵,按几百条、一人几天准备。
- 按峰值算余量。 每分钟 1,200 次约等于每秒 20 次,而且会随时调整。路由在热路径上,峰值超过 这个数就要合并请求或申请企业额度。
- 把降级写进代码。 Jev 超时、返回 429 或 5xx 时,回落到默认档位或 LLM 分类,而不是让请求卡住。
- 固定
jev-1.13.0,不用jev-latest。别名会移动,阈值会跟着失效,日志里却看不出来。 - 在你的机房位置测 p50 和 p95,数据出境与脱敏的结论也在这一步一起拿到。