Qwen4-Max 正式版来了:从限时预览迁移,不能只删 -preview
Qwen4-Max 11 月 16 日上架正式型号与 API 价目,限时预览仍在 11 月 25 日退役。逐项核对模型 ID、Token Plan 与按量 API 入口、思考档、输出预算和缓存计价;不将官方宣称当作本站实测。
封面为 AI 生成的迁移概念图,非实际界面或官方素材。
Qwen4-Max 现在有正式型号 qwen4-max,但把两周预览用的 qwen4-max-preview 删掉后缀,并不等于完成迁移。 11 月 16 日,阿里云把正式型号列进上架表与默认按量 API 价目;11 月 11 日开放的预览则仍是 Token Plan 专用入口,并定于 11 月 25 日结束。要决定是否切换,至少重新核对模型 ID、Key 与 Base URL、思考档、生成预算和缓存价格;以下是官方文档的逐条对读,不是本站已经调通或验过账的记录。
如果你上周按此前的预览说明给编码工具接入了短期型号,今天最容易做错的动作很简单:只改配置里的模型名,其余复制。这样做在五个层面都有可能产生误判。最明显的是价格:发布文里每百万输入 token $0.075,但它专指缓存命中;新加坡常规输入公开价是 $1.50。看起来同一张账单,实际不是同一栏。
11 月 16 日的正式型号,是给预览加了一个新名字吗?
不能按简单更名迁移:两个 ID 的入口与规则不同,底层 checkpoint 是否相同则尚无保证。阿里云11 月 16 日的发布公告说 Qwen4-Max 可以通过 Token Plan 与 API 等入口使用;新模型上架记录则把正式 ID 明确写为 qwen4-max。与此同时,预览型号文档仍列 qwen4-max-preview:从北京时间 11 月 11 日 10:00 到 11 月 25 日 24:00,随后退役。该文档现也直接推荐已经可用的正式版。这是两个并存但期限、入口和参数说明不同的 ID,不是一条模型名在 11 月 16 日自动改写成另一条。
旧稿记录的是当时“只准 Token Plan 试用、正式条件尚未公布”的状态,今天的新材料填上了此前缺的正式 ID 与价目。它并没有倒过来使上周的预览变成按量生产型号。若你的代码、团队配置或使用手册里还留着 qwen4-max-preview,需要计划它的退出;但也别把截止时间写成整个 Qwen4-Max 产品的退场时间。日期只约束预览 ID,正式版文档没有给出同一终止日。
这还留着一个重要空白:两个型号是否恰好对应同一 checkpoint、提示词行为能否保持一致?上述文档没有给出这样的等价保证。正式版有独立型号、规格与默认设置,因此在结果、延迟和费用上均应重新观察,而不是把旧测试结论复制粘贴过来。我们也没有调用任一型号做等任务复测。
换 ID 之前,Token Plan 的 Key 和 API Base URL 要怎么分开?
假设一个开发者曾在交互式编码工具中用预览型号试过几次,接下来想让自己的应用服务持续调用正式版。这里有两道分开的门:拿哪个型号,以及从哪个账户、凭证和主机进入。预览文档明确说,预览仅通过 Token Plan 访问,不支持按量。正式型号则同时出现在Token Plan 个人版支持清单及默认按量 API 价目表。所以“正式型号”也不等于“旧订阅凭证突然拥有所有用途”。
对新加坡区域,官方 Base URL 清单给普通 API 与 Token Plan 两个不同主机:前者是 dashscope-intl.aliyuncs.com,后者是 token-plan.ap-southeast-1.maas.aliyuncs.com。OpenAI 兼容协议在各自主机后加 /compatible-mode/v1;Anthropic Messages 兼容协议则加 /apps/anthropic。主机选择来自账号的计费入口,协议路径来自客户端实际发送的请求格式。单单把 URL 的 token-plan 字样删掉不会替你换 Key,也不会核对你的客户端到底用的是 Chat Completions、Responses 还是 Messages。
Token Plan 的个人版条款把用途限定为兼容编码或 agent 工具的交互式使用,明确排除自动化脚本、非交互批处理和自定义应用后端;团队版条款也有同类限制。如果想让后端承接应用流量,不能因为订阅清单也列有 qwen4-max 就沿用订阅 Key。反过来,不能把订阅用途限制误写成普通按量 API禁止应用后端;那是两份服务入口、两套条件,须按自己的账号和场景分别审。
需要区分服务地域。新加坡文档的普通 API 与 Token Plan 示例只服务于在那里开通的对应入口;北京、香港及其他部署地点有各自的范围与设置,不要为了照抄示例跨区送请求。尤其已有数据驻留要求时,先确认账户、区域和部署范围,再谈同一个模型 ID。上周在订阅工具里能返回一个答案,只证明那个配置在当时的资格范围内工作,不能作为新主机、新 Key 和应用调用合规性的验收。
思考档位和输出预算,哪些旧配置不能直接沿用?
两个型号都有 1,000,000 token 的上下文长度,但这不足以推出“请求能输入整整一百万”,也不足以推出可见答案一样长。正式版的模型规格页进一步列出,思考模式最大输入 983,616 token,非思考最大输入 991,808 token。这是技术上限,不是建议把文档尽量塞满的目标。实际请求还要给生成和工具回合留空间;价目表的“单次输入 0–1M”是计价区间,不是对输入技术上限的新承诺。
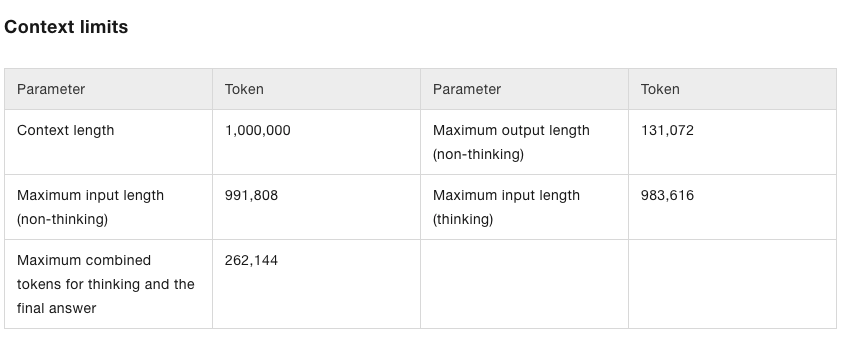
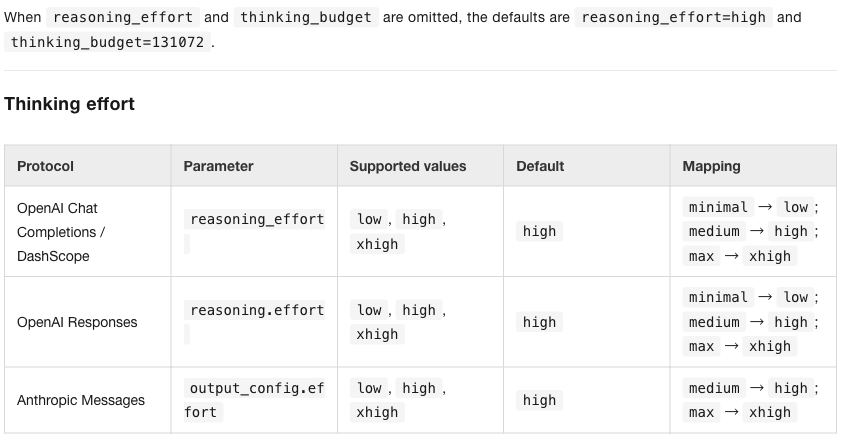
预览版的规格页曾写:思考与最终回答共享的最大生成预算为 393,216 token,reasoning_effort 可选 low、medium、xhigh,默认 xhigh。正式版的Thinking effort 表列主档 low、high、xhigh,默认 high;但它并非简单拒绝旧档值:OpenAI Chat Completions / DashScope 的 reasoning_effort 与 OpenAI Responses 的 reasoning.effort 均将 minimal 映射为 low、medium 映射为 high、max 映射为 xhigh;Anthropic Messages 的 output_config.effort 将 medium 映射为 high、max 映射为 xhigh。因此迁移时重点是显式核对映射后实际档位与默认值,而非宣称 medium 一定报错。在思考模式,262,144 token 是思考加最终回答的合计上限,文档列出的默认思考预算为 131,072;非思考模式最大输出 131,072 token。这些数字不能都叫“最长回复”:它们有不同模式和预算分配含义。
| 核对点 | 预览 qwen4-max-preview | 正式 qwen4-max |
|---|---|---|
| 上下文 | 1,000,000 token | 1,000,000 token;思考/非思考最大输入另有上述上限 |
| 思考强度 | low / medium / xhigh,默认 xhigh | 主档 low / high / xhigh,默认 high;官方将 medium 映射为 high,不是拒绝 |
| 生成预算 | 思考+回答最大合计 393,216 | 思考+回答最大合计 262,144;非思考输出最大 131,072 |
| 这意味着 | 旧工具若依赖默认档,需记录旧行为 | 显式 medium 的语义按协议映射为 high;没传参数时,默认档也已改变 |
表中的 393,216 和 262,144 都不是保证最终读者能看到的字数。一项工具任务如果需要大量内部推理、工具调用和长篇答复,更大的规格也不能替你证明中途不会截断。把预览时期设置的高 max_tokens 或长回复期待值挪到正式版时,先核客户端所用协议对应的字段说明,再用可回退的小样本观察响应、截止原因和账单。官方列出 OpenAI Chat Completions、Responses 与 Anthropic Messages 等入口,但列出兼容接口不意味着所有参数名、思考块和错误响应逐字段等价。
还有一种更安静的变化:如果原来没有显式设置 effort,预览的默认 xhigh 与正式版的默认 high 就已经不一样。任务成本或表现若随之变化,不能单凭新版号说是模型本身变快或变差;先固定档位,记录生成 token、耗时及可接受结果,再决定要不要调整。若原配置显式写 medium,官方映射就是 high;它不是“字段不被接受”的故障,但原先按预览语义判断表现的脚本仍应复核。尤其三类协议的参数路径不同:Chat Completions / DashScope 用 reasoning_effort,Responses 用 reasoning.effort,Messages 用 output_config.effort。跨协议迁移时,不应只搬运字段值。
Qwen4-Max 的 $0.075 为何不能写成“普通 API 输入价”?
答案藏在发布文的括号里:“Input (Implicit Cache Hit)”。11 月 16 日官方价目表把新加坡 International 的正式 qwen4-max 放在单次输入 0–1M token 一档,美元/百万 token 的常规输入 $1.50、输出(包括思考与最终答复)$4.50。隐式或显式缓存读取命中的输入才是 $0.075。若使用显式缓存,创建缓存还有写入价格:5 分钟 $1.875、1 小时 $3.00/百万写入 token。所有价格都要先写清地区、服务入口和 token 类别,再讨论“便宜”。
上下文缓存说明写得更像一份条件合同:支持的请求上,隐式缓存自动工作,不能关闭;共享前缀至少 1,024 token 才有资格尝试命中,但达到长度不保证命中。没命中的部分仍按常规输入价;输出照输出价收。显式与隐式模式也不能在同一请求里混用。Qwen4-Max 的缓存价格是通用折扣比例的例外,因此用另一款 Qwen 或缓存文档中的一般百分比去反推它,会得到错误预算。
如果选择显式缓存,还要分清写入与读取。例如把一个常用长前缀标为 5 分钟缓存,首次创建不应按“读取命中 $0.075”给这部分输入做预算;新加坡价目另列 5 分钟写入 $1.875/百万、1 小时写入 $3.00/百万。此后是否命中,要看请求前缀及缓存有效期,不能只因客户端传了缓存标记就把每次都计成读取价。这里也不是建议所有团队都改用显式缓存:既然显式与隐式互斥,切换策略会改变费用构成,先核自己真实负载是否有足够稳定且重复的前缀,再比较包含创建费用的每次完成任务成本。缓存命中率的分母应是实际发送的对应输入 token,不是“用了多少次 API”。
在 Token Plan 一侧,订阅文档说消耗的是 Credits,用量受型号、token 数、思考档和工具调用影响;没有给你一条“每美元等于固定 Credits”的通用换算。将按量 API 的 $1.50/$0.075/$4.50 直接填进团队订阅成本表,或者把订阅剩余额度当成按量账户余额,都会把两份合同算到一张纸上。预览版只在前一份合同里;正式版能进入两种入口,究竟哪种对你可用,先看 Key、账单与使用范围。对管理员来说,同一位成员在订阅里试了多少 Credits,和应用后端的普通 API Key 在另一账单里花了多少美元,都是需要分别记录的数;不能因为两条记录显示同一型号就把它们当成一种折扣套餐。
该价目是新加坡的公开标准价,不是所有地区、所有账户的承诺价。官方列表另列北京、香港、法兰克福、弗吉尼亚与东京等地点,区域范围和价格行有区别;登录后的活动优惠或账号结算条件也可能不同。已经在某个区域采购的团队,应拿自己的区域价目和账单做最终复核,不拿新加坡的三列数推算人民币或跨区成本。
一笔假设账单,为什么比“任务成本降 60%”更适合迁移决策?
假设某类请求每次有 40,000 个输入 token,其中 36,000 个确实命中隐式缓存、4,000 个按常规价计,另产生 1,500 个输出 token,其中的思考也算在输出里。仅按上述新加坡标准按量价计算,单次费用为 36,000×0.075/1,000,000 + 4,000×1.50/1,000,000 + 1,500×4.50/1,000,000 = $0.01545。若同样长度的输入全部未命中,在输出仍恰为 1,500 token 的纯算术假设下是 $0.06675。一千次分别为 $15.45 和 $66.75。这不是我们的实际账单,也不是承诺任何请求会有九成命中。
为何给出两个端点而不是只展示便宜的一边?36,000 token 的共享前缀超过最低门槛,但缓存文档明确说不保证命中;多轮工具调用中,如果前缀、工具定义或历史发生变化,命中结构也可能变。这组简算没有显式缓存写入、额外工具回合、失败重试、税费或优惠,且将两种情形的输出 token 固定不变。真实任务要从自己的 usage、账单和结果可接受率回算。若你没有大量可重用前缀,不应让一个“命中价”占据预算表全部输入栏。
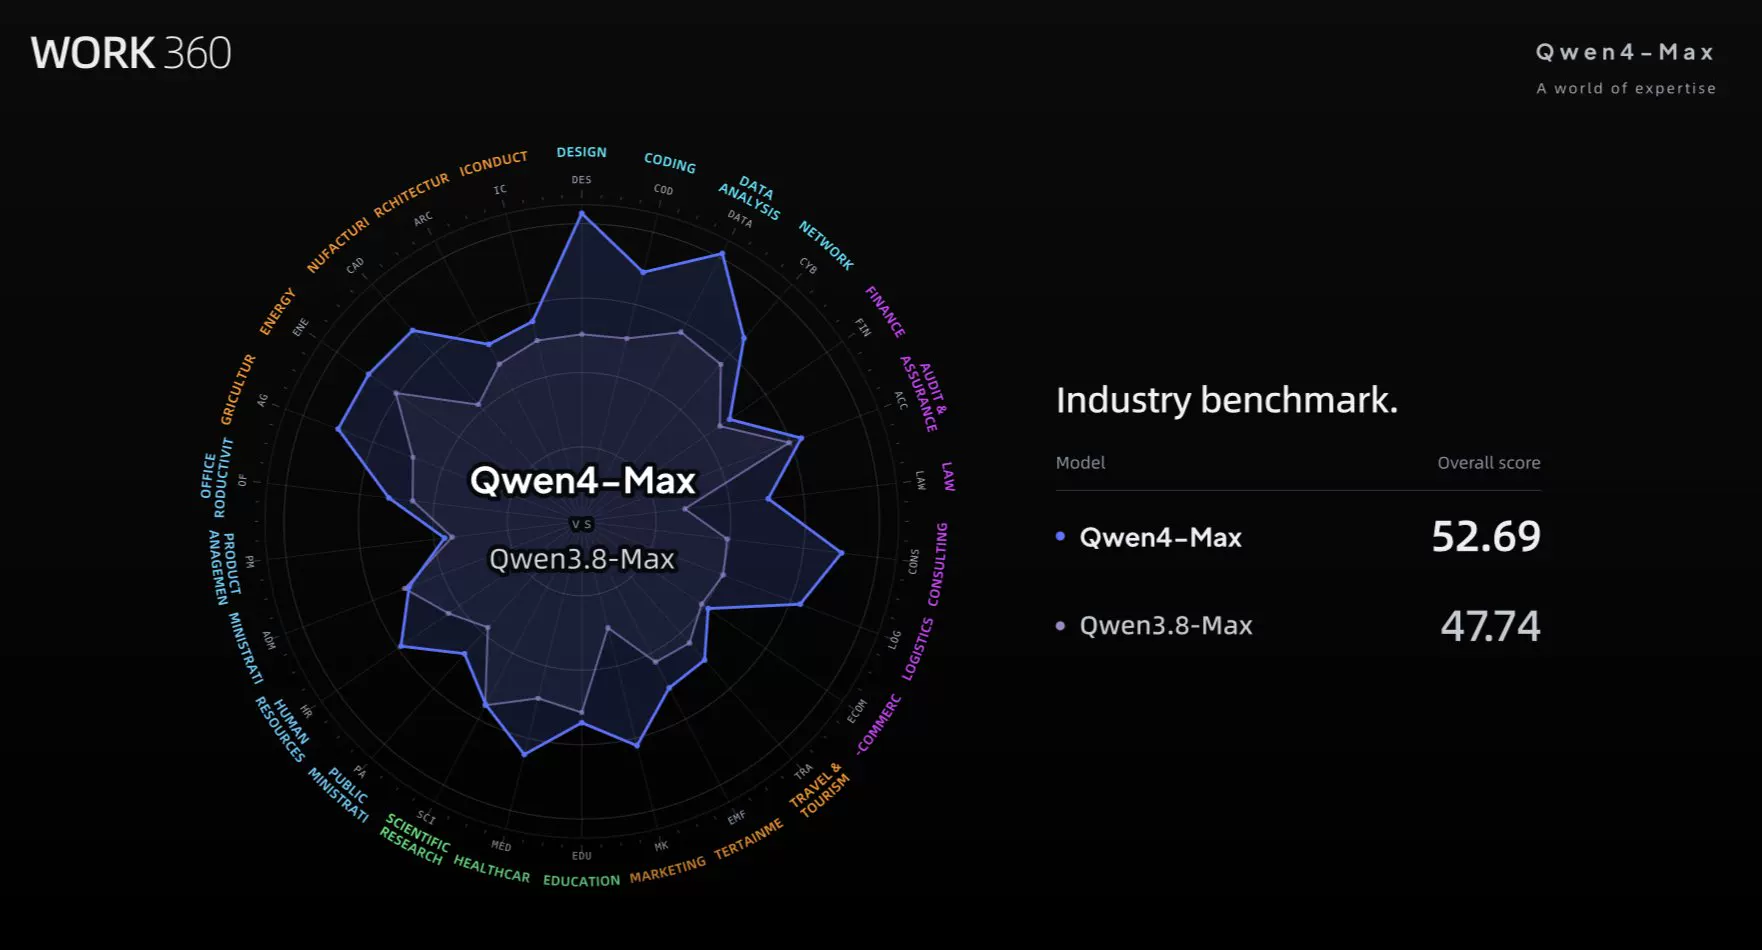
阿里云在发布公告的 Work360 段落称,该厂商自有测试涵盖 721 个专业领域,Qwen4-Max 与 Qwen3.8-Max 对照,在 High 推理描述下使用的 token 少 35%、平均每任务成本低约 60%。这是厂商在其任务集上的声明,不是我们对这两款的复测,更不是“你迁移后账单必降六成”。公告没有说清对照端是否采用同一推理档,也没交代平均成本计算纳入多少缓存命中。不同任务的输出长度、重试和质量门槛都可能不同;把这组百分比直接乘在自己的账单上,没有证据。
下面这张官方图只展示 WORK360 的任务得分:Qwen4-Max 为 52.69,Qwen3.8-Max 为 47.74。它不包含 token 消耗或费用测量,不能当作前述降本百分比的图证。
真要迁移,怎样在改动最小的前提下核验?
先把目标说清:如果仍然只是个人在兼容工具中交互试用,正式 ID 同样列于 Token Plan 支持清单;无需为了“正式”二字就把每个用户都迁到普通 API。若是自定义应用后端,订阅条款不覆盖这个用途,便需要单独确认普通 API 账号、地区、Key、权限与结算。这不是一份“只需改五行配置便已能上线”的保证,而是防止把已有验证边界悄悄延伸到未验证环境的检查顺序。
- 冻结旧状态:记录目前实际使用的是
qwen4-max-preview还是其他回退型号,属于哪个账户区域、哪种协议、哪个 Key 类型。不要在源代码或公开截图里留下密钥;如果只是 Token Plan 交互试用,遵守原来的用途限制。 - 选新入口与 ID:在对应地区选 Token Plan 或普通 API 的 Key 和主机,再填
qwen4-max;OpenAI 兼容客户端用其协议基础路径,Anthropic Messages 客户端用另一条。不能用“接口支持三种协议”替代真实客户端的请求与响应检查。 - 核参数再核输出:确认客户端在所用协议上把
medium映射为high,以及无显式参数时默认由xhigh变为high;若希望其他档位,应按对应协议写明值。不要在未固定实际档位的情况下比较新旧 token 数;用真实任务检查是否被共享生成预算截断,也检查非思考模式是不是你的预期。 - 核用量再核账单:同一组可重复任务分别记录未命中输入、缓存命中输入、输出(含思考)、是否发生显式缓存写入,以及 Token Plan 的 Credits 或普通 API 账单归属。不要把缓存“可能命中”当作 usage 的“已经命中”。
- 最后才决定切换与回退:应用负载用可回退的小流量验证请求、结果和收费后再评估生产切换;假如新路不满足要求,应回到已经验过且生命周期清楚的生产路径,而不是在 11 月 25 日后依赖会退役的预览 ID。
这些步骤适合留成一份由执行人填写的迁移记录:旧入口、目标入口、所用协议、所设 effort、最大生成预算、同一批任务的命中和未命中 token、首次请求与后续请求的费用,以及失败时切回哪条已验证路径。尤其别只拿单轮“你好”做通路验证:它看不出长前缀缓存、工具回合或思考预算在真实工作中的边界。用少量经许可且能人工核对的代表性任务,比把线上用户请求直接投向新模型更适合发现计费和截断问题;这一建议是测试设计,不是阿里云给出的上线验收承诺。
以上是核验顺序,不是本站完成这些步骤的纪要。尤其我们没有持真实 Key 调用两版型号,没有覆盖各地区、各协议的全部参数,也没有拿到厂商内部 checkpoint 信息。“文档给出正式版价格”与“某个团队已经具备可用资格并完成迁移”之间,还有实际请求、usage 与账单这三道需要他们自己过的门。
最后该等什么证据,才值得扩大使用?
至少要看到三件来自自己环境的东西:选定地区与凭证的正式请求成功、选定任务在明确 effort 和生成预算下的可接受结果、账单里的缓存与输出分栏和预期相符。应用团队还要复核协议字段、额度、失败回退及订阅条款是否与用途匹配。若其中任何一项未知,就把上线决策留在试点阶段;不靠厂商测试图或推理出的“预览=正式同一模型”填空。
独立报道指出这次旗舰权重没有开放,并明确没有独立验证阿里云的基准数字;公告只提到未来将开放较小型号的 Qwen4 权重。想本地部署旗舰的读者,不能把 API 已开放写成权重已发布。对已经从预览走来的开发者,真正的新消息也不是“模型变强了多少”——那还缺自己的任务证据——而是你现在有正式 ID 与公开价格,可以把入口、参数和账单重新对齐。先让这五项对齐,再考虑迁移流量。