
gpt-image-2.5 Flare / Sunburst 实测:同一个 quality: "high",token 从 5,488 掉到 1,372,价格只剩四分之一
把同一份 brief 喂给 gpt-image-2、2.5 Flare 和 2.5 Sunburst,九格直连实测。同一个 quality: "high",2.5 烧 1,372 输出 token,正是 gpt-image-2 在 medium 上烧的数;2.5 的 max 烧 5,488,正是老 high 的数。质量阶梯被重新贴了标:照搬 high 迁过去省 75%,但拿到的是老 medium 的预算;要老画质得改 max,价格分毫不动。附九张出图样本、墙钟与成本算式,以及一个把我带进沟里的网关。
先回答标题。值得切,但别原样照搬你的 quality 值。 同一个 quality: "high",
gpt-image-2.5 花 1,372 个输出 token,gpt-image-2 花 5,488 个——2.5 的 high 拿的是
上一代 medium 的预算,一张 1536×1024 的图从 $0.165 掉到 $0.042。要老 high 那个
画质,得改用 2.5 新增的 max,5,488 个 token 一个不少,价格分毫不动。
质量阶梯被重新贴了标。 这不是降价,是同一把尺子换了刻度名。下面是我把同一份 brief 喂给三个模型、九格跑下来的读数与出图,以及一个我踩进去半个下午的坑。
先看图:同一份 brief,两代模型四个档位
我不太信没有出图样本的参数表,所以先摆图。第一份 brief 要的是手绘插画:三根标着
A、B、C 的铜管汇进一个铜龙头,滴进一只杯子,墙上挂一块写着 ROUTER 的木牌,
画面里唯一的黄色物件是那只杯子。文字要精确,物件数量要精确,颜色约束要守住——
这三件事恰好是图像模型最容易翻车的地方。
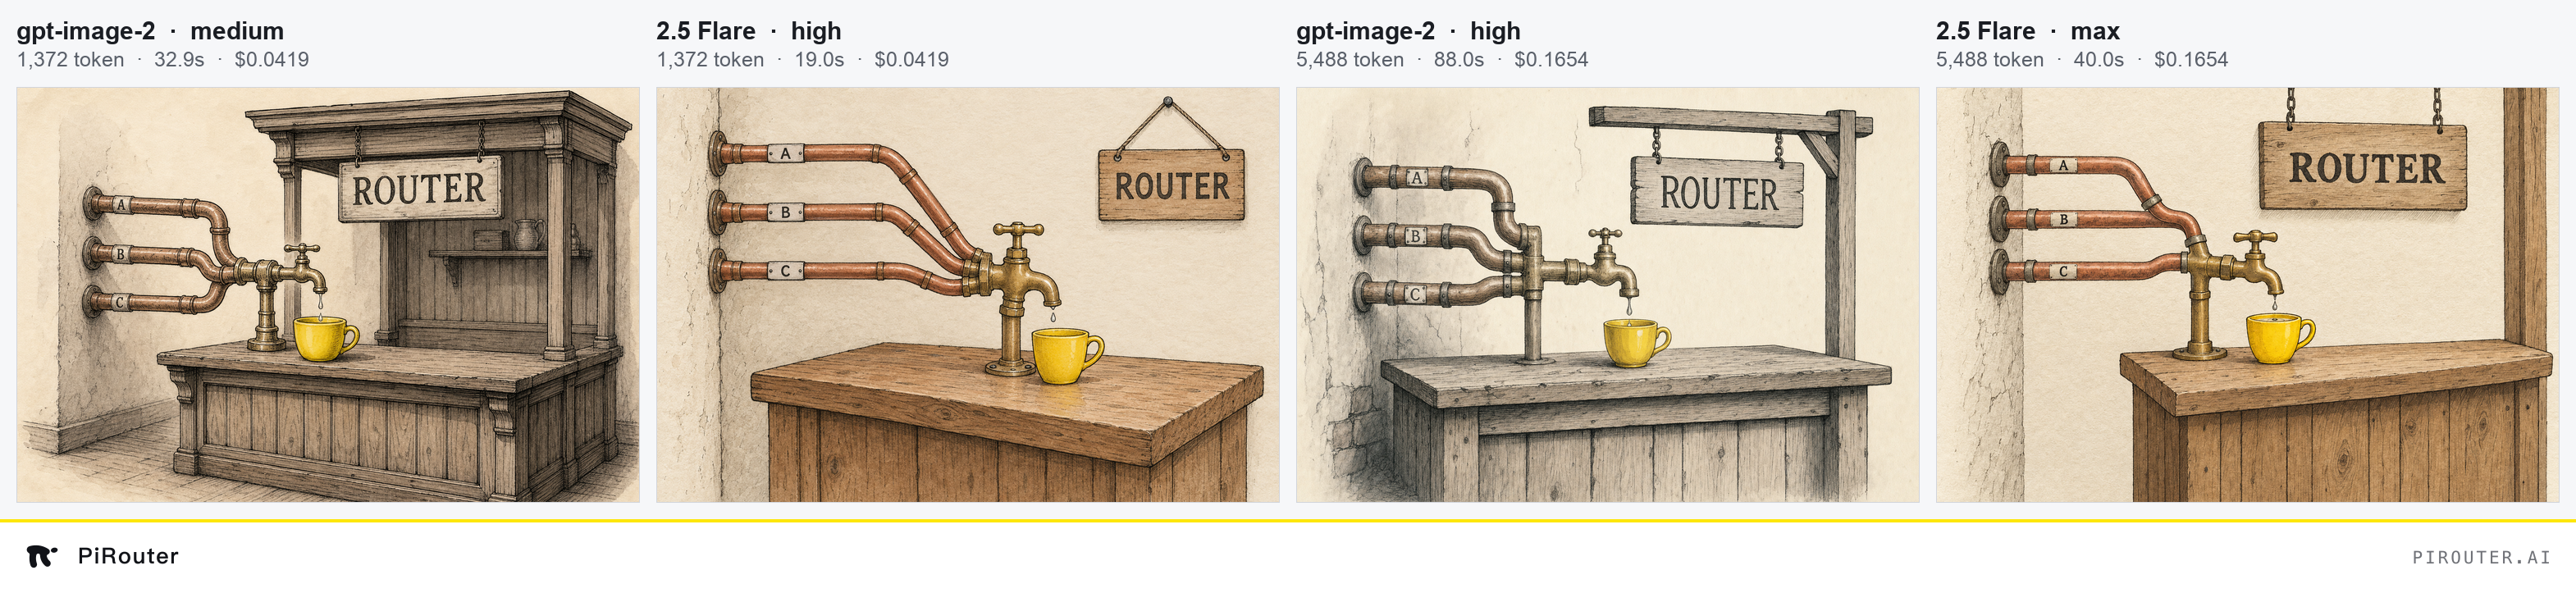
按 token 预算横着看,两代模型在同一预算上的画面是可比的;按 quality 标签竖着看,
就全错位了。这张图里左边两格花的是同样多的 token,右边两格也是——但左边一格叫
medium,另一格叫 high。
九张图逐张目视,我核了三件事:招牌上的 ROUTER 是否逐字符正确、三根管与
A/B/C 标签是否齐全、「唯一一个黄色物件」这条约束守没守住。
| 格 | 模型与档位 | 文字准确度 | 物件与约束 | 观感 |
|---|---|---|---|---|
| p1-gi2-medium | gpt-image-2 · medium | ROUTER、A/B/C 全对 | 三管一龙头一杯,唯一黄色 | 构图偏远,摊位占掉一半画面,主体偏小 |
| p1-gi2-high | gpt-image-2 · high | 全对,衬线字形最工整 | 守住 | 细节最密,木纹与砖墙刻画扎实 |
| p1-gi25-flare-high | 2.5 Flare · high | 全对 | 守住 | 主体放大、光线干净,同预算下明显比老 medium 好看 |
| p1-gi25-flare-xhigh | 2.5 Flare · xhigh | 全对 | 守住 | 木质与铜管质感更实,构图稳 |
| p1-gi25-flare-max | 2.5 Flare · max | 全对 | 守住 | 层次最好的一张,本文封面用的就是它 |
| p1-gi25-sunburst-high | 2.5 Sunburst · high | 全对 | 守住 | 与 Flare 同级,管路走线更清楚,牌子略小 |
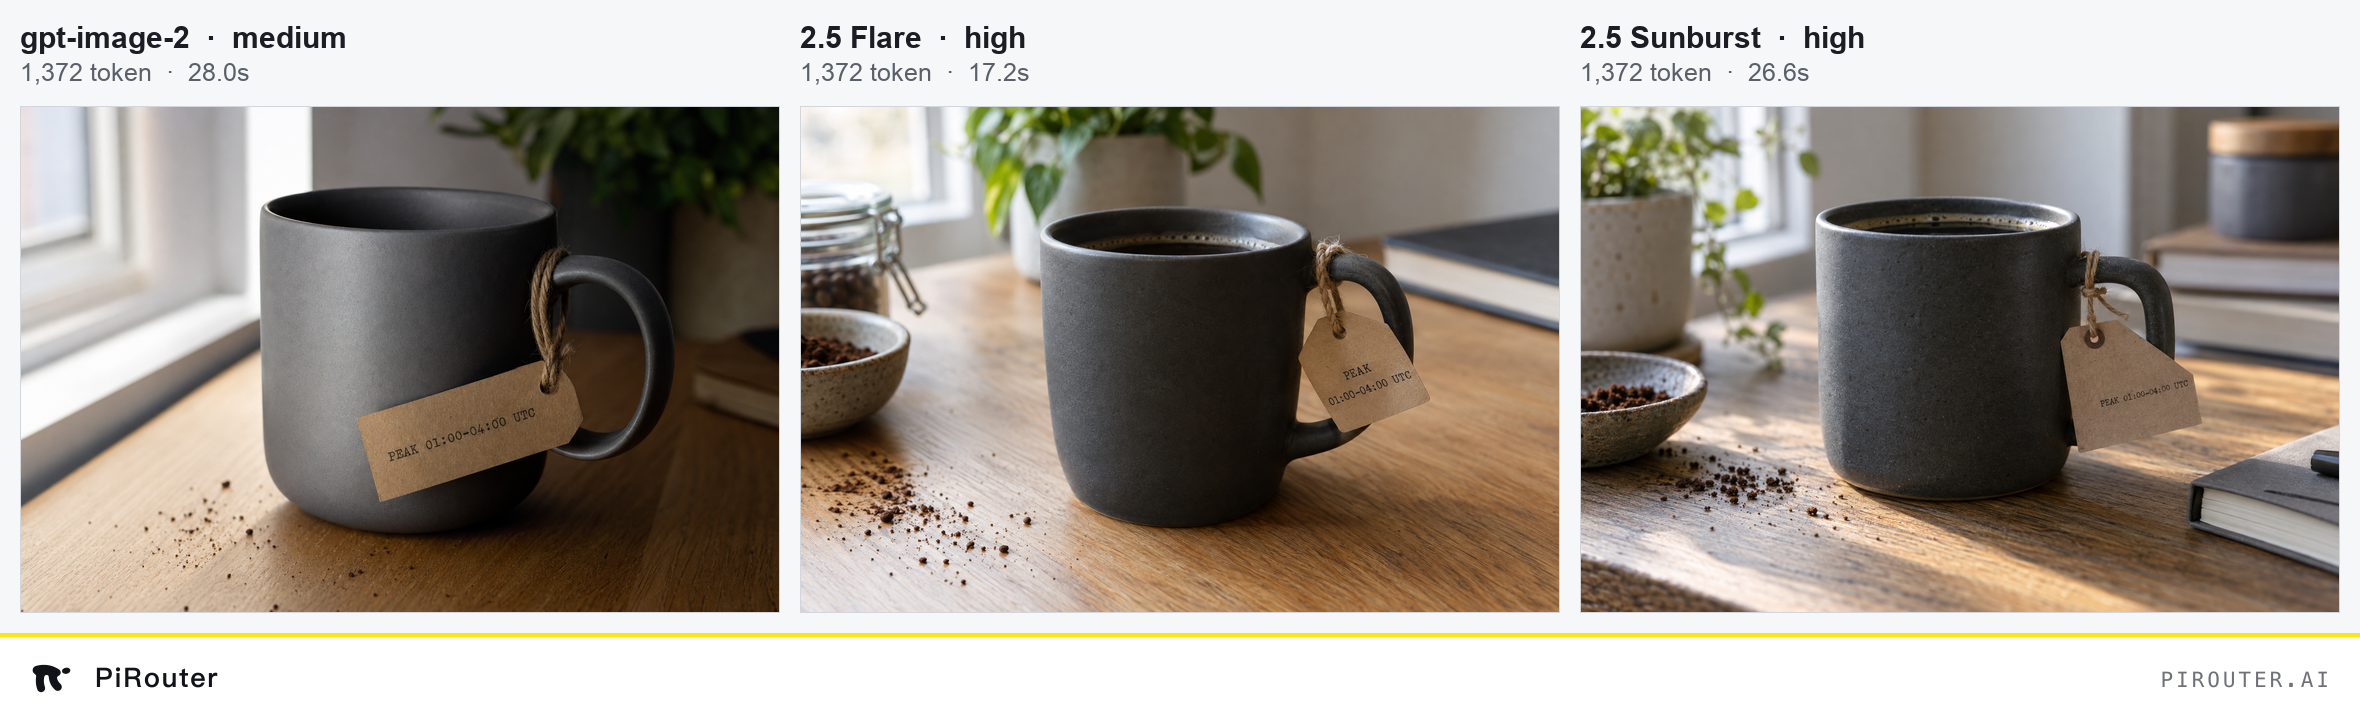
| p2-gi2-medium | gpt-image-2 · medium | 04:00 的第一个 0 带了个多余的顶点 | 杯、吊牌、咖啡渣齐全 | 景深干净,标签正对镜头最好读 |
| p2-gi25-flare-high | 2.5 Flare · high | 逐字符正确,换行成两行 | 齐全 | 环境物件更丰富,杯中有咖啡 |
| p2-gi25-sunburst-high | 2.5 Sunburst · high | 逐字符正确,单行排版 | 齐全 | 晨光与投影最自然,标签字号偏小 |
九格里八格文字全对,唯一的瑕疵出在 gpt-image-2 身上——第二份 brief 要求吊牌上精确写
PEAK 01:00-04:00 UTC,它把 04:00 的第一个 0 画出了一个多余的顶点,像给字母戴了顶帽子。
两个 2.5 模型在同一份 brief 上逐字符正确。「唯一一个黄色物件」这条约束九格全守住了,
没有一张把管子或木牌也刷成黄的。
结论说白了:在同样的 token 预算上,2.5 画得更好。 这句话值钱的地方不在「更好」, 在「同样的预算」——而预算这件事,被标签名藏起来了。
同一个 quality: "high",两代模型的 token 差 4 倍
九格的完整读数。成本不是账单上抄来的,是按官方费率自己算的:
输出 token × $30/M + 输入 token × $5/M。以第一份 brief 的 150 个文本输入 token 算,
输入那部分是 $0.00075,四舍五入前后都不影响结论,但我把它算进去了。
| 格 | 模型 | quality 发送 / 回显 | 输出 token | 墙钟 | 成本 |
|---|---|---|---|---|---|
| p1-gi2-high | gpt-image-2 | high / high | 5,488 | 88.0s | $0.16539 |
| p1-gi2-medium | gpt-image-2 | medium / medium | 1,372 | 32.9s | $0.04191 |
| p1-gi25-flare-high | 2.5 Flare | high / high | 1,372 | 19.0s | $0.04191 |
| p1-gi25-flare-xhigh | 2.5 Flare | xhigh / xhigh | 2,459 | 31.0s | $0.07452 |
| p1-gi25-flare-max | 2.5 Flare | max / max | 5,488 | 40.0s | $0.16539 |
| p1-gi25-sunburst-high | 2.5 Sunburst | high / high | 1,372 | 32.3s | $0.04191 |
| p2-gi2-medium | gpt-image-2 | medium / medium | 1,372 | 28.0s | $0.041675 |
| p2-gi25-flare-high | 2.5 Flare | high / high | 1,372 | 17.2s | $0.041675 |
| p2-gi25-sunburst-high | 2.5 Sunburst | high / high | 1,372 | 26.6s | $0.041675 |
两个数字在表里反复出现:1,372 和 5,488。gpt-image-2 在 medium 上烧 1,372,
2.5 在 high 上也烧 1,372;gpt-image-2 在 high 上烧 5,488,2.5 在 max 上也烧 5,488。
一个不差。把标签对齐画成一张表:
| 2.5 的标签 | 输出 token(1536×1024) | 在 gpt-image-2 上的同预算档位 |
|---|---|---|
| high | 1,372 | medium |
| xhigh | 2,459 | 没有对应档位 |
| max | 5,488 | high |
xhigh 是 2.5 新增的中间档,上一代没有对得上的东西。这两个新档位是随 2.5 一起进
OpenAPI 规范的,社区在发布当天就从
openai-openapi 的提交记录
里翻出来了。
不信没样本的参数表,就把三档摆出来:
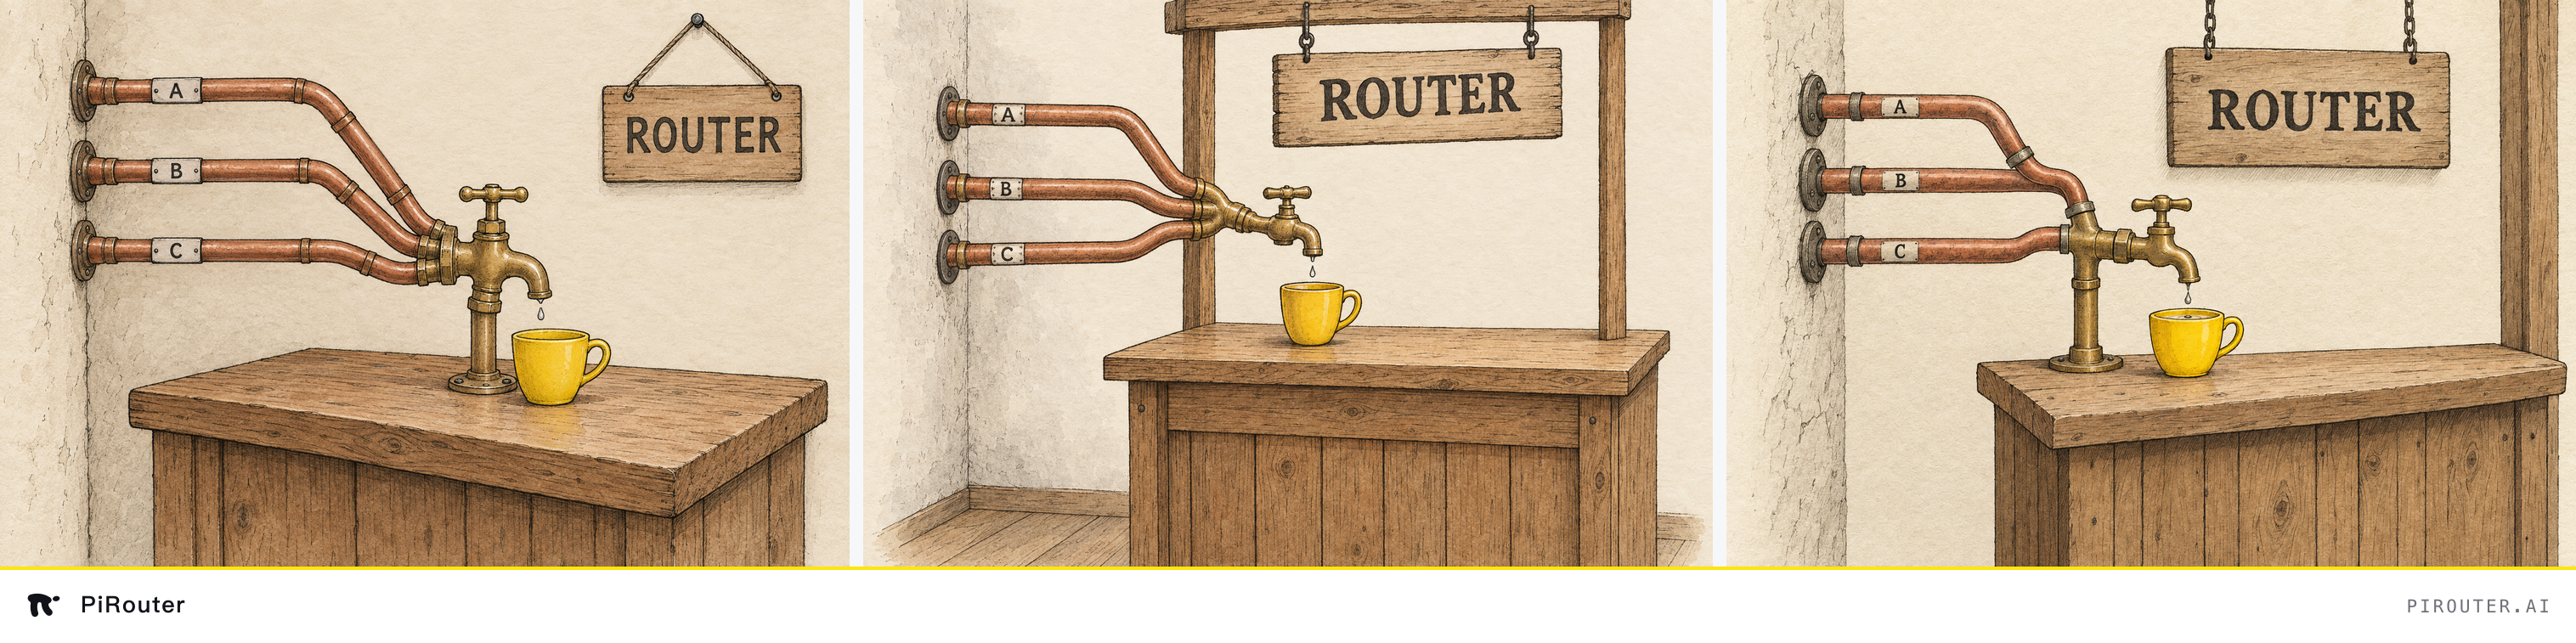
xhigh 的位置由此清楚:比 high 贵 78%,换来的是构图完整度而非锐度;再到 max 多花 122%,
增益落在细节密度。出封面或主视觉值得试 xhigh,批量配图仍是 high 划算。
费率这一层完全没动。两个 2.5 模型页都写着 Token rates match GPT Image 2—— 文本输入 $5/M、图像输入 $8/M、图像输出 $30/M, 三个模型页的费率一行不差。API 定价页 要多点一下:Standard 与 Batch 是两张默认折叠的分表,gpt-image-2 只出现在 Batch 那张里, 所以想并排核对得回到各自的模型页。 所以价格变化百分之百来自 token 数量,不来自单价。 这和我们之前写过的 同一份权重在不同渠道卖出不同价钱恰好相反:那次是单价在动、 东西没变,这次是单价没动、标签底下的东西换了。
值得单独说一句:官方模型页自己挂了个提醒, 「The GPT Image 2 calculator does not estimate GPT Image 2.5 token consumption」—— 别拿上一代的计算器估这一代的用量。这句话现在读起来像是给「重新贴标」提前打的补丁。
我们的读数不是孤证。apidog 的
三模型对比文
从 OpenAI 计算器抄下来的表里,2.5 在 1536×1024 上 high 是 1,372、xhigh 是 2,459、
max 是 5,488——与我们九格实测逐格一致,而我们是从 usage.output_tokens 里读的真实回包。
两条独立路径撞上同一组数字,这个结论可以放心用。
换算成动作,就是改一个字段的事:
{
  "model": "gpt-image-2.5-flare",
  "prompt": "...",
  "size": "1536x1024",
  "quality": "high"
}
把 model 从 gpt-image-2 换成 gpt-image-2.5-flare、quality 原样保留 high,
账单立刻降到约四分之一,画面拿到的是老 medium 的预算——按上一节的目视,
这个预算在 2.5 手里比在上一代手里好看。要老 high 的画质,把 quality 改成 max,
账单回到 $0.165。两条路都合理,前提是你知道自己在选哪条。
Flare 比 gpt-image-2 快 40%,Sunburst 慢一截,但三者一分钱不差
速度这栏我看了两遍才确认没抄错。同样是 1,372 个 token,第一份 brief 上 gpt-image-2 用 32.9 秒,Flare 用 19.0 秒;第二份 brief 上是 28.0 秒对 17.2 秒。 两次都快了四成左右。OpenAI 官方的措辞只到定性——开发者社区公告帖 写的是「Faster image generation」,Flare 带来「quality, editing, and speed improvements」, 没有给百分比;广为流传的「延迟降低 50%」我只在该帖的一条用户回复和几篇二手报道里见到, 发布公告原页对脚本返回 403,我没能亲自核到官方是否说过这个数。所以这里只报我们自己测到的 四成,不引那个 50%。
Sunburst 的位置最有意思。它和 Flare 的 token 数完全相同,两个模型页的费率表逐行一样, 所以同一张图它们花同样的钱。差别在时间:两份 brief 上 Sunburst 分别是 32.3 秒和 26.6 秒, 比 Flare 慢 55% 到 70%。官方把 Sunburst 定位成 编辑精度优先的那一个, Flare 是日常高吞吐的那一个。换句话说,Sunburst 的溢价是时间,不是价格。 你多等的那十几秒就是全部成本。
这里必须把边界说清楚,否则上面的数字会被读得太重:
- 每格只跑了一次(n=1)。 生成模型每次采样都不同,墙钟还受排队影响。
这是第一眼,不是基准测试。真要定选型,拿你自己的 prompt 跑一周,记
usage日志。 - 我们只测了生成,没测多轮编辑。 而多轮编辑恰恰是 Sunburst 的官方卖点—— 「跨多次编辑保持细节一致」。我们也没测参考图保持。所以本文对 Sunburst 的判断 只覆盖单次文生图这一面,它最该发光的地方我们没碰。
- 官方这次没给评测表。 发布公告里没有画质评分、没有胜率、没有和任何竞品的对比, 所有说法都是对着自家上一代讲的(这一点 datanorth 的报道也点了出来)。 连它公布的安全指标都没带统计显著性标记。
一个把我带进沟里的下午:网关没有透传 quality
这一节本来不在计划里。
第一轮实测我图省事,走了一个多厂商聚合网关——一个 key 打通所有模型,日常很方便。 跑完九格,我盯着结果差点当场发文:2.5 看起来比 gpt-image-2 省了 6 到 13 倍的 token, Flare 的某一格只花了 429 个 token。这数字太漂亮了,漂亮到不像真的。
于是我去翻回包的原始字段,发现两处对不上:
| 检查项 | 我发出去的 | 网关回显的 |
|---|---|---|
| quality(Flare 那格) | high | medium |
| quality(第二份 brief 的 Flare) | high | low |
| size | 1536x1024 | 1312x1199、1370x1148、1402x1122 等近方形 |
上游根本没收到我要的 quality,尺寸也被改掉了。 我发 high,它按 medium 甚至
low 出图;我要 1536×1024 的横图,拿回来一堆接近正方形的尺寸。token 当然少——
少的是画质,不是模型效率。那个「省 6–13 倍」的惊人发现,是网关降档的产物,
和两代模型的差异一点关系都没有。
改成直连官方接口重跑,九格的 quality 与 size 全部正确回显(本文所有数字都来自这一轮)。
两轮的原始回包我都留着,差异就在那几个字段上。
教训写下来给以后的自己看:做模型对比,要么直连,要么先验证回显字段。 参数发出去不等于参数生效了,中间任何一跳都可能悄悄改写它,而回包里往往有线索—— 前提是你去读。这件事没有报错、没有告警,唯一的症状就是数字好得不真实。
这恰好是我们自己这条业务线每天在琢磨的事。网关坐在调用方和模型之间,它多做一点
翻译就少一点保真;我们把参数保真当成设计目标之一——请求里的 quality、size
这类语义参数原样过桥,回包里的 usage 原样返还,
路由层的取舍可以在别处做,但不该做在用户明确写下的字段上。
这是我们的设计取向,不是对任何已上线能力的承诺,具体做到哪一步以产品页为准。
顺带一句工具面的观察:我们内部那个出图工具的 --quality 参数只认 low、medium、high、auto
四个值,2.5 新增的 xhigh 和 max 直接被它在预检阶段挡了回来(invalid choice: 'max')。
这两格是绕过工具、用 curl 手打的。模型加档位的速度,总比工具链跟上的速度快一拍。
那到底切不切:三种负载,三个答案
日常出图、要快要省的:切 Flare,quality 保持 high。 这是收益最干脆的一档——
账单降到约四分之一,速度快四成,画面按我们九格的目视不降反升。真在意画质的那几张,
单独调成 max 或新的 xhigh。
批量夜跑的:先别切。 这是最容易踩的一脚。gpt-image-2
支持 Batch API,
定价页的 Batch 分表里它的图像输出是 $15/M,正好是标准价的一半;
而两个 2.5 模型的端点表里 Batch 那一行明写 Not supported,它们在 Batch 分表里
整行缺席。所以如果你的活儿能接受 Batch 的延迟,用 gpt-image-2 的 Batch medium
跑 1,372 个 token,比用 2.5 标准价的 high 跑同样 1,372 个 token 还要便宜一半。
对批量负载来说,迁到 2.5 是涨价不是降价。
算成钱更直观。同样 1,372 个输出 token,Batch 的 $15/M 对标准价的 $30/M:
| 月出图量 | gpt-image-2 · Batch medium | 2.5 Flare · 标准 high | 差额 |
|---|---|---|---|
| 1 万张 | $205.8 | $411.6 | 多花 $205.8 |
| 10 万张 | $2,058 | $4,116 | 多花 $2,058 |
(只算图像输出,按 1,372 × 单价 ÷ 1e6 × 张数;文本输入每张 150 token 两边一样,略去。) 代价是 Batch 的异步窗口——OpenAI 对 Batch 承诺的是 24 小时内完成,不是秒回, 所以这条只对「今晚提交、明早要」的活儿成立。要即时出图,这张表跟你无关; 要夜里批跑,这就是切与不切之间每月两千美元的差别。
做多轮编辑的:Sunburst 值得试,但别指望这篇给你答案。 我们没测编辑链路, 而那是它唯一比 Flare 强的地方。它比 Flare 慢 55–70%、价格完全相同—— 如果多轮编辑后主体真的更稳,这个时间花得值;如果在你的 prompt 上看不出差别, 那就是白等。这个只能你自己拿真实工作流跑。
最后两个具体动作,比任何结论都实在:
- 把
quality从代码里挪进配置。 这次迁移要动的就是这一个值,散在几十个调用点上 会很难受。挪出来之后,high和max之间来回切只是改一行配置。 - 把
usage.output_tokens记进日志,跑满一周真实 prompt。 计算器和我们这九格都是 估算与样本,你的账单只认回包里那个数。真金白银的那条曲线,一周就能看清楚。
我最喜欢这次实测的一点是:最贵的那张图和最便宜的那张图,中间隔的不是画质,是一个标签。 把标签底下的数字翻出来看一眼,是这次唯一需要做的功课。