
Decision 3.0 开放六款模型:让图片和视频也能回答结构化决策题
Decision 3.0 发布 0.6B 至 27B 六款开放决策模型,输入可包含图像、视频,返回预定义答案的概率。借官方收据和视频示例看用途、尺寸取舍,以及榜单版本和单卡延迟的边界。
一位顾客说搅拌机到货时已经破裂,顺手附上收据,系统需要先判断由谁处理、凭证里有什么。Decision 3.0开放了约 0.6B 至 27B 的六款决策模型,让文字、图片和视频进入「在预定义答案中作选择、返回概率」的工作流,而不是生成一段聊天回复。这个变化提供了新的任务分工,但不等于已经在你的单据和机器上做得又准又便宜;下文引用发布方资料和公开榜单,我们没有运行这些模型。
封面采用系列最大型号 d3 27B 的官方宣发图,并非六款型号的合照。模型卡里的收据示例把三道题放进一次请求:交给退换货还是账单团队,收据里有没有这件商品,付款方式是什么。
一张收据,要问的其实是三种不同的问题
在官方示例代码里,输入由 state、可选图片和 questions 组成。第一题是 choice:客服应由退换货、账单还是技术支持处理?第二题是 noul(是/否题),判断收据上是否有搅拌机;第三题也是 choice,在银行卡、现金和礼品卡里判断付款方式。没有附图时,客服描述足以引导分流,却不能可靠地回答收据内容;图片在这里不是给聊天回答增添装饰,而是某一道决策所需的证据。
输出形式也不同。它不是先写一段「根据我的分析」,再让业务系统用正则提取一个类别。调用方先定义答案空间,模型再返回每个选项的概率,后续系统可根据任务设置人工复核或二次检查。概率分布是模型输出,不自动等于业务正确率;如果票据模糊、选项里没有真实答案,照样可能选错。要允许「都不符合」,就先把这个选项设计进题目,而不是指望模型自己跳出有限选项。关于这类判断放在整个路由系统的什么位置,我们此前另有四层路由对照;这篇更关心图像、视频加入后,证据从哪里来。
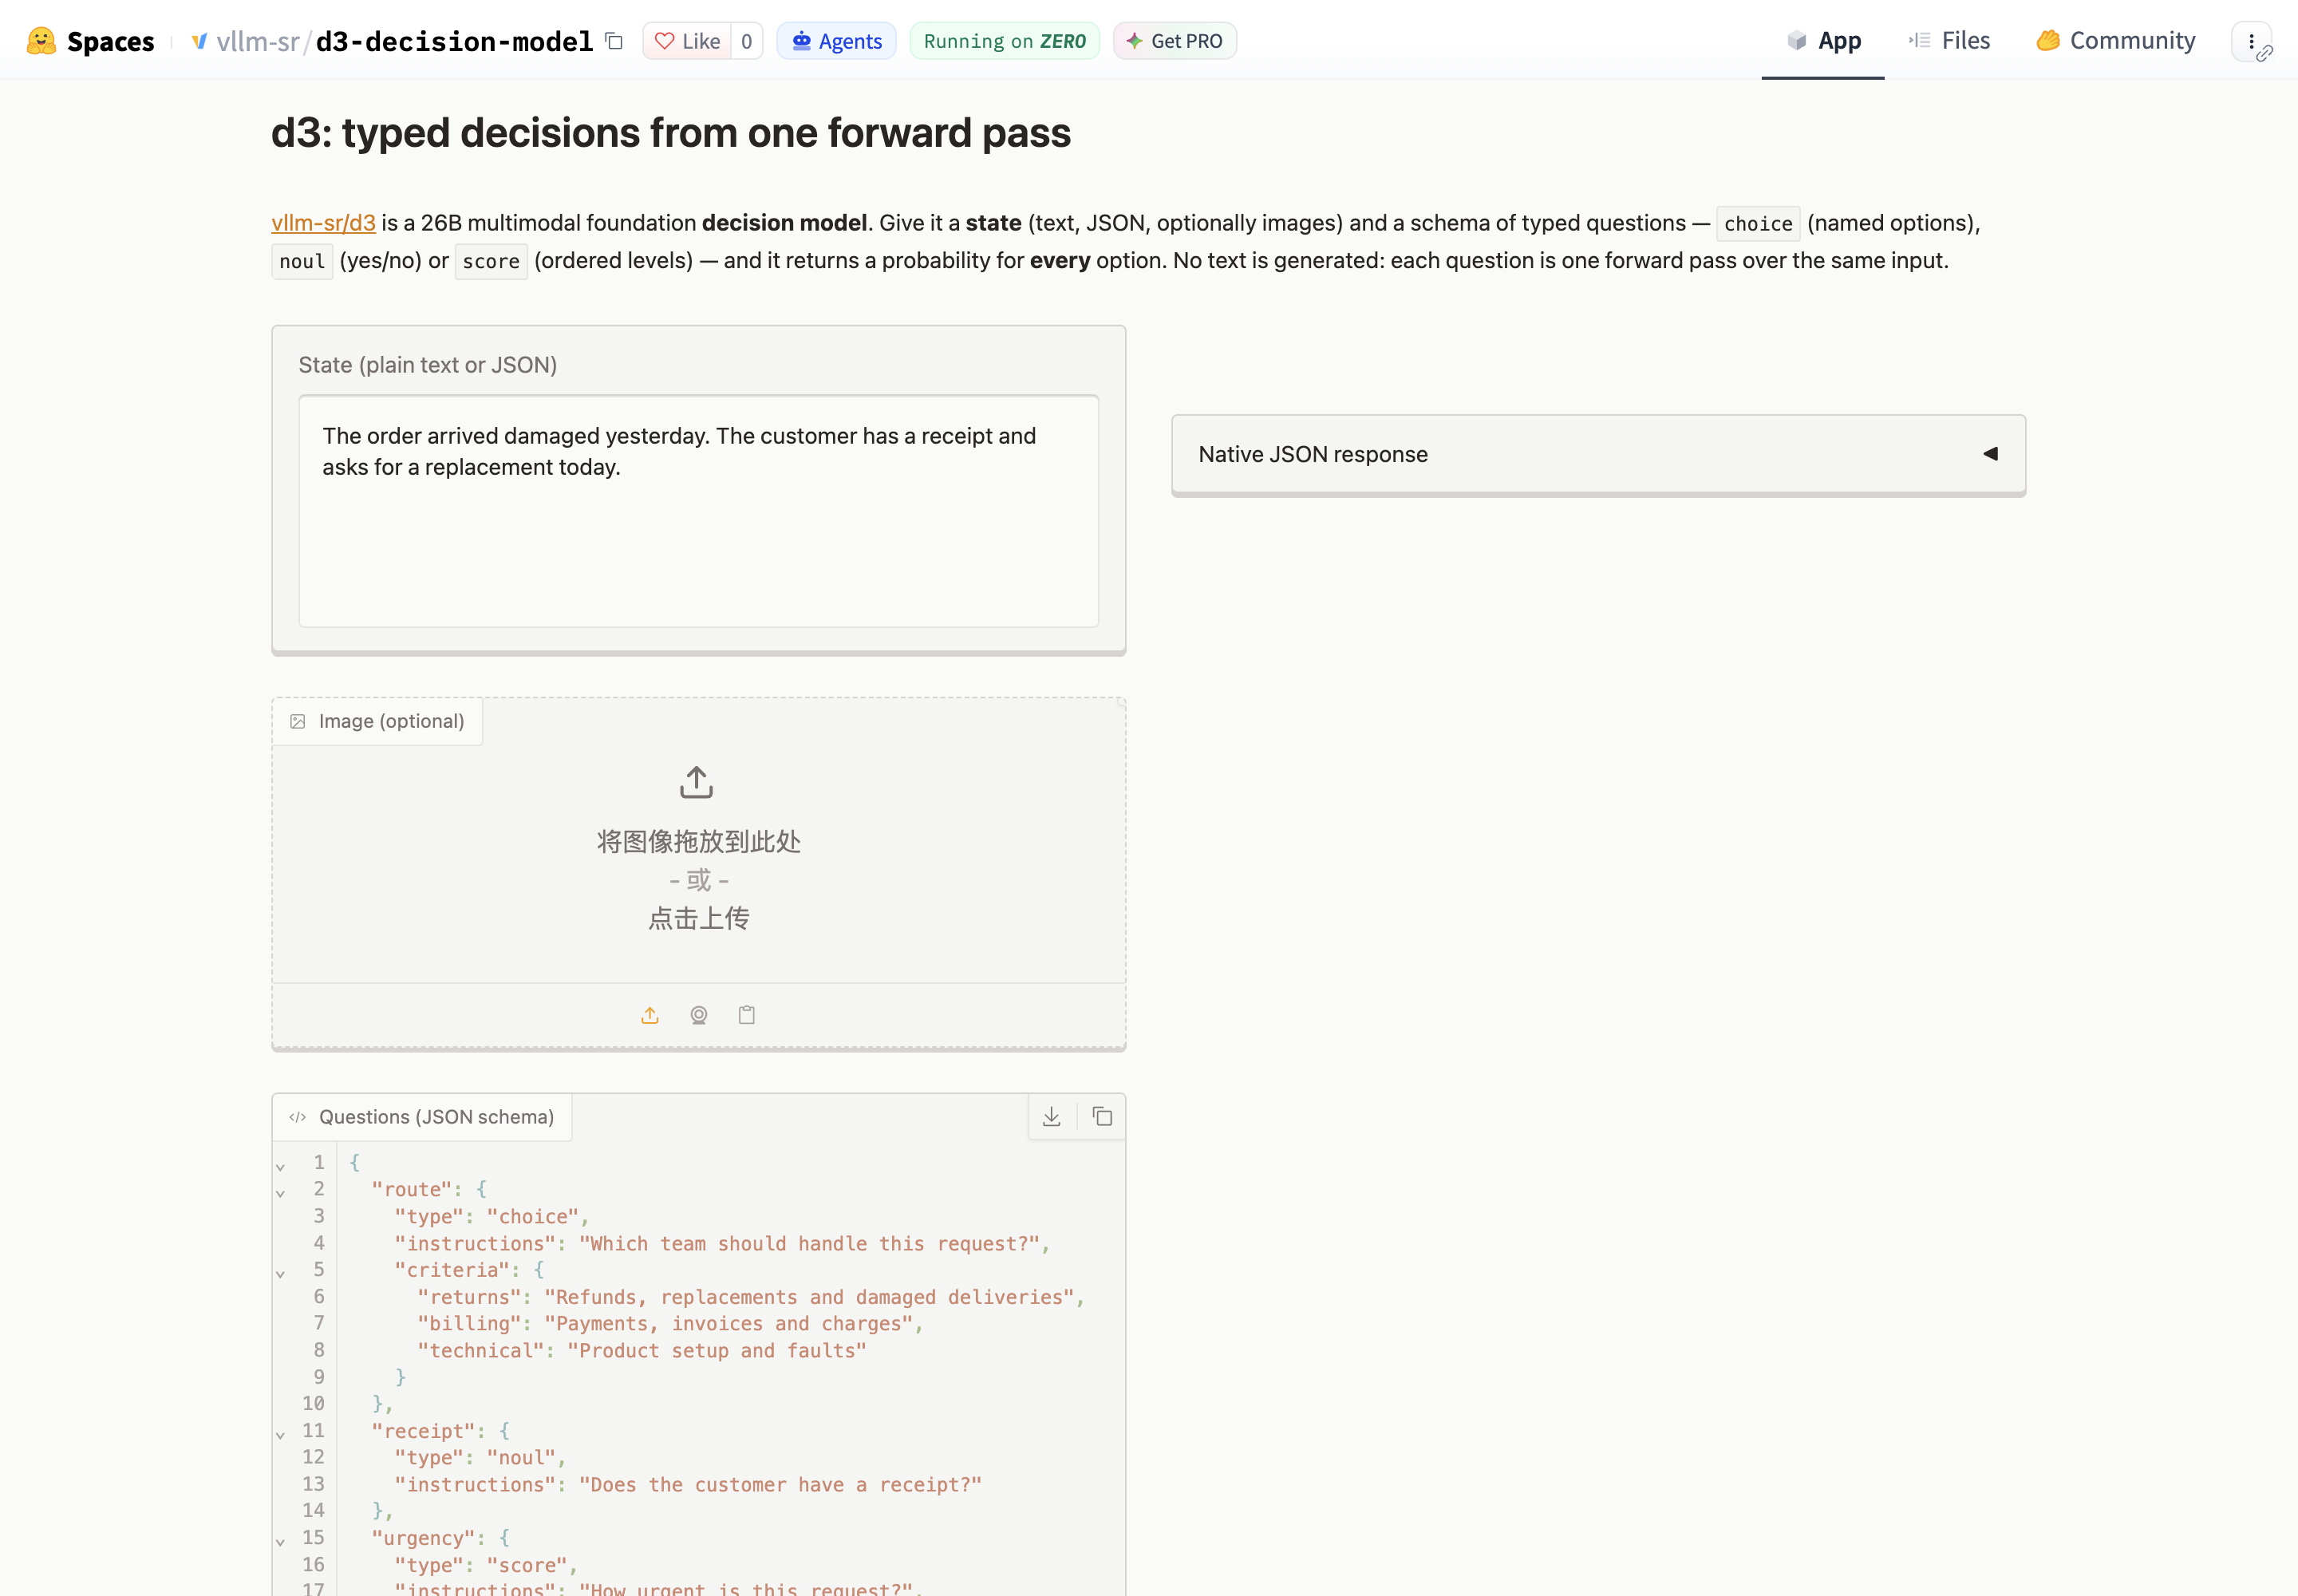
模型卡说,同一请求可以一次送入多道题,每道题都看到共同的文本与媒体。不过一次请求不等于多道题只做一次前向计算:官方写明每题各有一次针对共享输入的前向计算。这个区分会影响你对多问题延迟的预期,不能把「一通 API」直接写成「几道题都免费」。官方公开演示页用的是另一组预填问题:分给哪个团队、顾客是否有收据、请求有多紧急,分别展示选择、是非和评分题。它不是上文模型卡的商品识别与付款方式示例。下图仅是页面截图,未提交请求,没有展示模型实际预测结果。
视频也能提问,但先看它究竟看见了哪些帧
官方还提供了一段小方块移动的视频例子:给定短片,问方块朝左还是朝右、有没有变色。场景很窄,却恰好说明这种模型的工作边界。如果任务只需「是否出现指定动作」或「下一步交给哪条流程」,预先定义问题可能比要求模型复述整段视频更直接;如果任务要解释事故原因、寻找画面外的背景,有限答案就装不下这个要求。后者仍需其他分析路径,不能从「支持视频」推导出通用视频理解无误。
媒体读入有明确取样限制。按d3 模型卡,每张图像最多按约 1.6 百万像素处理;视频默认每秒取 2 帧,整段最多 32 帧,每帧最多约 0.2 百万像素。这不是视频文件可上传大小的等价说法,而是进入模型观察的抽样窗口。若判断依赖一闪而过的标签、小字或发生在两次采样之间的动作,原视频确有证据,模型输入却可能没看到它。先挑短片、定义清晰的可观察事件,保留原片给复核;不要让一个「否」字取代事故调查。
图像也是如此。收据上的商品名如果模糊或被裁到边外,表面整洁的概率仍可能掩盖读图错误。适合做首轮试验的不是未经筛选的一百万张历史票据,而是一小批有清晰人工答案、刻意包含破损图、混合图文和「无正确选项」的样本。这样可以分别发现模型读错了什么,以及业务题目自己有没有定义错。
六种尺寸,先分工作负载,再核机器预算
官方集合把 d3、d3-flash、d3-mini、d3-nano、d3-lite、d3-edge 放在同一族;逐一模型卡均标注 Apache-2.0,提供文字、图片、视频输入与选择/是非/评分的概率输出。名字里的 B 是参数规模的约数,不是模型文件大小或显存保证值。底座也分两路:最大款建立在 Qwen3.8-27B 上,其余基于 Qwen3.5 系列;六款都包含视觉编码器。
| 型号 | 官方卡片中的总参数与底座 | 更适合先验证的问题,而非已证实的适用范围 |
|---|---|---|
| d3 | 26.09B;Qwen3.8-27B | 质量优先、已有较大推理资源时,作为能力基准 |
| d3-flash | 8.39B;Qwen3.5-9B 系 | 希望缩小部署规模,又不想立刻落到最小模型 |
| d3-mini | 4.54B;Qwen3.5-4B 系 | 有大量重复的票据或图像分类,先测质量/延迟拐点 |
| d3-nano | 2.21B;Qwen3.5-2B 系 | 场景更窄、资源预算更紧,能接受逐项验错 |
| d3-lite | 0.85B;Qwen3.5-0.8B 系 | 可明确界定选项的轻量任务,关注部署占用 |
| d3-edge | 0.59B;Qwen3.5-0.8B 系 | 硬件约束最严,先验证最低可接受正确率 |
表格最后一列是试验起点,不是厂商针对行业场景的测评结论。最小型号不一定是每次都最便宜的业务方案:更高的误分率会增加人工复核和重试;反过来,也不应只因为大型号在综合榜得分高就给每一张简单票据调 27B。要观察的是你自己的错题、需要人审的比例、机器空闲时间和排队延迟,而不是只看参数数量。官方卡列出六款型号的单卡延迟,但没有给出我们这类负载的生产吞吐与总成本。
「榜首」是一个带日期的快照,不是所有任务的通行证
发布方d3 模型卡放了一张尺寸与分数图:d3 在 Decision Index 0.3.1 的文本 Full 分数 64.7,视觉榜 71.6。图脚和卡片脚注写得很清楚:d3 是团队内部评测;其他模型来自当时的公开榜单快照,文本对照取于 10 月 10 日、视觉取于 10 月 9 日。它仍是值得追踪的发布方证据,但不能给它换上「独立认证」的署名。
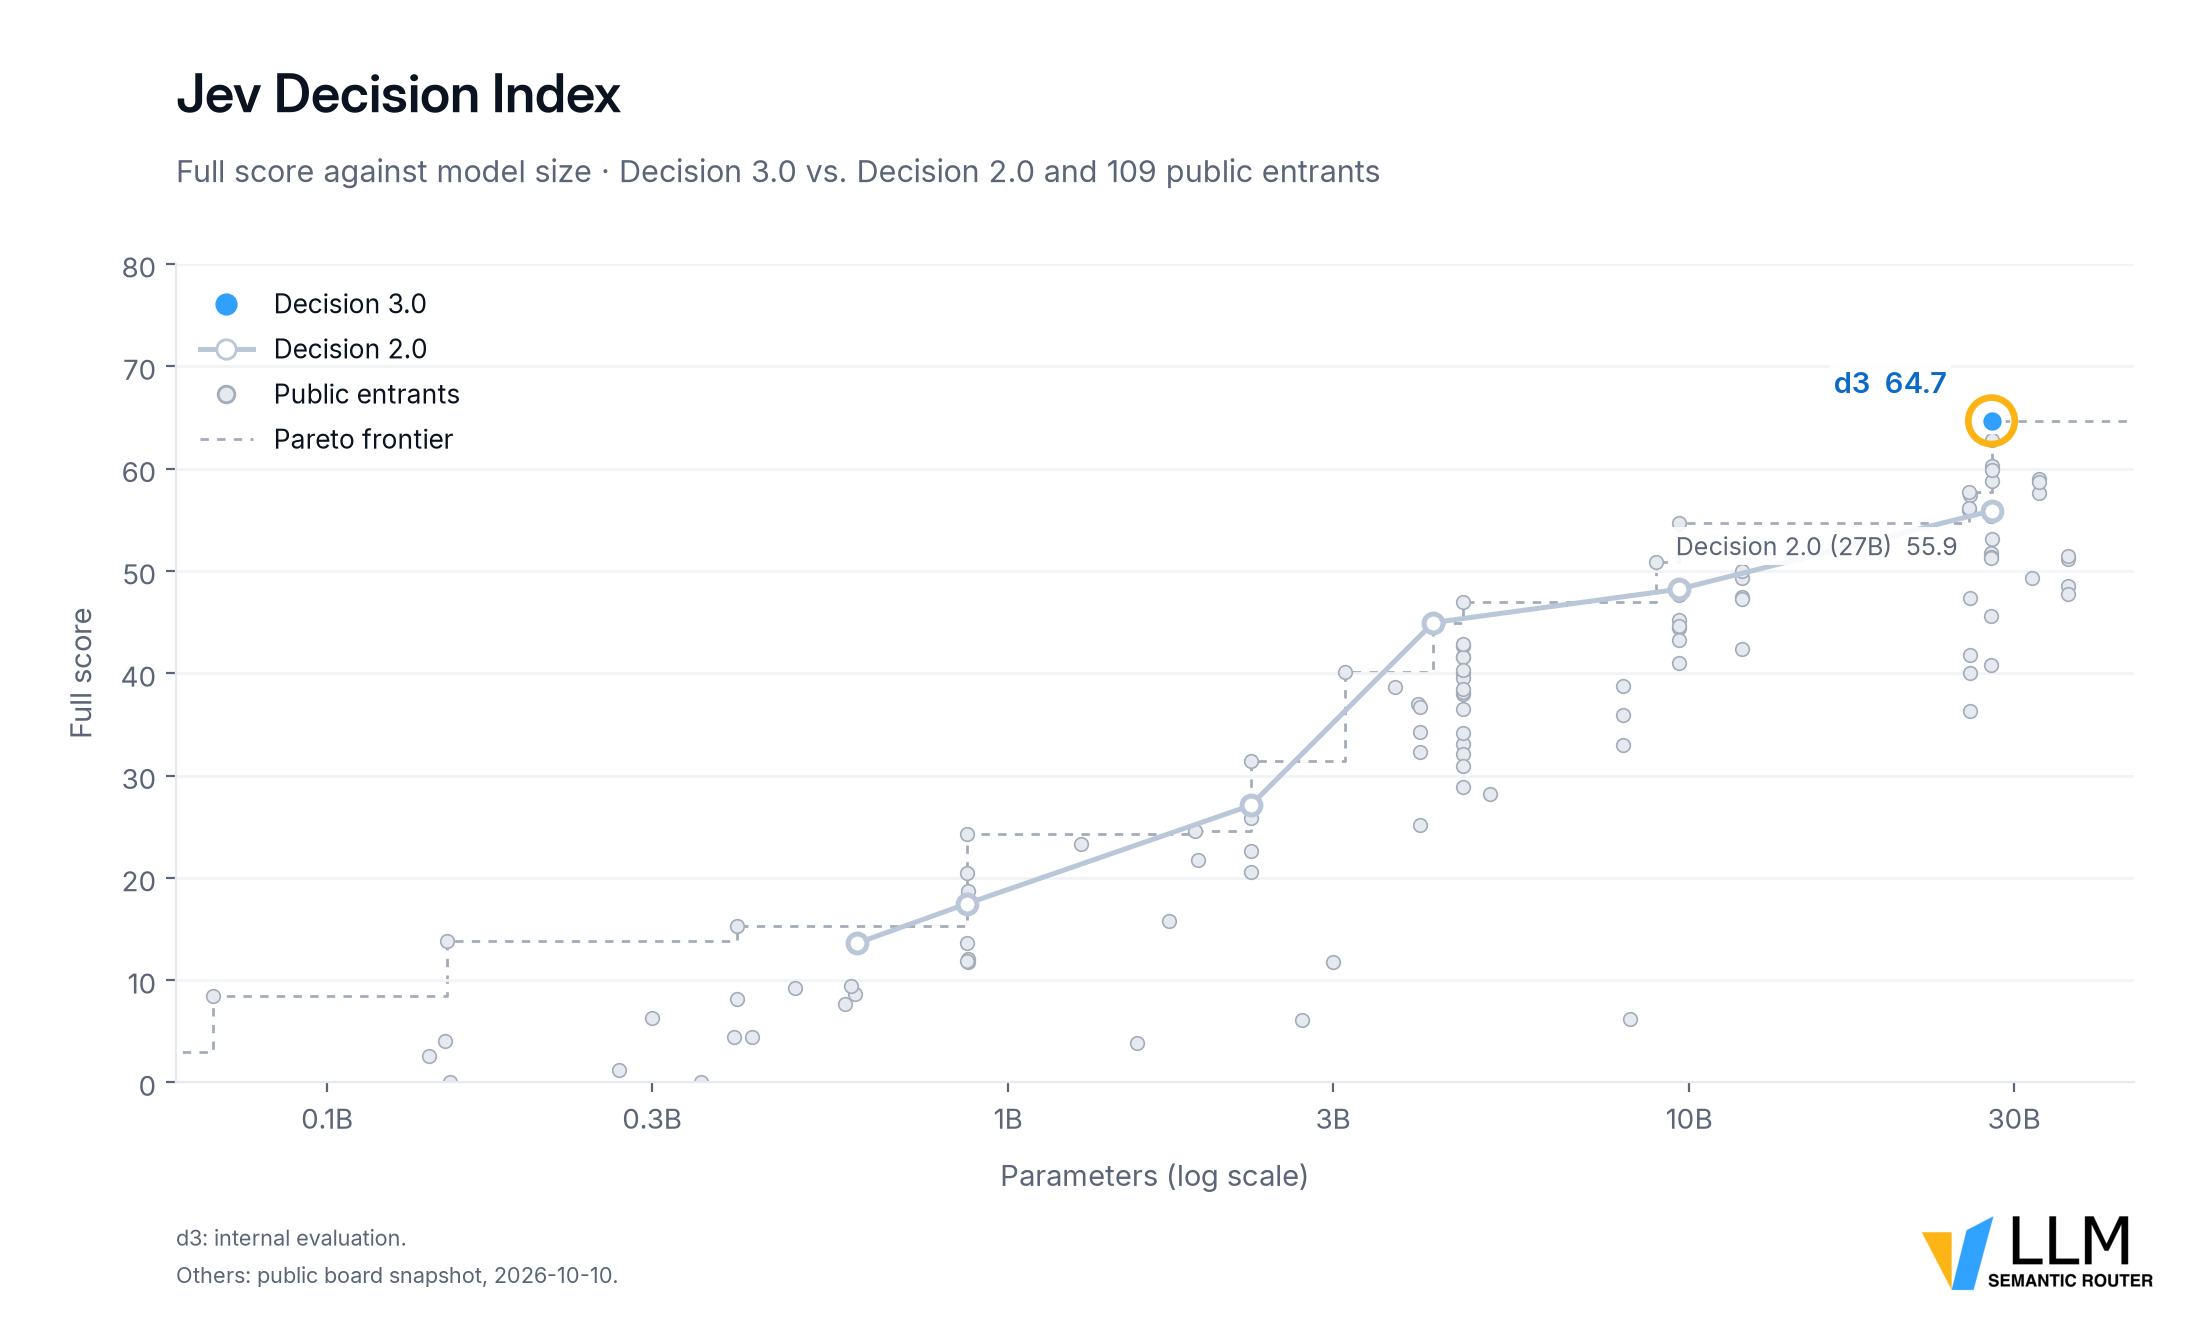
我们另核了第三方 Decision Index 的原始榜单数据:截至 2026 年 10 月 12 日 13:25 UTC 的 0.3.2 快照里,d3 的 v3.1.0 版本列文本 Full 66.26、第一位;视觉数据列 Full 71.26、第一位。这不是上一段的 64.7 与 71.6 的直接复测或可相减涨幅,版号、时间和数据归属都变了。榜单方法把公开题与非公开题组成总分,公开部分可按工具重跑,私有部分无法仅凭公开权重复建。六款模型的提交 PR #128在榜单快照之后,于 14:23 UTC 关闭且未合并;公开记录没有说明原因。我们可以准确报道那个快照曾显示第一位,不能把它扩写成不带时间与评测前提的「全球第一」或「独立复测已确认」。
真正选型时,综合榜只负责告诉你「值得列入候选」。要放行收据款项或处理现场画面,还要检验错分代价、类别分布和概率在自有样本中是否可用;一个公开指数不提供你的人工复核阈值。此前对微软决策模型速度与校准的拆解讨论过同类风险,这里不把两套不同测试环境的数字排成生产胜负表。
从 55 毫秒到一条可上线的流水线
官方在单张 AMD Instinct MI325X、一次处理一个请求的条件下,给 d3 报告文本 55 ms、带一张图 273 ms、带一段 10 秒视频 553 ms 的中位数(d3 模型卡)。这些是该硬件和请求形状上的单次模型处理指标,不包括上传大图、跨地区网络、业务队列、人工复核,也没有展示并发提升后 p95 怎么走。10 秒视频的数字更不能等同于任意时长、任意抽帧密度的视频任务。
开放权重给团队的首先是运行与验证的选择权。项目仓库提供自托管路径;d3 卡注明 Engine mode 和 Decision 3.0 在开发渠道,待稳定版纳入。下载权重和把它长期运维为服务是两件事:先以自有标签样本比较几档型号的错误,再用目标机器测图文比例、视频取样、排队和真实费用。若某类错误损失很高,给它保留人工或更强模型的升级出口;若只需检查确定性金额、日期或规章,先用明确规则,不要为每个条件都调模型。
Decision 3.0 真正带来的新选项,是把「看见一张凭证/一段动作,然后在规定答案里作答」放进同一个开放模型系列,并提供从约 0.6B 到 27B 的部署跨度。现在值得做的是拿自己的错题试这件事,而不是让一张图替你签下生产承诺。关于小型型号的 Core ML 转换,团队另有Apple Silicon 文章;那是发布方在特定 Mac 上的自测,不应与本文的 MI325X 延迟相拼。