网站声明「不用于 AI 训练」,并不等于禁止爬取和引用
__usage_ai-training 仍是个人 Internet-Draft 中的训练用途偏好提议。按 2026 年 11 月已公布的信息,拆开看爬取、训练、AI 回答 grounding 与传统搜索索引,才能决定网站该核对什么。
一家公开发布文章的网站,可能希望读者从搜索找到内容,也希望 AI 回答能附上出处,却不希望网页被用于训练模型。这不是一个自相矛盾的要求,但也不是在 robots.txt 写下一条规则就能一次解决的事。截至 2026 年 11 月 3 日,__usage_ai-training 仍是个人 Internet-Draft 提出的训练用途偏好,不是已经普遍生效的爬取禁令;两家厂商公布的是 2027 年的支持计划。对网站内容方来说,先分清爬取、训练、回答时使用内容和搜索索引,比急着复制配置更重要。
这四件事容易被压缩成同一句话:「不要让 AI 用我的内容。」可一旦要做站点决策,就得回答更具体的问题:是连机器人访问页面都不要,还是可以访问但不用于训练?希望内容不进入回答的依据,还是希望回答引用来源?希望保留传统搜索的曝光吗?不同目标对应的控制面并不相同。AI 能否用网页作为回答依据,与最终答案是否显示来源引用,也要分别判断。
__usage_ai-training 表达训练用途偏好,不是爬虫通行证
10 月 30 日的个人 Internet-Draft v00把一个新的用途名称放进 robots.txt 的 User-Agent 分组:__usage_ai-training。robots.txt 通常用于向抓取机器人表达访问规则;这份草案借用它的分组写法,专门表达内容用途。可以把专用分组理解为“针对训练用途的声明”,路径规则则指出涉及哪些页面。草案在 §3 界定训练用途,在 §4.1–4.5 提议用该组里的 Allow 与 Disallow 分别表达赞成或反对相应路径的内容用于训练。其关键不在于发明一个更强的爬虫黑名单,而在于将「为了什么使用内容」从「能否请求这个 URL」中单独说清楚。
假设一个网站的公开目录中既有长期维护的知识文章,也有暂时不希望进入训练用途的专题,草案试图让发布者按路径区别表达,而不是把整站的公开与私有硬拆成两个选择。这只是理解设计动机的假设情境,不是已部署案例,也不是建议直接上线的配置。路径规则如何被某个实际服务处理,仍取决于该服务是否、何时以及以何种方式实现提议。
草案里的两处细节尤其值得谨慎读。第一,没有专用分组不等于网站「同意训练」;按草案口径,它只是没有表达这项偏好。第二,通配的 User-Agent: * 分组不替代 __usage_ai-training 的专用表达。把原有通配爬虫规则当作新用途信号,或者把新用途信号误认为原有通配爬虫规则的替身,都会读错对象。草案明确区分用途偏好与实际的抓取指令:一个机器人能否抓取页面,是另一个需要核对的边界。
这里还有比语法更基础的状态问题。IETF Datatracker 的草案状态页标示的是个人 Internet-Draft,并非 IETF 已发布的正式标准。v00 是 2026 年 10 月 30 日的文本版本;草案中的示例证明作者如何设计表达,不证明所有服务都已经遵从,更不构成法律上的训练禁用保障。页面未来若更新,具体文字和版本都应以届时原文为准。
厂商宣布的是未来支持,不是今天已经执行
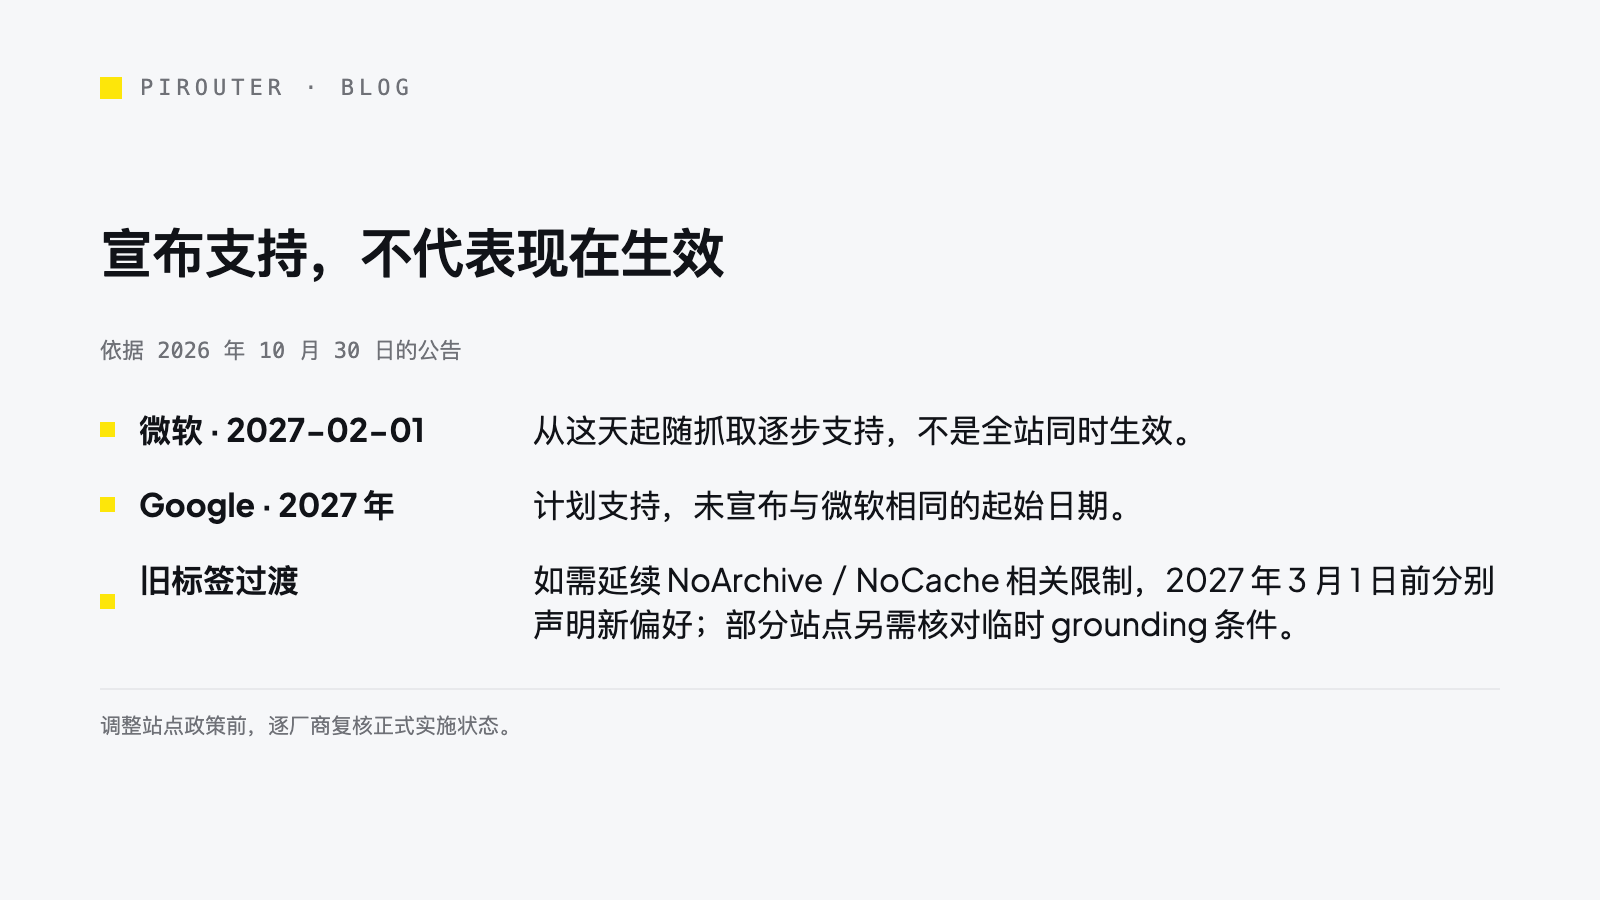
Microsoft 10 月 30 日的官方公告提出从 2027 年 2 月 1 日起,随着爬取逐步支持新的训练用途偏好。训练偏好可在路径和页面层表达;grounding 则是单独的页面级选择。这里的 grounding 指 AI 生成回答时以网页为依据,不等于最终答案一定引用该页。
另一项安排针对使用 NoArchive/NoCache 旧页面标签的网站:若希望延续这些标签原有的训练或 grounding 限制,公告要求在 2027 年 3 月 1 日前分别声明对应的新偏好。部分希望在重新抓取前维持 grounding 限制的站点,还须核对官方临时设置的适用条件。这些日期描述的是厂商公布的未来实施与过渡安排,不能倒写成 2026 年 11 月 3 日已全面生效,也不能仅凭一篇公告推断某个网站当前已得到预期保护。具体怎么迁移,应等实际操作时对照当时的官方说明,本文不提供迁移命令。
Google 同日的官方公告说的是计划在 2027 年支持。这个时间表达没有给出与 Microsoft 相同的逐步支持起点,因此不宜在图表里把两家的状态涂成同一个「2027 年 2 月上线」。Google-Extended 是 Google 已有的 AI 训练用途选择机制,不是阻止所有爬取的开关。公告给出一条具体条件:若共享 token 表达了禁用训练用途,而网站没有显式的 Google-Extended 规则,Google 计划将其视作 Google-Extended 的禁用。这是带前提的厂商计划,不是关于现有规则冲突顺序的通用推断。
从站点负责人视角看,至少有四个不该混写的时间词:草案发布、厂商宣布、计划开始实现、自己的站点得到可核验的效果。前两个可以从上述原始页面核对;后两个需要等待实施状态、产品文档与真实环境的证据。即便日期到了,公告中「逐步」也不能被改写成「所有页面同时受保护」。现在能做的,是记录要复查的来源与日期,而不是提前宣称控制已起作用。
禁止训练,不会自动关闭 grounding 或传统搜索
为什么不能把这次提议概括成「让 AI 别再看到我」?因为训练和回答时取用内容发生在不同环节。草案讨论的是训练用途偏好;它并没有因此把网站的爬取权限重新定义,也没有替所有回答系统规定统一的引用行为。Microsoft 的公告之所以另提页面级 grounding 选择,正说明其训练偏好与回答时以页面为依据是两项不同的政策选择。若发布者真正关心的是「我的文章会不会成为某个回答的依据」,单看训练信号回答不了这个问题。
至于传统搜索,Microsoft 的公告明确表示这些偏好选择不会改变进入 Bing 搜索结果的资格,但网站仍须满足通常的抓取与索引条件。这是单一厂商对其方案的说明,不等于保证任何页面都能获得排名、曝光或点击。我们查阅的 Google 公告只谈其训练用途计划与 Google-Extended 的条件关系,没有就这次新控制与传统搜索索引或排名的关系作出同样的明确声明。把「训练禁用」写成「搜索会掉排名」,缺证据;反过来写成「只要禁训练,就肯定被搜索和 AI 回答引用」,同样缺证据。
因此,检查网站政策时,建议把四个问题写在不同的行,而不是画一条从「不训练」直达「不被引用」的箭头:
| 内容方真正要决定的事 | 现有材料能说明什么 | 不能据此承诺什么 |
|---|---|---|
| 机器人能否访问页面 | 草案把训练用途偏好与抓取指令分开 | 设置训练偏好就自动阻止所有爬取 |
| 内容能否用于模型训练 | 草案提出按路径表达偏好;厂商公布未来支持安排 | 2026 年 11 月已对所有厂商生效 |
| AI 回答能否用页面作依据 | Microsoft 公告将 grounding 列为单独的页面级选择 | 训练禁用自动让回答无法引用页面 |
| 传统搜索能否保留抓取与索引资格 | Microsoft 公告称其偏好选择不改变进入 Bing 搜索结果的资格,仍须满足一般抓取与索引条件;本次 Google 公告未给出同类声明 | 各搜索引擎都已保证收录、排名与点击不变 |
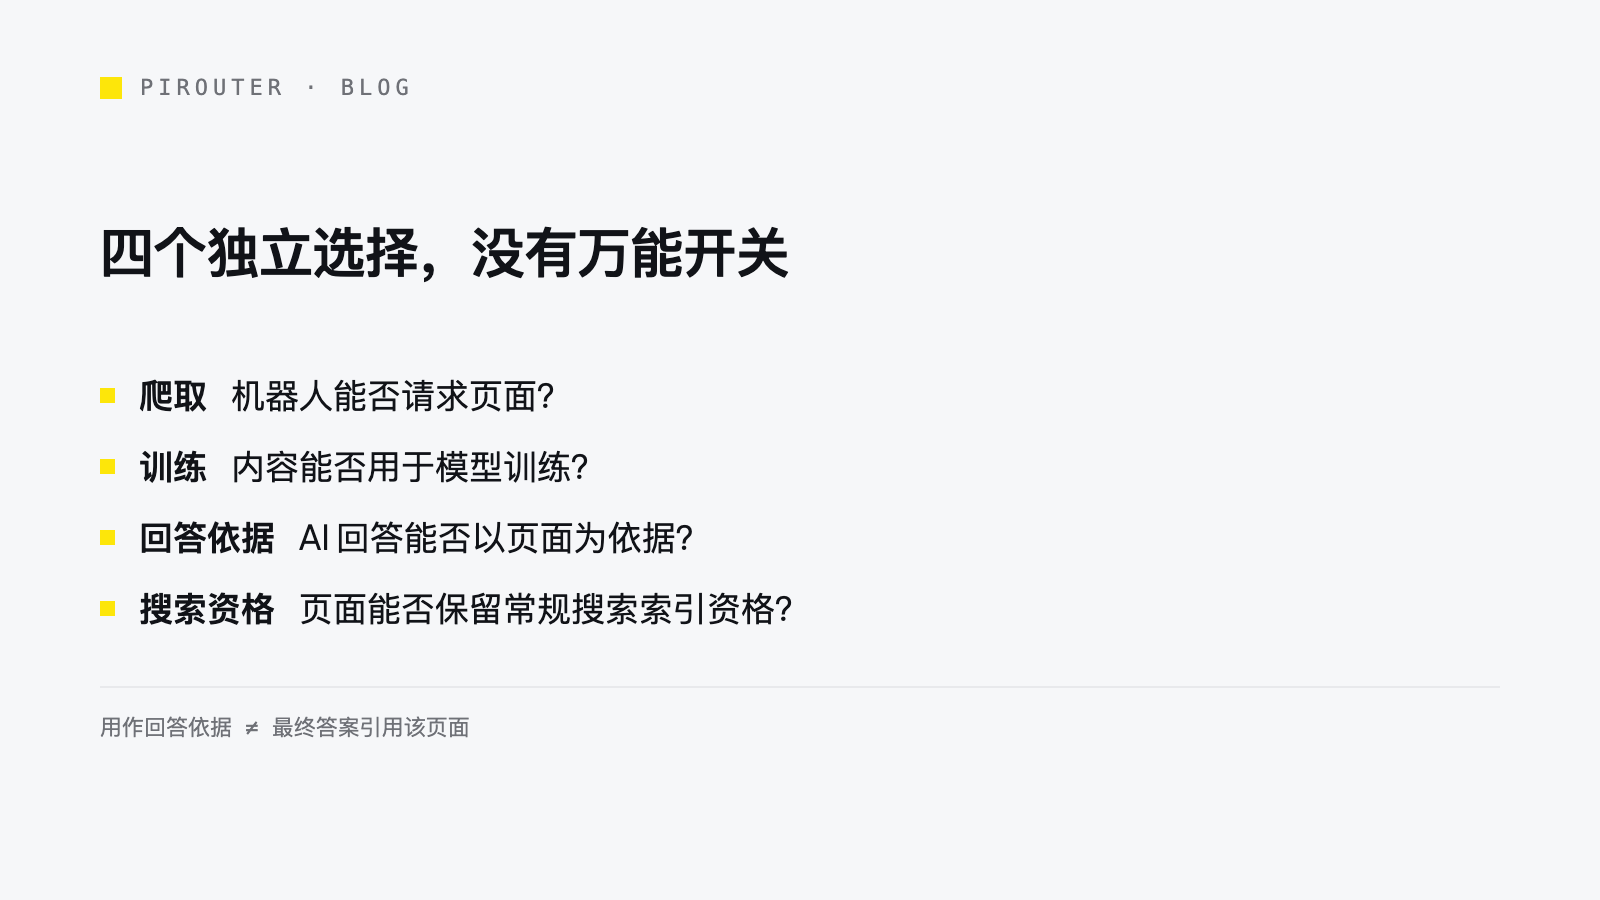
这张表并不是一份跨平台设置手册。特别是最后两行:可被用作 grounding与最终是否在答案中被引用也不是同一个结果。前者是某种内容使用路径的选择,后者还受具体提问、回答系统和选源行为影响。现有三份材料没有给出「设置后引用量变化」的实测数据,我们也没有在本站运行抓取或回答测试;因此不能把政策边界误写成效果预测。
站长现在要盘点的,是目标和证据,而不是复制一行规则
如果你的首要目标是让搜索读者继续发现文章,却希望对训练用途表达不同意见,第一步应是列出站点已有的爬虫访问规则、页面级元数据和厂商专用的现行选择。不要因为看到一个新 token 就删除原有规则:草案没有说通配分组自动转化为训练用途声明,Google 公告中的条件也特别取决于是否已经写了显式的 Google-Extended 规则。旧规则与新提议之间如何相处,应按每家当时的正式实施文档逐项复核,而不是假定后者覆盖前者。
第二步是把业务意图写成可以检验的句子。例如「允许普通搜索发现这组文章,但不愿这组 URL 用于训练」,与「希望回答不能以该页面为依据」是两个不同要求;如果两者都要,就分别找对应机制和当下支持它的实施方。若目标是阻止访问,仍须回到爬取控制本身。文中这些假设只帮助拆分问题,不是已验证的生产配置建议。
第三步是按现状安排动作:
- 没有相关旧标签、只是评估新信号的网站:先保留符合原有目标的抓取与索引设置,登记希望区别对待的 URL 路径,待实施文档明确后小范围验证。
- 已使用 NoArchive/NoCache、且希望延续相关限制的网站:现在就盘点受影响页面、指定负责人,把 2027 年 3 月 1 日前核对并完成所需过渡列为待办,同时核查重新抓取前的临时 grounding 设置条件;这个期限不适用于所有网站。
- 希望阻止未经授权访问的网站:评估现行身份验证与访问控制,不等待新用途信号。robots 偏好不能替代访问授权。
这些准备需要人工盘点标签、逐厂商复核和后续抽样验证;本文没有本站数据,不能承诺工时、费用或收益。记录草案版本、公告日期和下次复查时间,比提前给两家的未来计划都打上「已支持」更有用。
还有一个常被混在一起的问题要单独放回原位:公开网页上的用途偏好,与把文本发送给某个模型 API 后的输入数据训练及保留条款,属于不同合同与技术路径。即使将来网页信号得到支持,也不能推导出 API 提交内容的处理规则因此改变。反过来,读过某家的 API 隐私条款,也不能拿它当这次网站草案的实施证据。
现在可以下的判断是有限但有用的:这份提议为网站表达训练用途偏好提供了一套可讨论的写法,厂商已给出未来支持计划;它还没有把训练、爬取、grounding 和索引压成一个万能开关。内容方可以先决定自己究竟要控制哪一步,再在每家正式实施且可验证时调整站点。到那时,最值得更新的不是一句「AI 不再使用我们的内容」,而是每一项目标对应的规则、适用范围和实际验证结果。