Gemini 4 Hydrogen の4段階推論、開発チームは high を基準に使い分ける
low・medium・high・xhigh をコーディングエージェントの作業ごとに選ぶには。独立評価の数値と公式仕様を分け、品質、待ち時間、再実行の記録から判断する。
表紙:Google公式の発表ビジュアル。画像出典。
Gemini 4 Hydrogen の推論設定は low、medium、high、xhigh の4段階で、既定値は high です。日常のコーディングエージェントでは、まず high を比較の基準にし、結果を自動検証しやすい工程で medium や low を試す。xhigh は複雑な変更の候補に残すものの、全工程の既定値にはしない。これは公開資料に基づく試験の順序であり、特定の開発環境で得られた最適設定ではありません。
たとえば、テストの失敗箇所を探す、既知の関数を修正する、変更の副作用をレビューする、という3段階の作業を考えます。あくまで想定例です。各段階で必要な判断の重さと、間違いを見つけるまでの時間は違います。そこで「一番高いスコアの設定を全リクエストに適用する」より、どの失敗を自動的に検出できるかを先に決めるほうが、チームの運用に結びつきます。
開発作業では、モデルの応答時間だけを「速さ」と呼べない
Google は 2026 年 11 月 12 日の発表で Hydrogen をエージェント作業の “daily driver” と位置づけました。公開ページは翌 13 日に更新されています。日常のコード編集を意識した発表ですが、その表現は「どのチームでも既存の作業より速くなる」という検証結果ではありません。
エージェントの作業時間には、モデルの応答以外も入ります。ファイルを読む、ツールを呼ぶ、テストが終わるのを待つ、失敗した箇所を直し直す。初回の回答が短時間で返っても、その後のレビューで不備が見つかれば、完了までの時間は延びます。逆に、推論に時間をかけた回答が再作業を減らせれば、チーム全体では早く終わるかもしれません。どちらが起こるかは、対象のリポジトリと合格条件を決めなければ測れません。
Google が発表した Terminal-Bench 4.1 の比較は、Hydrogen が 57%、Gemini 3.8 Flash が 18.2%。公式の評価方法によれば、Hydrogen は high 設定で5回の試行を平均した cheating-adjusted の数値です。同じ公式一覧では、Hydrogen の57.0%を上回る 63.9% のモデルも掲載されています。Terminal-Bench-Science 0.1 でも Hydrogen 51.4%に対して表中の最高値は59.9%であり、全項目での首位ではありません。これは自分たちの CI を通る割合でも、4段階それぞれの成功率でもありません。公開された比較は試す理由にはなりますが、運用の採用判定を代行しません。
4段階の独立評価は、どこまで判断材料になるか
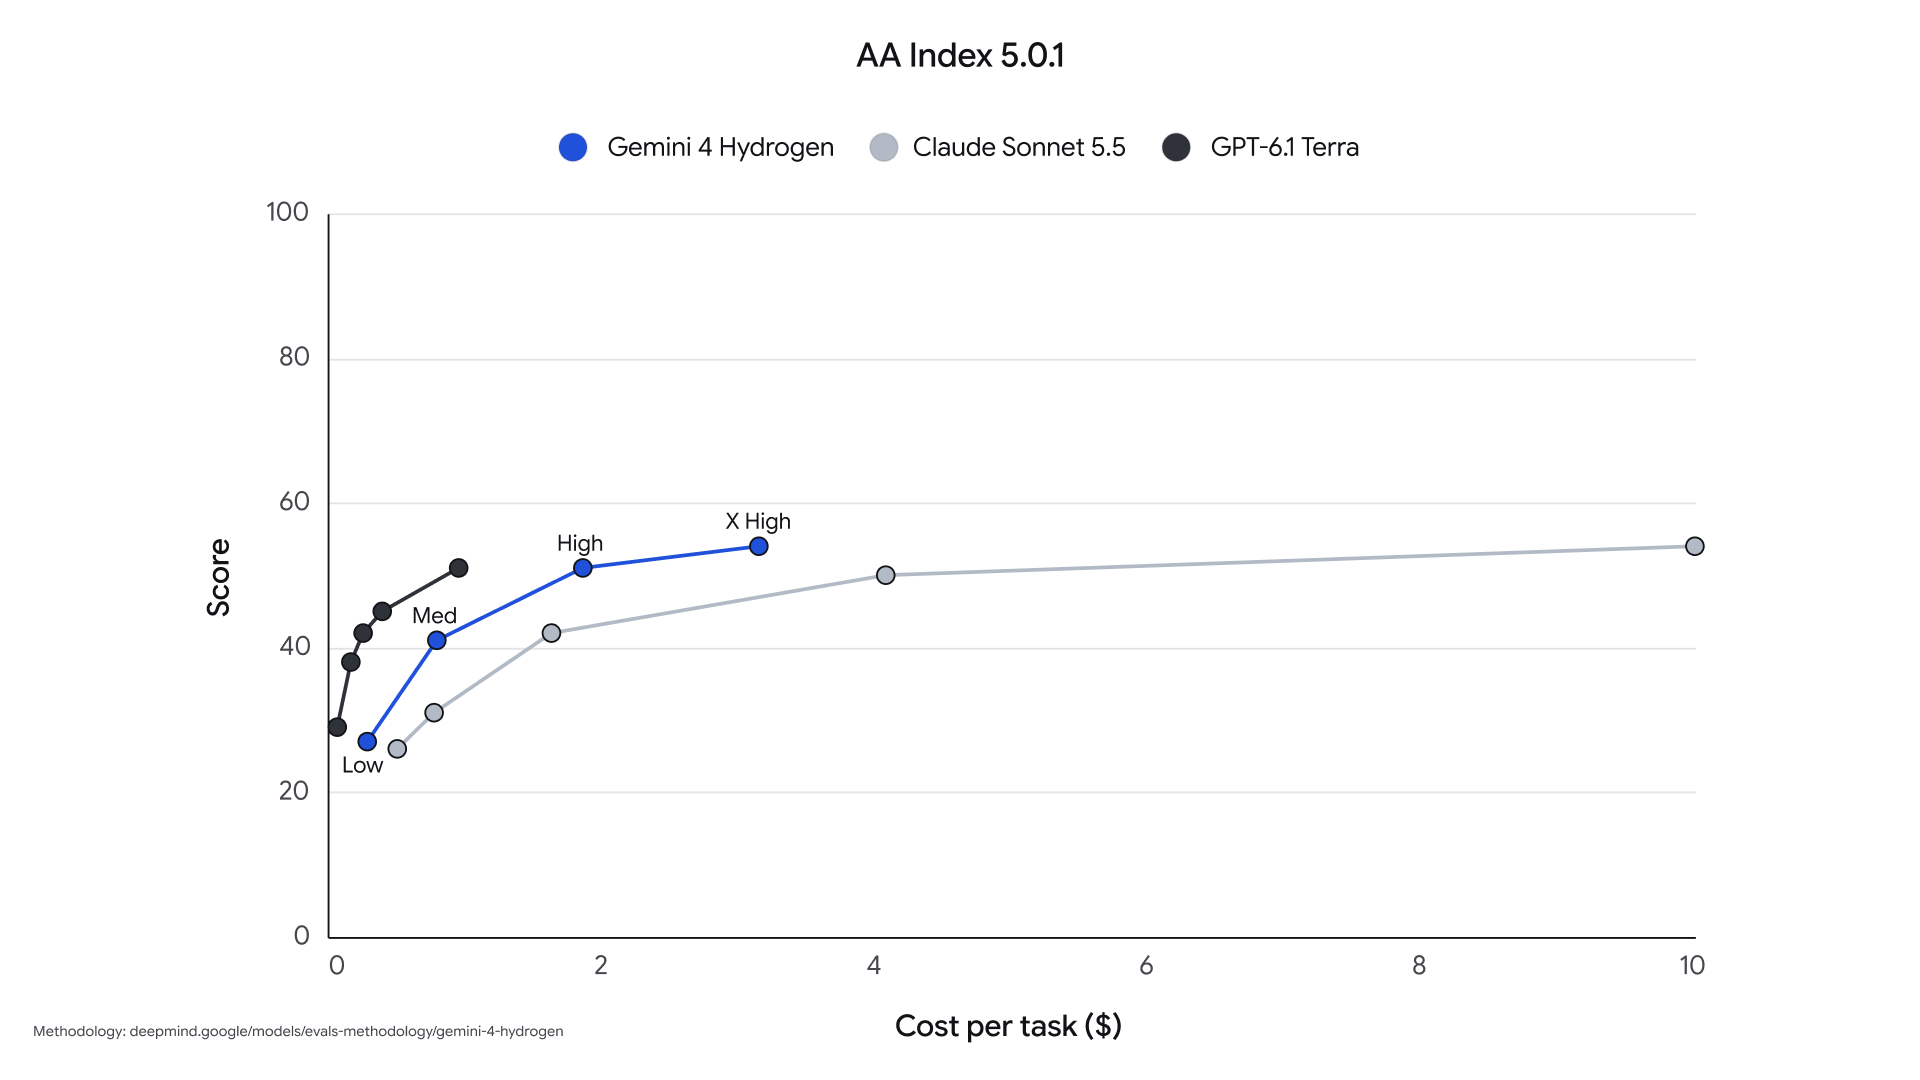
Artificial Analysis の 2026 年 11 月 12 日の更新では、Hydrogen の Intelligence Index v5.0.1 が low 27、medium 41、high 51、xhigh 54。同社の複数の評価を組み合わせた指数であり、「low はコード修正を27%完了する」という意味ではありません。high と xhigh の3ポイント差を、そのまま社内タスクの採用率の差として見積もることもできません。
もう一つの尺度は時間です。Artificial Analysis のモデル評価を後から確認した値は、同社の評価タスクについて xhigh が 1件あたり14.8分、high が 8.4分。xhigh の費用も同社の条件で 1件あたり$3.16 と示されています。一方、Google が発表時に載せた速度図では high が約6分、xhigh が約13分と読めます。掲載時点と条件が同一とは確認できず、図を後日の8.4分/14.8分の根拠にしてはいけません。 いずれも自分たちのコード修正時間の予測や API の定額料金ではありません。
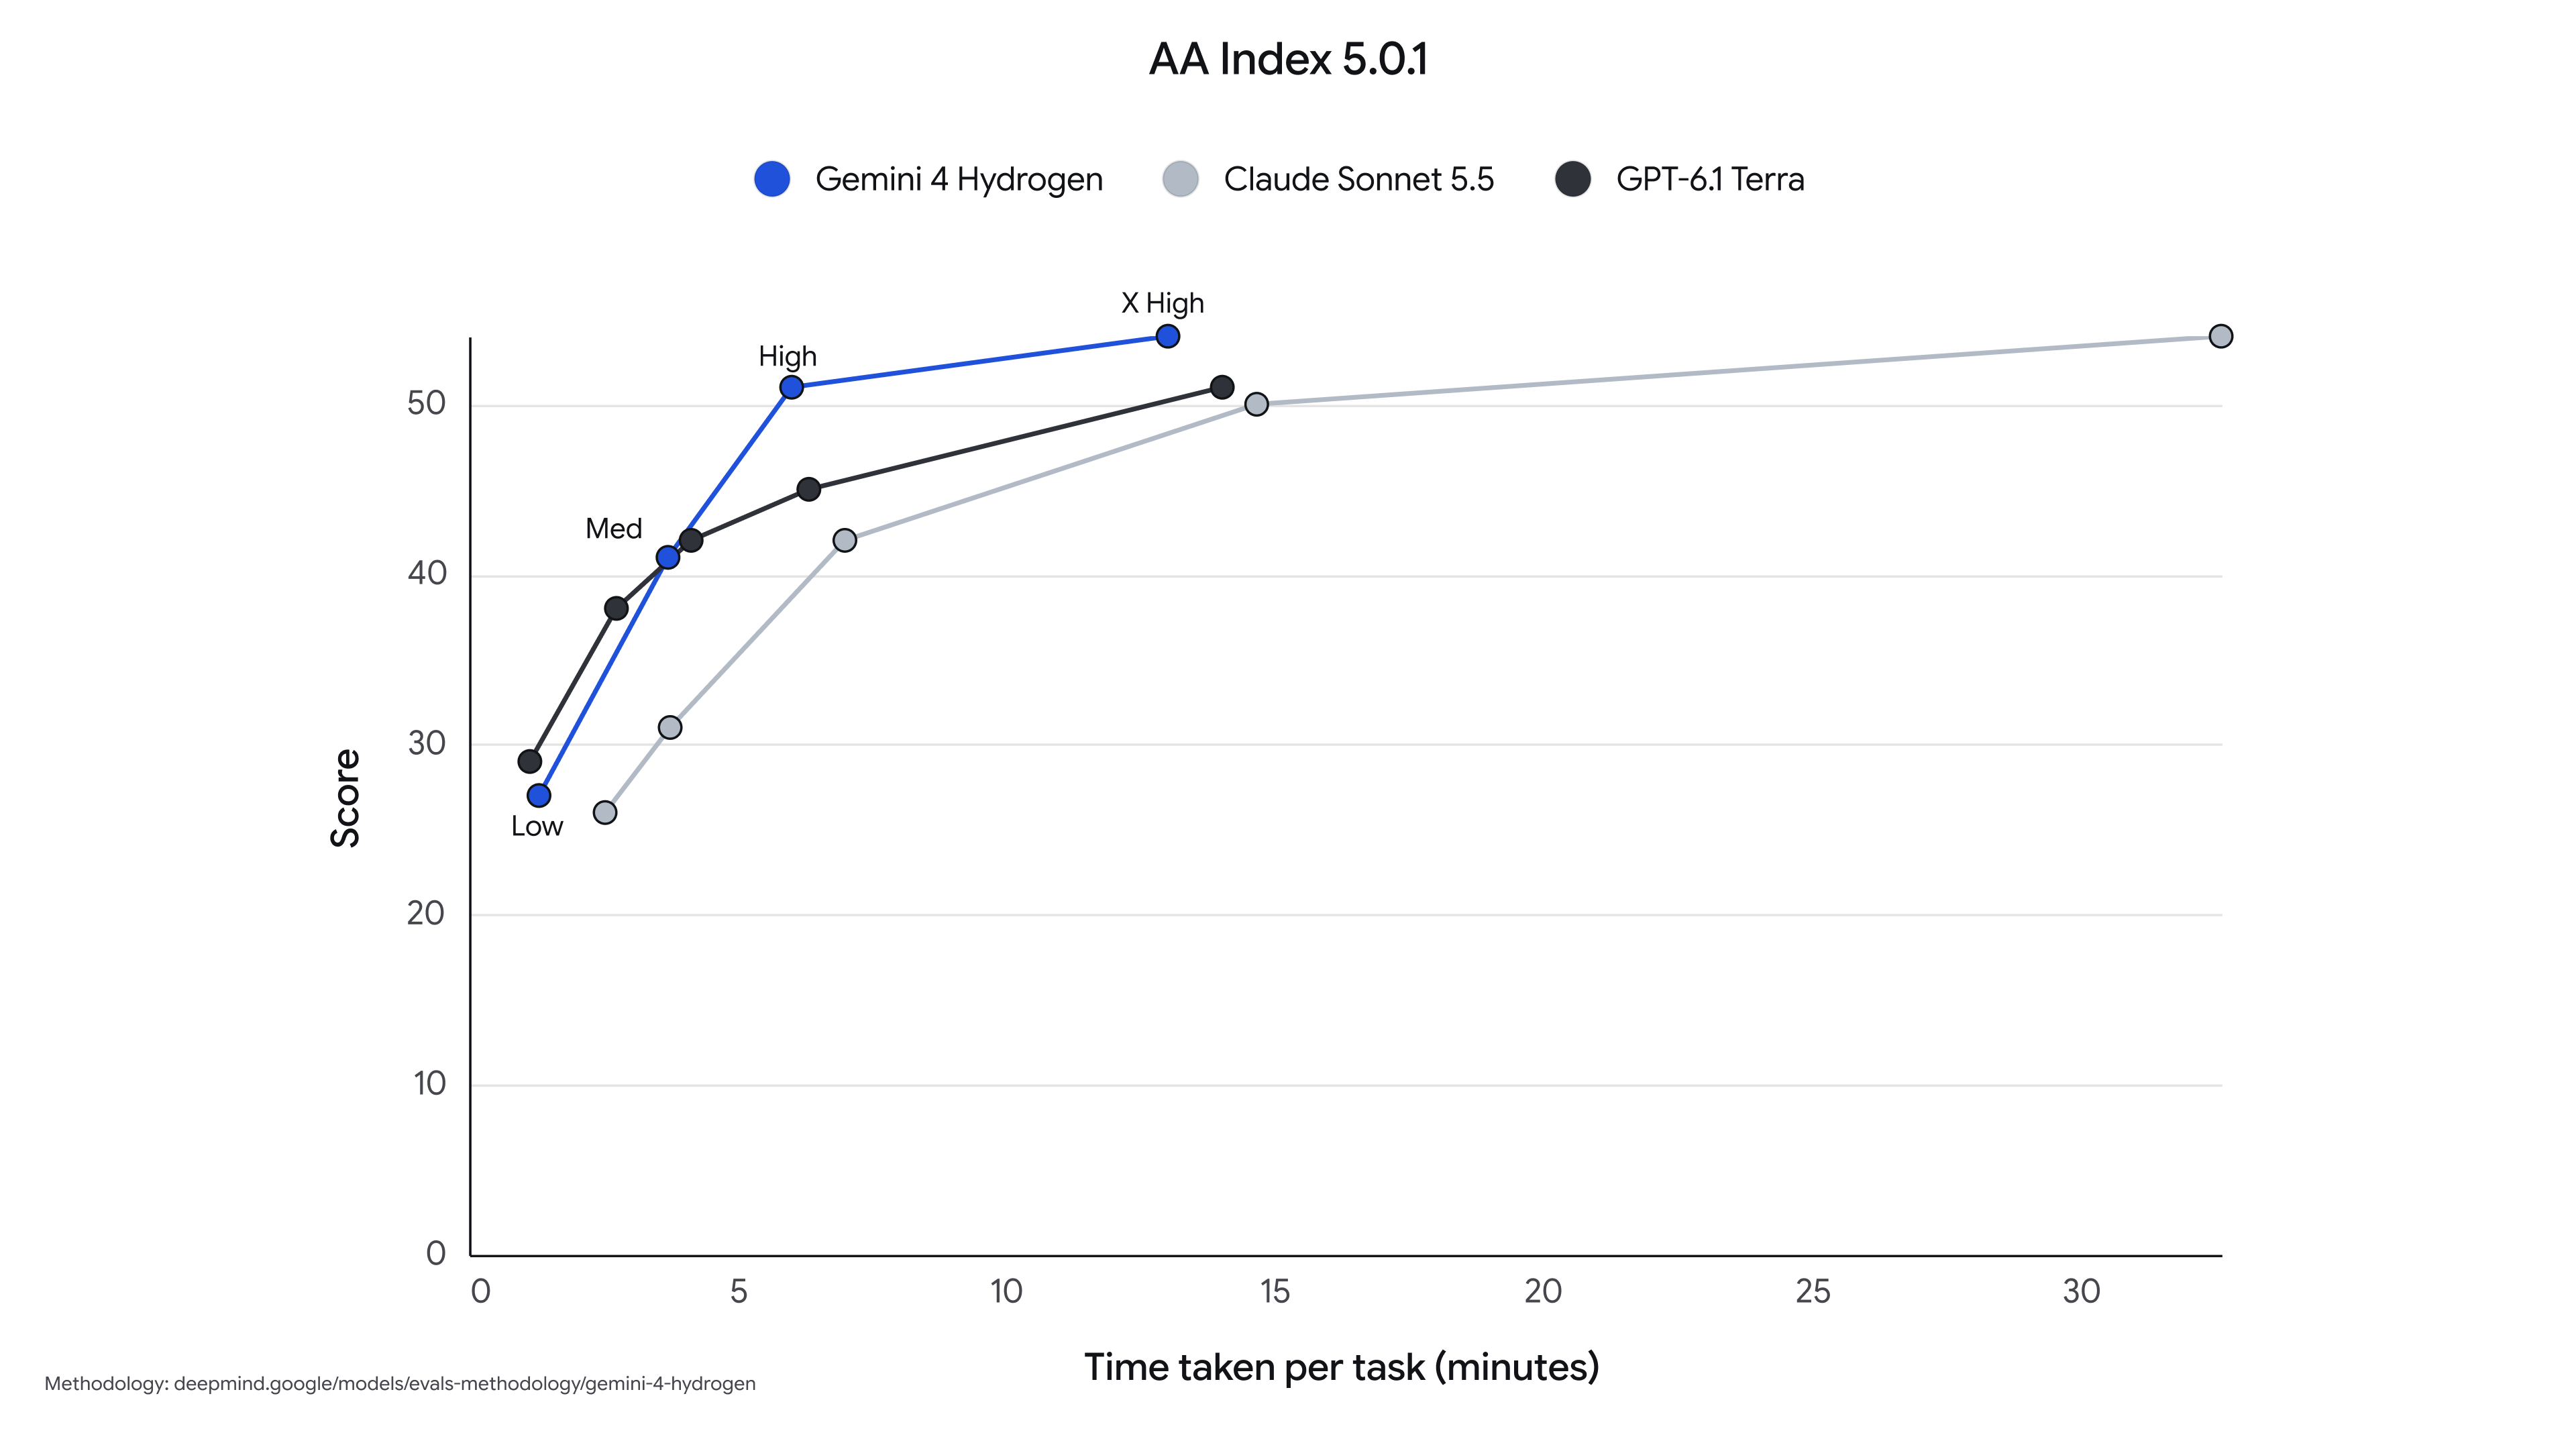
この二つの資料を併記する理由は、異なる問いに答えているからです。Google の Terminal-Bench 4.1 は、同社が提示した旧モデルとの比較。Artificial Analysis の指数は、4段階を独立した評価セットで見た結果です。ベンチマークの名称と版、測定した組織を外して数字だけ並べると、同じ試験を二度実施したように読めてしまいます。チームが持ち帰るべきなのは単一の順位ではなく、設定によって品質と待ち時間が動く可能性があるため、同じ仕事で比較する必要があるという課題です。
low・medium・high・xhigh を作業ごとにどう割り当てるか
以下は採用済みの設定例ではなく、比較試験を組むための仮説です。検索結果の整理や、失敗しても安全にやり直せる定型処理なら、low と medium を候補にできます。ただし、形式上は整っていても内容が間違っている出力を自動検出できない場合、「低リスクの定型処理」という分類自体を見直すべきです。
テスト付きの小さなコード変更には、high を基準として medium も試す。比較するのは返答文の見栄えではなく、テスト、変更差分、人が受け入れたかどうか、再実行の回数です。テストが通っても仕様を満たさない変更は失敗として記録します。複数ファイルにまたがり、誤りを後から発見しにくい変更では、xhigh を対照群に加える余地があります。ただし、推論レベルを上げることはレビューや権限管理の代わりにはなりません。
| 想定する工程 | 比較試験の候補(仮説) | 合格条件の例 |
|---|---|---|
| 既知の形式で結果を整える | low と medium | 内容の照合まで自動化できるか |
| テスト付きの小規模修正 | high と medium | テストに加え、差分を人が承認するか |
| 影響範囲の広い変更 | high と xhigh | 副作用の確認を含めて承認できるか |
表の設定は推奨値を保証するものではありません。使うツール、入力長、テストの質が変われば分類も変わります。とくに「人が最後に見るから大丈夫」という作業は、レビュー待ちが長くなると失敗費用が表から消えます。1回の API 呼び出しだけでなく、受け入れられた1件の変更を観測単位にすると、再作業を含めた判断ができます。
API の単価と百万トークン窓は、作業費用そのものではない
Google の価格表を 2026 年 11 月 16 日に確認した時点で、Hydrogen の標準料金は入力が100万トークンあたり $1.50、出力が $7.50。出力には thinking も含まれます。Batch は入力 $0.75、出力 $3.75。暗黙キャッシュで実際に命中した入力は標準料金で $0.075 です。推論レベルごとに別のトークン単価が設定されているわけではありませんが、各工程の出力トークン数、再試行、キャッシュの命中は変わり得ます。表の単価だけから完了した作業の費用は決められません。
モデルの API 仕様では、コンテキスト上限は 1,048,576 トークンの入出力共通枠。通常の同期リクエストにおける最大出力は 65,536 トークンで、最大 1,048,576 トークンの出力には long decode が必要です。「百万トークンの枠がある」ことを、普段の応答が百万トークン出るという意味に置き換えてはいけません。コード、ツールの結果、過去の会話が増えるエージェントでは、履歴を含めた入力長を記録することが先です。
比較対象の価格にも時点があります。同じ価格表に載る Gemini 4 Carbon の標準入力/出力は、2026 年11月30日まで $2/$10、12月1日から $4/$20(いずれも100万トークンあたり)。現在の期間限定価格を恒久的な基準にしないこと。ここで示したのは Google API の価格であり、別のサービスの請求額や利用可能な機能を示すものではありません。暗黙キャッシュへの対応も、実際の命中率を保証しません。
小さく試すなら、各レベルで同じ失敗を数える
チームで試すときは、作業を数種類に絞り、開始前に合格条件を固定します。同じリポジトリ状態から、同じツール権限と制限時間で実行し、推論レベル、入出力トークン、実際のキャッシュ命中、ツール呼び出しの回数、経過時間、テスト結果、人による却下理由を記録します。失敗後の再実行も1件の作業に含めます。これは導入時の検証手順の提案であって、この記事が行った実測ではありません。
まず high と medium の差を確認し、内容の検証が容易な工程で low を加える。複雑な工程では xhigh を加え、品質が上がる場合でも、レビュー待ちや追加費用に見合うかを確認する。優劣が安定しない少数例だけなら設定を固定せず、判断保留にするほうが誠実です。Google の発表図、独立指数、自分たちの運用記録はそれぞれ役割が違います。
現時点で確かなのは、Hydrogen に4段階の設定と公開価格があること、そして独立した評価では段階ごとに異なる数値が報告されていることです。自分たちの開発作業で最も安く、早く、受け入れ可能な変更を作る設定は未確認。その答えが必要なら、high を出発点に、失敗を見つける方法まで含めて比較してください。