
DeepSeek V4.1 Flash 値下げの中身:戻ったのは入力 2 項目、出力は値上げ前の 2 倍のまま。deepseek-v4-pro の切り替えは撤回(9 月 28 日更新)
8 月の値上げの発効から 24 日で DeepSeek が Flash を値下げしました。公式価格ページの 3 時点(8 月 10 日・8 月 17 日・9 月 10 日)を USD と元で並べると、戻ったのはキャッシュヒットとミスの 2 項目で、出力は値上げ前の 2 倍。節約幅はトークン構成で 9〜60% に開き、計算例の 2 構成では 15% と 33% でした。(9 月 28 日更新:DeepSeek は 9 月 14 日以降も V4 Pro を課金方式そのままで提供すると改め、予告されていた切り替えはなくなりました。)552B・748B・763B の読み方、MIT 重みを動かす 614GB、14 日までの回帰テストと grep まで。
更新(2026-09-28):公開後、DeepSeek は更新履歴の 9 月 10 日の項目を書き換え、「In response to user demand, we have decided to continue providing API services for DeepSeek V4 Pro after September 14, 2026, with the billing method remaining unchanged. We will provide further notice should there be any changes.」としました(9 月 27 日確認)。本文の「9 月 14 日から deepseek-v4-pro はすべて V4.1 Flash にルーティングされ、オプトアウトはない」という部分はもう当てはまりません。Flash 値下げの分析には影響しません。項目は日付を改めずに書き換えられたため、方針が変わった正確な時期は分かりません。
先に答えを書きます。9 月 10 日の値下げで値上げ前の水準に戻ったのは、入力の 2 項目(キャッシュヒットとミス)だけです。出力は値上げ前の 2 倍のまま残りました。節約幅はトークン構成で決まり、9〜60% に開きます。日本時間 9 月 14 日(月)13 時からは、Pro モデル(deepseek-v4-pro)への呼び出しがすべて V4.1 Flash にルーティングされ、Flash 価格で課金されます。オプトアウトの記述は 4 つの公式文書のどこにもありません。
ITmedia の見出しは「値上げから一転」でした。一転したかどうかは比較の起点で答えが変わるので、起点を 3 つ置いて同じ通貨で並べます。
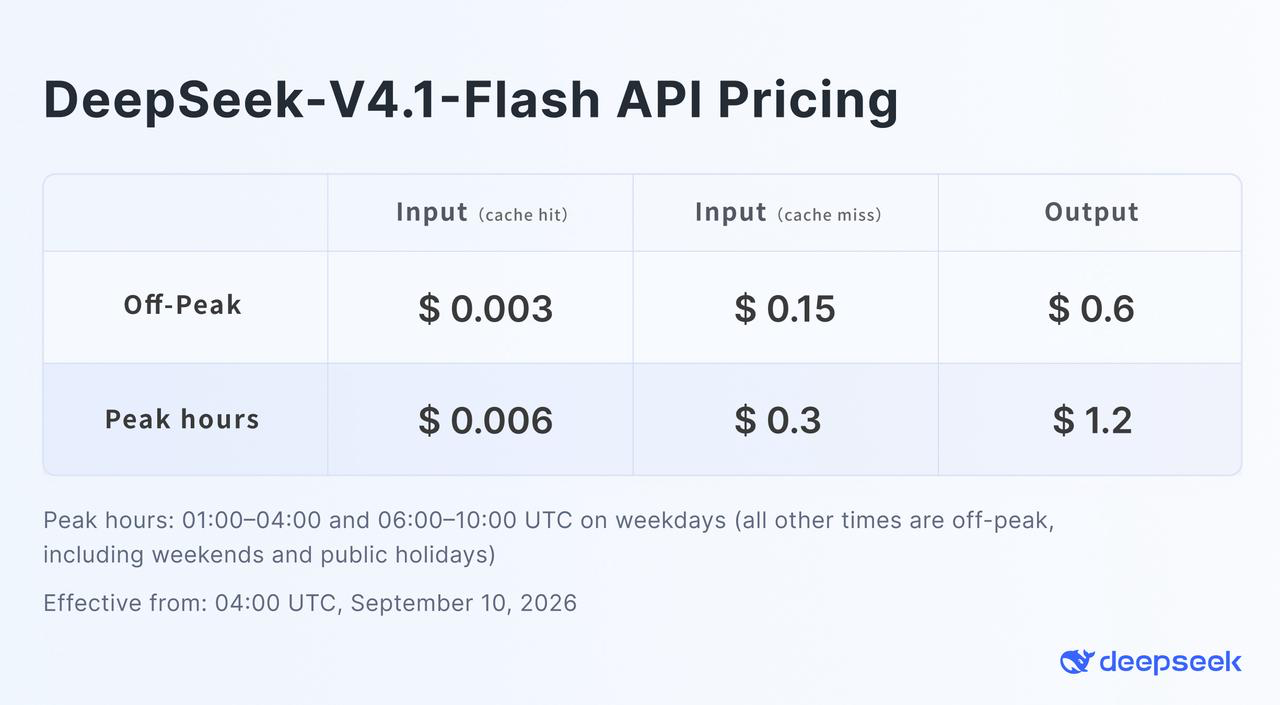
3 つの価格表を同じ通貨で並べる:戻った 2 項目、戻らなかった 1 項目
ITmedia は USD の 1 時点、掘金(中国語の技術メディア)は元建ての 3 時点なので、そのままでは比較できません。値上げ前の USD 表はWayback Machine の 2026 年 8 月 10 日のスナップショット、現行値は 9 月 11 日に読んだModels & Pricing、元建ての過去 2 時点は掘金「DeepSeek 明天又降价(涵历史价格对比)」の転記です。
Flash、100 万トークンあたり。8 月 16 日以降はオフピーク / ピークの 2 段です。
| 項目 | 8 月 16 日 16:00 UTC まで | 8 月 16 日から(オフピーク / ピーク) | 9 月 10 日 04:00 UTC から(オフピーク / ピーク) | 元建て 3 時点(オフピーク) |
|---|---|---|---|---|
| 入力・キャッシュヒット | $0.0028 | $0.007 / $0.014 | $0.003 / $0.006 | 0.02 → 0.05 → 0.02 元 |
| 入力・キャッシュミス | $0.14 | $0.22 / $0.44 | $0.15 / $0.30 | 1 → 1.5 → 1 元 |
| 出力 | $0.28 | $0.66 / $1.32 | $0.60 / $1.20 | 2 → 4.5 → 4 元 |
ITmedia の「8 月 13 日の値上げ」はDeepSeek-V4-Pro GA Release 2026/08/13が予告した日、掘金の「8 月 17 日」は発効日の北京時間です。公式の発効は 8 月 16 日 16:00 UTC、日本時間 17 日 1 時。そこから 9 月 10 日 04:00 UTC(日本時間 13 時)の値下げまで、日本の暦で 24 日でした。
元建ての列では、入力の 2 項目は 0.02 元と 1 元に小数点以下まで戻っています。出力は 4.5 元から 4 元に下がりましたが、値上げ前の 2 元の 2 倍です。USD の列は違います。入力は $0.0028 → $0.003、$0.14 → $0.15 で 7% 高く、出力は $0.28 → $0.60 で 2.14 倍。差は換算レートで、8 月以前の表は 1 ドル ≈ 7.1 元、9 月の表は ≈ 6.7 元で丸めたと逆算できます(当方の計算です)。USD で払う人にとって「元に戻った」は「7% 高いところまで戻った」です。
節約幅は 9% から 60% まで:自分のトークン構成で計算する
8 月 17 日の表からの下げ幅は項目ごとに違います。元建てで −60% / −33% / −11%、USD で −57% / −32% / −9%。請求全体の節約率は、この下げ幅を 8 月 17 日の表での各項目の請求シェアで加重平均したものです。USD なら「0.57 × ヒットのシェア + 0.32 × ミスのシェア + 0.09 × 出力のシェア」。シェアはトークン数ではなく金額の割合です。
2 つの構成で計算します。いずれもオフピーク、USD です。
| 構成(100 万トークン単位) | 8 月 16 日まで | 8 月 17 日の表 | 9 月 10 日の表 | 8 月 17 日比 | 値上げ前比 |
|---|---|---|---|---|---|
| 出力中心:ミス 1M + 出力 1M | $0.42 | $0.88 | $0.75 | −15% | +79% |
| Agent 型:入力 20M(ヒット 95%)+ 出力 0.2M | $0.249 | $0.485 | $0.327 | −33% | +31% |
出力中心の構成では 15%。Agent 型で入力の 95% がキャッシュヒットという寄せた構成でも 33% で止まります。60% は請求のほぼ全部がキャッシュヒットのときの数字で、そういう請求は現実にはありません。値上げ前比の列のとおり、見出しは一転しましたが請求書は一転していません。
自分のシェアは API が返しています。usage の prompt_cache_hit_tokens と prompt_cache_miss_tokens(Context Caching)を 1 日分足し、ピークと閑時を分けて金額に直せば、上の式に入れる値が出ます。
値下げより効くのはこちらかもしれません。ピーク時間は平日 01:00〜04:00 と 06:00〜10:00 UTC、日本時間では 10 時〜13 時と 15 時〜19 時で、就業時間はほぼピークです。閑時は半額なので、日中のバッチを夜に寄せられるなら −15% より大きく動きます。仕組みは英語刊の DeepSeek peak pricing: which 30% of your bill can move に譲ります。
起点が違うと、同じ表から逆の結論が出ます。HN のスレッド(取得時点で 668 ポイント)では「V4 Flash は出力 $0.16 だったのに 4.1 は $1.20」という投稿を、別の投稿者が「1 か月前は $0.28、先週は $0.66 / $1.32、いまは $0.6 / $1.2」と訂正しました(DeepSeek v4.1 Flash)。同業の第三者記事には「it is the same Flash rate card as before rather than a cut」とするものもあります(DeepSeek V4.1 Flash: A Brand-New Base Model Wearing a Point-Release Number)。8 月 17 日の公式表は $0.007 / $0.22 / $0.66 で、9 月 10 日の表とは違います。起点を書かない「値下げ」も「値下げではない」も、検算できません。
9 月 14 日 13 時、deepseek-v4-pro は名前だけ残る
更新(2026-09-28):この節は 9 月 10 日の告知時点の内容です。DeepSeek はその後 V4 Pro の提供継続を決めました。冒頭の注記を参照してください。
価格ページの脚注 (2) はこう書いています。
From 12:00 Beijing Time on September 14, 2026, and until V4.1 Pro is released in the future, requests to deepseek-v4-pro will all be routed to V4.1 Flash and billed at the V4.1 Flash price.
API 利用者に届いたメールにも「we plan to postpone the discontinuation of the V4 Pro service to 12:00 Beijing Time on September 14, 2026」とあります(利用者が HN に全文を転載:lionkor のコメント)。Change Logも同趣旨です。4 つの文書のどこにも、Pro のまま使い続ける選択肢はありません。V4.1 Pro の公開日も未公表です。
同じことは 9 月 10 日にもう起きています。deepseek-v4-flash と deepseek-v4-flash-vision-exp は「still accepted」ですが、モデル本体は提供終了で、リクエストは V4.1 Flash が処理しています。名前が同じなら古いモデルが残っている、という理解は成り立ちません。
新しく書くコードが指定すべき名前は deepseek-flash です(v4 が抜けます)。これが V4.1 Flash の正式名で、上の 2 つは互換のための別名にすぎません。別名が生きているうちに本名へ書き換えるのが安全です。
14 日 13 時に deepseek-v4-pro を呼ぶ側で変わるものを並べます。記号は公式文書での裏づけで、✓ は明記あり、⚠ は記載がなく自分で測る項目、✗ は同意なしに変わる項目です。⚠ の 3 項目は 14 日以降にしか確認できません。
| 項目 | 14 日 13 時以降 |
|---|---|
| モデル | V4-Pro-0813(1.6T / 49B active)から V4.1 Flash(552B / 8B・16B active)へ。同意手続きなし |
| 価格 | Pro のオフピーク $0.022 / $0.66 / $1.98 → Flash の $0.003 / $0.15 / $0.60。−86% / −77% / −70% |
| 画像入力 | Pro は非対応、V4.1 Flash は対応。Pro の名前で画像を送れるかは未確認 |
| 同時実行数 | 価格ページでは Pro 500、Flash 2,500。Pro の名前での上限は記載なし |
| effort の名前 | low / high / max はそのまま。中身が別モデルなので同じトークン量にはならない |
応答の model 欄 | 公式文書に記載なし。14 日の前後で記録して比べる |
下がりながらモデルが変わる、というのがこの表の要点です。名前は契約上の識別子で、中身は供給側が決めます。この構造は英語刊の Cursor loses OpenAI models on November 12 に書きました。
「V4 Pro を全面的に上回る」は自己申告:ベースモデル 16 項目中 12 項目は V4 Pro が上
切替の根拠は「comprehensively surpassed V4 Pro in performance, cost, speed, and total time」です。数字はベンダー自身の評価で、DeepSeek-V4.1-Flash モデルカードにあります。
Agentic の表では、両モデルにスコアのある 12 項目すべてで V4.1 Flash が上です。Terminal-Bench 3.0 は 30.0 対 11.8、DeepSWE v1.1 は 74.2 対 62.7、AutomationBench は 54.8 対 43.2。
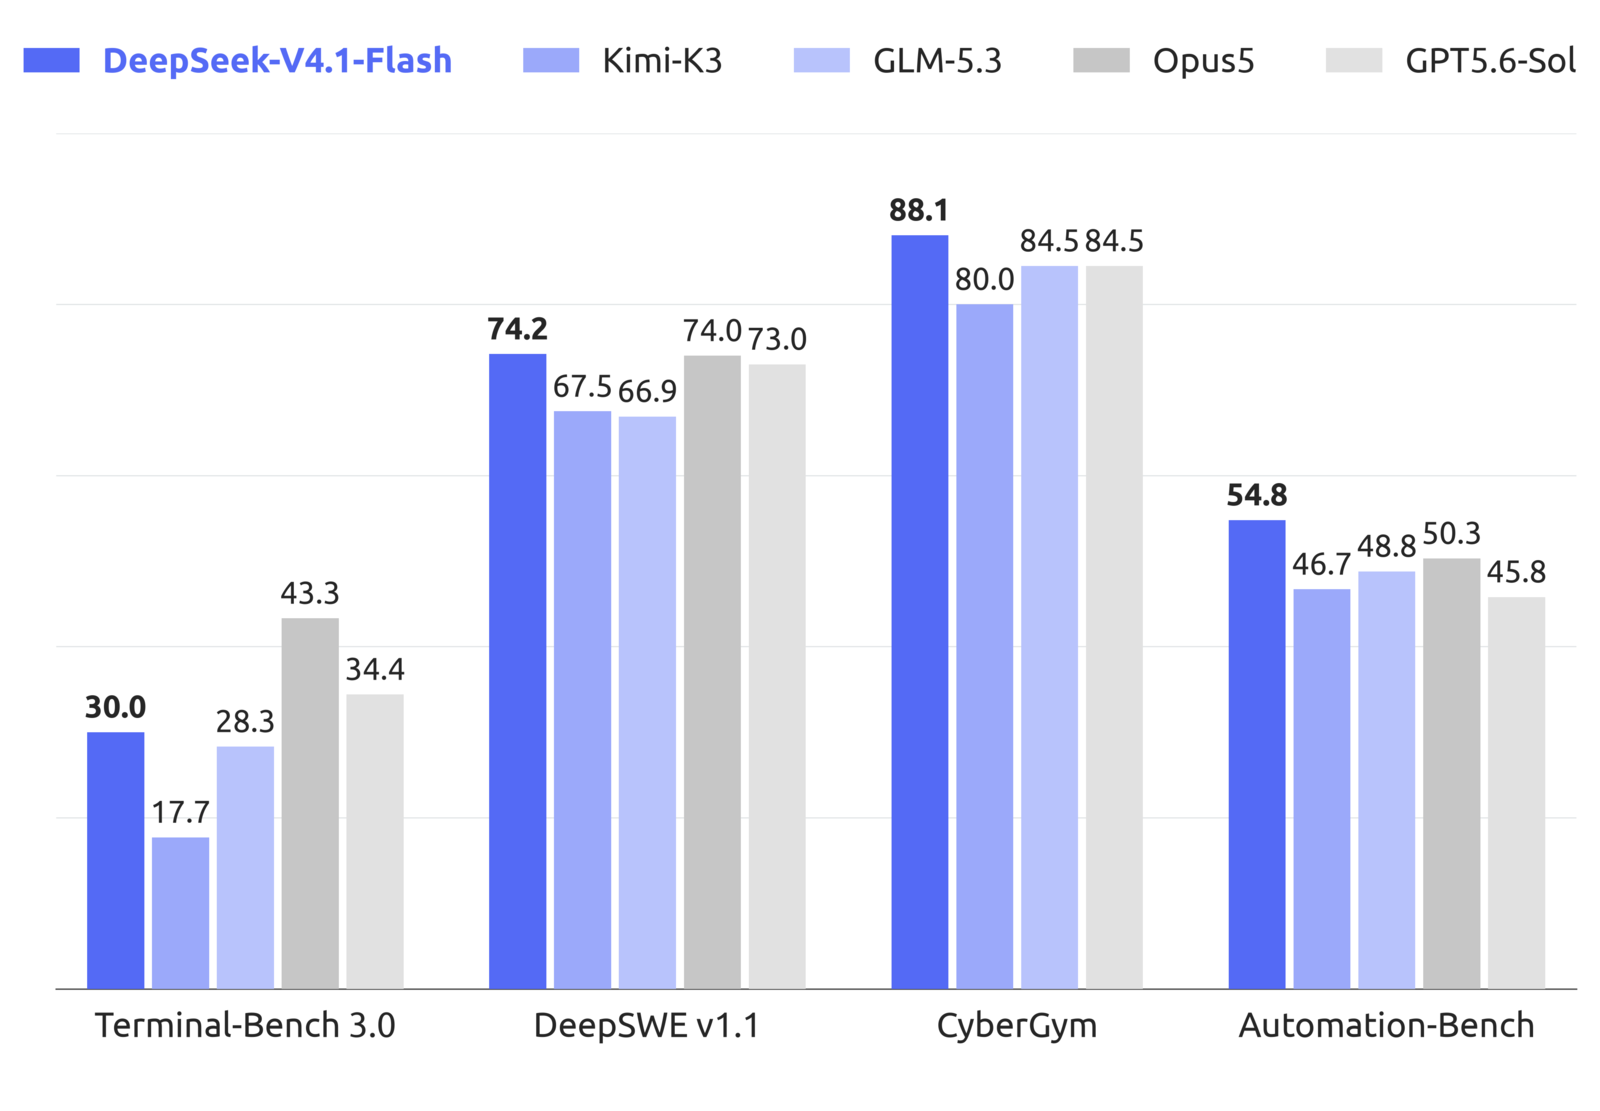
ベースモデルの表は向きが逆です。両者が受けた 16 項目のうち V4 Pro が 12 項目で上、V4.1 Flash が上なのは MMLU-Pro、BigCodeBench、HumanEval、GSM8K の 4 項目。差が大きいのは SimpleQA-Verified(55.2 対 42.3)、LongBench-V2(51.5 対 45.2)、MultiLoKo(50.9 対 45.5)で、事実の想起、長文書の読解、多言語の知識です。Instruct の表でも GPQA Diamond(92.4 対 90.9)と HLE のテキスト部分(42.7 対 39.1)は Pro が上。「全面的に」は agentic の列でのみ成立します(Progressive Robot の読みも同じです)。
モデルカードの Table 4 は同じチェックポイントを 8 つのエージェントハーネスで回し、DeepSWE v1.1 が 65.5 から 74.2 まで動くと示しています。差は 8.7 点で、V4 Pro との差 11.5 点に近い値です。自分のハーネスで測らないと、どちらが上かは分かりません。独立スコアは 9 月 11 日時点で当方は確認できませんでした。
HN には「552B だからもう flash ではない」という投稿と「アクティブは 8B・16B で前より少ない。flash だ」という返信が並びます。総パラメータと計算量のどちらを見るかの違いです。
パラメータ数が 552B・748B・763B に割れる理由と、MIT 重みを動かす 614GB
パラメータ数は出典ごとに違います。どれが間違いというより、数える範囲が違います。
| 数字 | 出典 | 何を数えているか |
|---|---|---|
| 552B | モデルカード | バックボーン(MoE 本体)のみ |
| 196B | モデルカード | Engram 条件付きメモリ(“sparsely accessed via token-based lookup”) |
| 748B | Reddit の safetensors 計算 | 552B + 196B。Deepseek V4.1 Flash is 748B, not 552B の投稿者が 551.566B + 196.929B と算出 |
| 763B | Hugging Face の現在表示 | 上記 + DSpark 投機デコード 14.2B + 視覚エンコーダ 0.5B。HF API の safetensors 合計 763,205,315,794 と一致 |
| 484.6B | 公開当日の HF 表示(第三者の観察) | 4 ビット保存の重みを 1 バイト 1 要素で数えた見え方。9 月 11 日には 763B に更新済み |
| 522B | vLLM レシピのページ頭 | 根拠の記載なし |
動かす側の数字は vLLM Recipes — DeepSeek-V4.1-Flash にあります。チェックポイントはディスク上で約 511GB(476 GiB)。vram_minimum_gb は 614 で、重みの合計に 1.2 の余裕を掛けた値です。GB200 NVL4 の 1 トレイ(768GB、TP4)か 8 枚の H200 ノード(1,128GB)に収まり、1M コンテキストではコンテキストかバッチを絞る必要があると注記があります。配布は Docker イメージ(vLLM 0.30.0 以降)だけです。
Reddit の投稿者の一文が実務的です。「128GB or 256GB of RAM/VRAM is not going to cut it」。ライセンスは MIT で重みは誰でも落とせますが、落とせることと動かせることの距離は、Kimi K3 ライセンスの商用条件は 3 条項で決まるで書いた 8×GB300 と同じ形です。ITmedia の同日の別記事「大金かけて作ったAIを無料公開できるワケ」の「重みは無償、回収は GPU とクラウドの販路」という構図の具体例が、この 614GB です。
14 日までにやること:回帰テストと grep
更新(2026-09-28):切り替えは撤回されたため、期限付きの作業ではなくなりました。依存しているモデル名を固定し、更新履歴を追っておく価値は残ります。
期限は日本時間 9 月 14 日(月)13 時。やることは 2 つ、合わせて半日で終わります。
1 つ目は grep です。deepseek-v4-pro を名指しした呼び出しは 4 日後には別のモデルを指し、deepseek-v4-flash と deepseek-v4-flash-vision-exp はすでに指しています。アプリのコードだけでなく、ゲートウェイの設定、環境変数、CI のフィクスチャも対象です。
# Find every literal reference to the three retiring model names
rg -n 'deepseek-v4-pro|deepseek-v4-flash(-vision-exp)?' \
  --glob '!node_modules' --glob '!.git' .
2 つ目は回帰テストで、14 日より前に走らせます。本番のプロンプトを数十件選び、deepseek-v4-pro と deepseek-flash に同じ入力を送って、応答の model・usage・本文を残します。effort の名前は low / high / max のままですが、Digital Applied が技術レポート §5.3.3 から読み取った範囲では effort 25 から 100 で出力トークンが約 2.5 倍になります。名前ではなく completion_tokens を比べます。
# Same input to both names; keep model, usage and body for the diff
PROMPT='<production prompt>'
for m in deepseek-v4-pro deepseek-flash; do
  jq -n --arg m "$m" --arg p "$PROMPT" \
     '{model:$m, messages:[{role:"user", content:$p}]}' |
  curl -s https://api.deepseek.com/chat/completions \
    -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
    -H "Content-Type: application/json" -d @- \
    | jq '{model, usage, content: .choices[0].message.content}'
done
14 日以降に Pro の名前で呼んで返る model が何かは、公式文書に書かれていません。前後で同じ呼び出しを 1 本残しておけば、答えは自分のログに出ます。
品質が落ちていた場合、選べる手は 3 つです。オプトアウトの記述がない以上、「Pro のまま待つ」は入りません。MIT 重みを自分で動かす——checkpoint 約 511GB、vLLM のレシピは 614GB 以上の GPU メモリを要求します。別の供給元に移す——V4 Pro の重みも MIT なので推論事業者経由という道はありますが、価格と可用性は交渉次第です。受け入れてプロンプトを作り直す——いちばん安く、時間が読めません。どれを選ぶにせよ、判断材料は 14 日より前に取った基線だけです。
請求は下がる方向なので、急いで止める理由はありません。急ぐ理由は、モデルが変わる日付を DeepSeek が決めていて、自分の都合で動かせないことです。モデル名のエイリアスを呼び出し側で持つ設計なら、切替を回帰テストが終わった日に受けられます。残るのは、14 日 13 時までに何を記録しておくかです。