Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5:读懂 Arena 不同榜单的排名变化
基于 Arena 官方发布于 Hugging Face 的固定版本数据,解读三款模型在聊天、代码问答、网页和 Agent 榜中的不同表现;说明评分、区间与配置的比较边界。
同一组模型名称,换一张榜,对应展示标签的顺序就可能改变:聊天总榜不是全能力总榜。 Arena 的 10 月 28 日风格控制文本榜中,Gemini 4 Argon High 的总体点估计高于 Claude Opus 5.5 High 和 GPT-6 Astra Max;到了 Webdev 与 11 月 2 日 Agent 榜,在这三款模型对应的展示标签中,Opus 5.5 Max 的读数最高。这篇解读基于 Arena 官方发布在 Hugging Face 的固定版本数据,只比较各榜实际公布的结果,不是本站实测,也不是三套 API 配置在相同预算下的对决。
数据发布方是 Arena,Hugging Face 是数据集托管平台,不是第二份独立评测。直接读发布方的数据,让我们能核对版本、类别、区间和样本,而不只转述一张排名截图;这份可追溯性有价值,但不会自动消除样本、统计方法和配置差异。下面先读懂每张榜,再看它们分别没有回答什么。
想象一个很平常的周一:团队要让模型先读一段需求,解释现有代码,再做出一页能点的界面,最后自己运行工具修复报错。这三个环节都可以被叫作「写代码」,验收方式却完全不同。第一步看解释是否贴合上下文;第二步要看浏览器里的成品;第三步要算工具调用、卡住与返工。把同一个聊天分数贴到三个验收单上,问题不是榜单不可靠,而是提问错了。
聊天写得顺,不等于软件交付更稳
先看一个相对干净的横截面。Arena 的 Leaderboard Dataset 固定快照提供各类别的 latest 数据;这里固定 revision 38eef63f8920f9e8a77d903928321ecd74ab8126,不是引用会继续变化的实时名次。文本榜的 Arena Score 是回答偏好的相对评分,不是答题正确率;battle 是回答之间的偏好比较计数,不等于独立用户数。下表括号中的上下界是评分估计区间,数据说明未注明这些普通 rating 区间的置信水平。
10 月 28 日公布的 text_style_control overall 类别,三个展示标签对应的点估计依次为 Argon、Opus、Astra:
| 展示标签 | Arena Score | 估计区间 | battles |
|---|---|---|---|
| Gemini 4 Argon High | 1520.25 | 1513.98–1526.53 | 11,889 |
| Claude Opus 5.5 High | 1508.70 | 1502.09–1515.30 | 11,415 |
| GPT-6 Astra Max | 1475.65 | 1469.72–1481.57 | 15,038 |
把类别换成同日的 coding,差距的样子变了:
| 展示标签 | Arena Score | 估计区间 | battles |
|---|---|---|---|
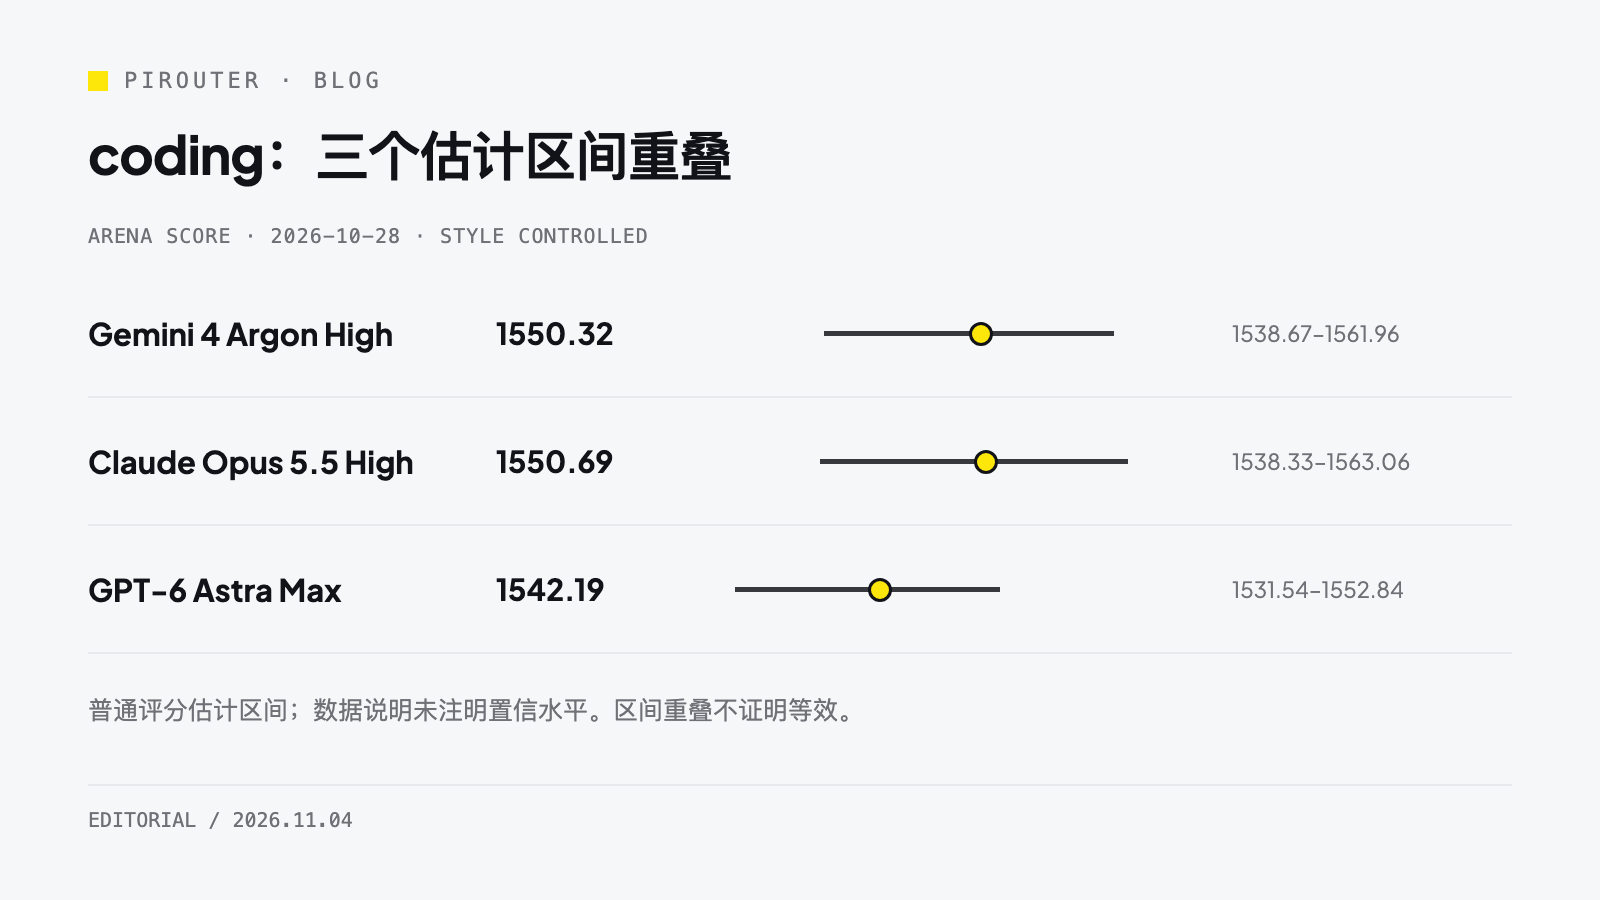
| Gemini 4 Argon High | 1550.32 | 1538.67–1561.96 | 2,813 |
| Claude Opus 5.5 High | 1550.69 | 1538.33–1563.06 | 2,555 |
| GPT-6 Astra Max | 1542.19 | 1531.54–1552.84 | 3,393 |
三段区间互相重叠。在「代码相关对话哪个是明确赢家」这个问题上,不能只凭点估计或榜位作强判;反过来,区间重叠也没有证明三者等效,这里没有针对它们做成对差异检验。若你只需解释代码、讨论实现路径,这份数据不支持仅因个位数的分数差就排除 Astra。
还有一个容易被无意挑选的旋钮:不控制风格的 text 榜,同日 coding 读数为 Opus High 1547.16、Argon High 1538.20、Astra Max 1487.99;风格控制后对应为 1550.69 / 1550.32 / 1542.19。同一批展示标签、同类问题,统计口径就足以改变你对差距的直觉。Arena 的固定版本数据说明记录了风格控制和频率加权的历史变更;它不是「把所有偏差清掉」的保证。不能看见 raw text 的某个差距顺眼就用 raw,看见调整后更顺眼又改用调整后。
网页交付换一张榜,Opus 的标注档位也换了
现在让第二个环节真正交付页面。Arena 的 Webdev 类别固定快照在 10 月 28 日给出另一组结果:
| 展示标签 | Arena Score | 估计区间 | battles |
|---|---|---|---|
| Gemini 4 Argon High | 1679.21 | 1667.78–1690.64 | 3,437 |
| Claude Opus 5.5 Max | 1809.84 | 1797.00–1822.67 | 3,473 |
| GPT-6 Astra Max | 1773.35 | 1763.83–1782.88 | 7,210 |
这比聊天总体榜更贴近「给定要求做网页、由人比较结果」的场景,但仍不是一般软件工程通过率。页面能否构建、可访问性和移动端细节、修改是否碰坏旧功能,都需要你的验收。聊天榜上的先后顺序,不能直接搬来当网页成品的顺序。
这里还有标注档位的变化:文本 coding 的 Opus 标为 High,Webdev 与 Agent 榜标为 Max。跨厂商的 High 与 Max 没有经我们核实为相同推理预算、工具或时间上限,不能拿这些分数给出「同等成本条件下谁更强」的结论。model_name 是榜单标签,不是已完成验证的 API 标识映射;只有确认实际调用配置后,榜单线索才能转成你的试验名单。
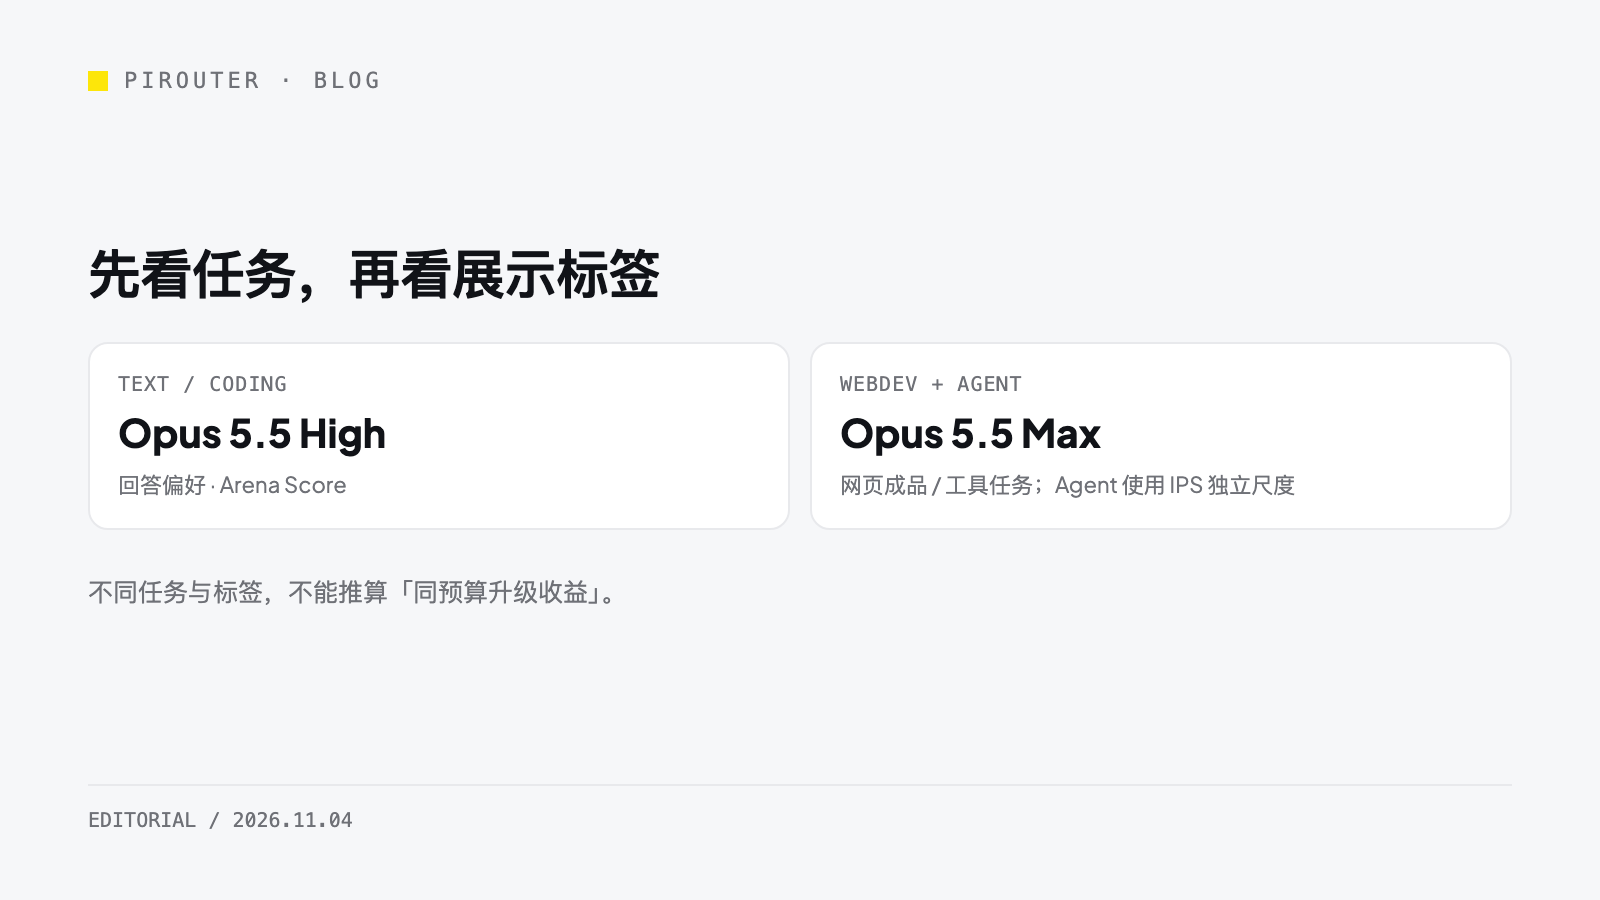
有人会问:为什么不直接找一个「代码能力」百分比?因为问答偏好与做出能运行的东西恰恰是两道题。选测试对象时可以借榜单提出假设;决定默认生产模型时,还要把自己的失败定义写下来。
独立任务基准补上结果,却没有一张通用胜率表
另一份证据来自 Artificial Analysis 的五模型比较原页。原页还列了 Gemini 4 Carbon 与 GPT-6.1 Sol,以下只抽本篇三列,按 Argon High / Astra Max / Opus 5.5 Max, Default Fallback 重排。页面读取于 UTC 11 月 3 日 16:50,即北京时间 11 月 4 日 00:50;这是读取时间,不是分数的测量日期。
| 原页任务项目 | Argon High | Astra Max | Opus 5.5 Max, Default Fallback |
|---|---|---|---|
| FrontierCode 2.0 | 26% | 42% | 46% |
| AutomationBench-AA | 78% | 68% | 70% |
| Terminal-Bench 4.0 | 57% | 59% | 60% |
这张表目前最扎实的用途,是展示任务项目一换,三列的相对顺序也会换。FrontierCode 2.0 行中 Opus、Astra 的点估计较高,AutomationBench-AA 行则是 Argon 较高;Terminal-Bench 4.0 的三个点估计相近。它们不能相加成「三项综合胜率」,也不能把四个百分点直接推广成你的仓库会获得的收益。
我们核到的是项目名称和页面结果,没有完整核实三项任务的输入形态、成功判定协议、逐模型样本分母、置信区间与测量日期。不能仅凭名称带着 Code、Automation 或 Terminal,就认定它对应自己的编码、自动化或终端工作。 这些读数提供待查的线索:先读任务协议,确认与自己的问题相近,再考虑是否值得复试。
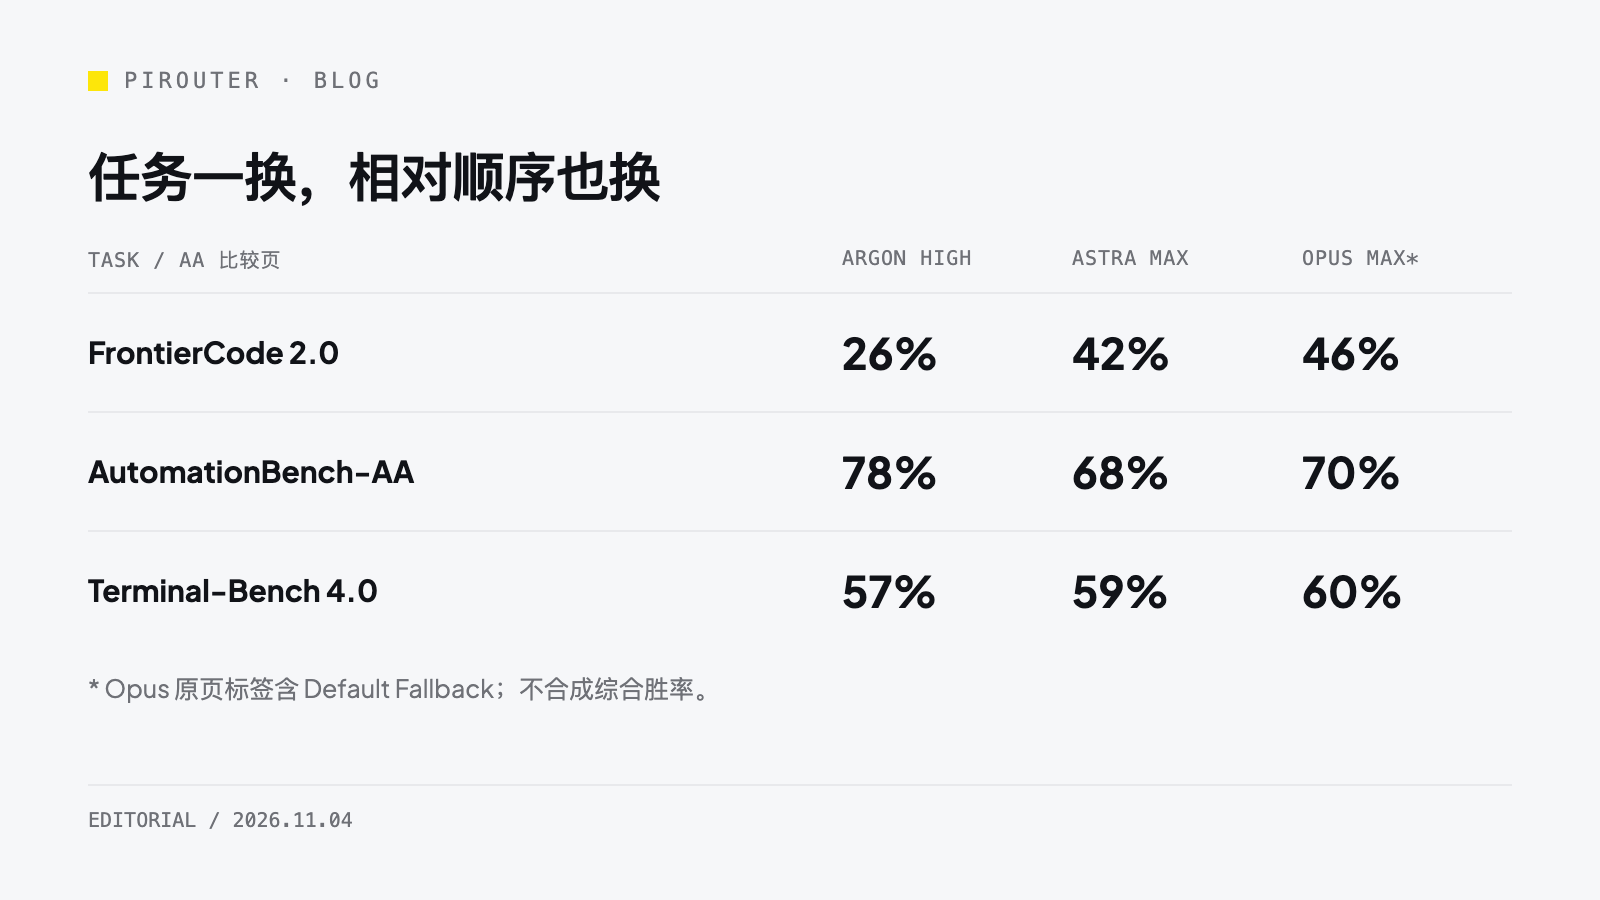
这些是独立评测机构公布的结果,不是厂商发布会自报;「独立」也不代表配置已经对齐。Opus 的完整标签含 Default Fallback,本文保留原文,具体回退行为尚未核实。不能把这列与 Arena 的 Opus High,甚至 Arena 的 Opus Max,当作同一推理路径的测量。
Agent 的 0.200 不是「任务完成率 20%」
第三个环节是 Agent 自己动手。按归档版本的数据字段说明,Agent 聚合读数是 IPS score,与文本和 Webdev 的 Arena Score 分属不同尺度。本文只在同一 Agent 榜口径内参考相对读数,不将它换算成任务完成率。
11 月 2 日固定快照如下;这里的数据说明明确给出 95% 区间:
| 展示标签 | IPS score | 95% 区间 | 信号观测 / 不同 session |
|---|---|---|---|
| Gemini 4 Argon High | 0.10607 | 0.09760–0.11454 | 5,627,073 / 52,038 |
| Claude Opus 5.5 Max | 0.20036 | 0.17924–0.22148 | 2,148,891 / 13,954 |
| GPT-6 Astra Max | 0.13682 | 0.11672–0.15691 | 1,245,184 / 15,315 |
信号观测是计入估计的观测条数,session 是会话计数,二者都不等于独立用户。IPS 不能乘上 100 就写成「Opus 完成 20% 的任务」,更不能与聊天分数画同一根轴。
社区里能看到聚合分数之外的工作流因素。一位 Hacker News 发言者称,用自己的 11 个小型 bug 修复试 Argon,做成 10 个,另一个被较长推理拖进超时;这只是发言者自述及其工具链,不是本文三款模型的同题比较。另一条Vulkan 调试原帖及回复分别描述 Argon 和 Opus 借助渲染图、像素比较与假色定位问题;两人不是同环境同题比较,也不能把描述了调试过程当作已确认修复成功。
它们提示的不是「社区公认谁赢」,而是评测 Agent 时应保留工具轨迹、可观察产物和超时记录,别只打一个最终答案勾。还有人把 Argon 在某个 CLI 中频繁停下确认描述为摩擦;讨论中的当事人随后明确了具体工具环境。这不证明所有人都会遇到同样表现,更不是关闭安全确认的理由。Agent harness,也就是运行 Agent 的工具与权限环境,本身就是任务条件的一部分。
榜单读完之后,哪些判断仍要自己验证
聊天与代码解释,可以参考文本偏好;网页原型应单独看成品;长程工具任务还要记录每一步调用。创作则需要用团队自己的素材盲评,不能从 overall 或 coding 排序直接推出创作优胜者。AA 任务百分比和 Arena Agent 的 IPS 也不是同一测试,顺序不同不意味着其中一份必然错了。
真正开始之前,先核对每家的实际 API ID,即请求中使用的模型标识,逐方记录思考档位和回退设置,不强求 High/Max 同名等价。固定任务、工具权限、最长耗时与可接受成本上限,记录各方 token 用量与费用;无法对齐的条件单列。每题保存完成条件、可复现失败、人工修正轮数及耗时,把成功、拒绝或暂停、超时分开统计,再让第二个人盲评成品。
例如同一个页面任务,不要只问「看起来好不好」:预先规定构建必须通过、三个关键交互都能操作、窄屏不得横向溢出;截图好看却不能提交表单算失败。对代码修复,保留失败测试、模型补丁、复跑结果和人工改动量。成本要把失败与重试算进去,再看每个成功任务花了多少,而非只比较一次调用的账单。
预先设定可接受的任务成功水平、成本、时延及权限暂停门槛;未达标就保留现有默认模型,只继续受控试验。这里不是建议立即迁移,更不是以关闭安全确认换取表面成功率。
这次快照里,vision 没有 Argon 对应行,search 三款都没有对应行:只能说缺少可用于三方对照的数据,不能说它们没有视觉或搜索能力。本文没有本站同题测试,也没有速度、价格或性价比胜负结论。
这份数据支持的判断很具体:文本 overall 中 Argon High 的点估计更高,coding 的三个区间交叠,Webdev 与 Agent 中 Opus Max 的读数更高。它不支持把三个场景揉成一个冠军,更不支持跳过配置核对直接换掉生产模型。榜单的价值是告诉你哪种差异值得看,而不是替你定义什么叫交付成功。