Gemini 4 Carbon 公开开放了,但不是把 Argon 换掉:能力、入口与成本逐项看
Gemini 4 Carbon 从受限预览走向公开付费 API,现已在 pirouter 上线。拆解长程编程、复杂知识工作与科学案例,说明本站 $4/$20 每百万 token 定价、可用入口及何时值得从 Argon 切换。
Gemini 4 Carbon 这次真正改变的是入口,而不是把 Gemini 4 Argon 宣判退场。 Google 在 10 月底先向部分网络安全防御者开放 Carbon;11 月 10 日的新公告把面向公众的版本扩到付费开发者和企业 API。现在 pirouter 的 Carbon 模型详情也已列出 google/gemini-4-carbon,本站售价按每百万未缓存输入 4 美元、输出(含思考)20 美元、缓存读取 0.20 美元计。它针对更长的探索和验证循环;多数日常软件工程与知识工作,Google 仍推荐 Argon。值不值得切换,要看任务完成质量、计费 token、重试和时间,而不是看型号谁排在后面。
Google 11 月 10 日的公开公告发布时间换算为北京时间 11 月 11 日 00:00;下文依据公告和模型卡梳理,不是本站实测。
10 月底仅限部分防御者,这次向谁开放?
先把两个时间点放在一条线上。10 月 28 日的首发公告写的是先面向一部分网络安全防御者,经 Fairwind Program 逐步扩大给受信任伙伴;普通开发者、企业和消费者当时仍要等后续开放。如果拿那篇旧公告判断今天的采购能力,就会错过这次变化。反过来,看到今天的“available”,也不能把全部入口压成一句“人人免费可用”。
新公告对开发者写的是 Gemini API paid tier:可从 AI Studio、Android Studio 构建;对企业给出 Gemini for business 的 API 或模型选择入口。面向个人使用的 Gemini app 和搜索中的 AI Mode,则向 Google AI Ultra 订阅用户推出;Google Antigravity 也列在 Ultra 使用路径中。这几个界面的“能试用”与给自己的服务开通付费 API,不是同一种权限。官方的标准 API 价格页明确把 Carbon 的 Free tier 标为不可用,因此不能用“Ultra 能在 app 里选到”推导“普通免费 API 也可以调用”。
科研人员有单独的申请渠道:Google 称符合条件者可申请六个月 Antigravity 高使用额度,按资格、容量和遴选滚动接入。它不是全体科学家自动领到的赠送额度。网络安全防御者若要用 Carbon for cyber,则需另向 Fairwind Program 申请。Google 的模型卡 Distribution 一节明确写着访问随渠道与订阅层级变化,并将 Fairwind 列为验证过的防御者通道。公开 API 版和该专门渠道不能画等号。
还有一个容易被发布演示带偏的地方:Antigravity 中把单条提示变成多代理协作的 /swarm,Google 称之为预览功能。它展示的是特定产品内的编排体验,不是“所有 Carbon API 请求会自动分叉成一个代理团队”。这一道界线会影响后面我们如何看官方视频,也会影响开发团队对迁移工作量的估计。
本站 API 接入与前述 Google app、AI Studio 的订阅及免费层是不同服务;这里按本站公开价格计费,具体权限以自己的账号为准。公开模型目录已列 google/gemini-4-carbon;该模型的端点详情列出 Chat Completions、Responses、Gemini generateContent 三种调用入口,不列 Messages。使用 Messages 协议的客户端不能仅因型号上架就把同一请求形状照搬过来。
本站公开配置是 1,048,576 token 上下文(约 1M)、最多输出 65,536 token,支持文本、图片、音频、视频及 PDF 等文件输入,文本输出;思考强度 low / medium / high,默认 medium。这是公开目录与端点描述,不是本站对这些工作负载做过效果实测。
上线目录说明服务已有此型号,不等于你的账号和项目可以跳过权限、地区及额度检查。动手迁移前仍要在自己的项目核实际型号权限、配额和限流是否满足试点;这里不凭目录推断统一额度,更不把 Google app 的 Ultra 订阅资格当成本站 API 权限。
Carbon 与 Argon 不是简单的新旧替代
Carbon 的模型卡写明它基于 Argon,支持文本、图像、音频和视频输入,输入与输出合计上下文上限为 100 万 token;输出是文本。上限是规格,不等于把 100 万 token 一次塞进去仍能稳定得到同样好的结果,更不等于长文档任务不用做分段、引用核查或权限设计。模型卡同时列出可能产生幻觉、偶发响应慢或超时等已知限制。
两者的任务分工来自 Google 自己的定义:新公告称 Argon 仍适合大多数软件工程与知识工作,Carbon 针对“考验模型智能边界”的复杂多步骤编程、调试和开放式科学研究,愿意用更多 token 去探索、深入推理和长时间验证。模型卡将其说得更具体:尤其在较高 thinking 档位下,可能消耗更多 thinking token,也可能出现延迟或超时;可配置 thinking 水平,表示质量、等待与成本需要取舍。它没有给出“任何输入都比 Argon 好”的承诺。
假设团队每周要改几十处小 UI 文案、修一处边界明确的校验错误,另有一项跨多个包的迁移:前两类任务若用 Argon 已能稳定通过检查,整体换到 Carbon 可能只是多付费、多等待。第三类任务则可能值得试:要理解多个依赖、制定顺序、修改后运行构建、再处理回归,单次输出漂亮并不代表最终可交付。这个场景是选型示例,不是我们的生产案例;它提示要按任务性质分流,而不是按发布日给所有请求换默认型号。
复杂知识工作:能读图表的长文件,仍需核对引用与交付物
Google 把 Carbon 的知识工作重点放在密集材料上的检索、视觉理解、推理和结构化交付:合同、财务材料、企业运营中的图表、图片、蓝图、表格,最终可能要变成工作簿、演示文稿或报告。公告的知识工作段落称既有测试不充分覆盖代理如何读取带图的密集文件,于是与 Artificial Analysis 合作推出 Multimodal Knowledge Agent(MKA)测试;公告报告 Carbon 在该测试排名第二,平均每任务成本比其比较的第一名模型低六倍以上。
“第二名且成本更低”只对应 MKA 的任务与比较对象,是 Google 在发布稿中引用的结果,不代表企业处理任意文件都能省六倍。公告另称在 Hebbia 的深度金融研究评估中 Carbon 与被测最佳模型持平,并在 Balyasny 涵盖多种金融工作的 23 个模型配置中位列第一;这些合作方评估不能拼成跨所有场景的“金融第一”。如果团队要把一份带附表的材料变成报告,值得试的不是单看输出格式,而是抽查结论能否定位到源文件、数字能否重算、遗漏是否被发现。发布前的排名可以支持安排试点,不能代替本机构的权限审查与最终责任人签字。
长程编程与多代理:演示视频证明了什么、没有证明什么
复杂软件项目里,最昂贵的往往不是写出第一版代码,而是跨文件更改之后让它真的能构建、运行、回归。Google 描述 Carbon 适合多包迁移、跨子系统根因调查和架构重整;在网页开发中,它可以反复构建、检查错误、再看渲染结果。这些描述说明它想解决哪类工作,是否比 Argon 多交付合格结果仍要用同一仓库、工具权限和验收脚本检验。
官方页面的演示比形容词更有助于确定它想解决什么。一个 Antigravity /swarm 演示让多代理 Carbon 团队阅读七份公开的城市规划 PDF,提取其中 206 张工程图视图,经过十轮夜间迭代重建 Google Platform 37 办公楼的交互式三维场景。七份 PDF、图纸视图和迭代轮数出自 Google 的演示说明;它们提示这是长程整理与反复构建的任务,不是证明每轮都无人干预的完整运行记录。交付物由 Three.js——用于在网页里渲染和操作 3D 内容的工具——呈现;这不是交了一张建筑效果图。另一个演示用历史照片与工程图板制作埃菲尔铁塔建造过程的互动展览;织物模拟演示则从论文生成可操作的多尺度可视化。它们展示的共同工作形态是读图、建模、运行代码,再检查能否操作。页面给出的是Google 选择展示的案例,不是所有读者都能取得相同原料、人工干预记录与失败次数的复现实验;不能由画面推出“任意仓库一句话隔夜就能交付”。
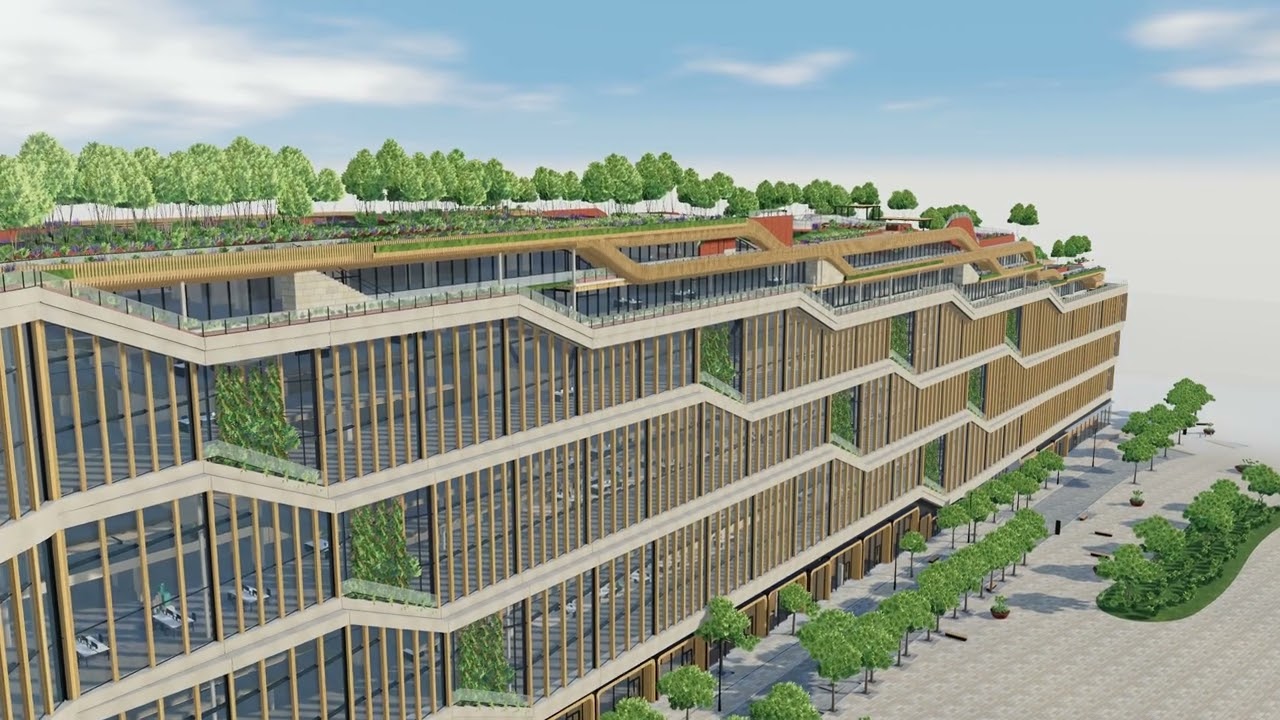
真正值得从演示中带回工程流程的,是验收顺序:先列跨模块约束,再分离任务与权限,最后用构建、测试和渲染检查验证。是否调度多个代理由使用的产品/工作流决定,Carbon 自身的模型调用、Antigravity /swarm 的编排、开发者自建代理系统是三件不同的东西。要试多代理,除模型费用外还需记录并行调用、上下文复制、代理之间返工和最终集成时的人力;否则“一个提示完成”的说法遮住了最重要的成本。
科学任务:从提出假设到可核验结果,中间不止一个模型
Google 的科学案例分属不同层次:合作方 Axiom Bio 称 Carbon 帮助发现了新的药物毒性机制,并计划把科学分析与代理迁向 Carbon 和 Argon;Google 自己的酶检测案例则描述它从实验记录和原始数据提示深孔混合不足等异常,供研究人员回查实验方法。前者是合作方披露的研究进展,后者是异常线索,均不能只凭模型解释就认定机制成立或湿实验重复性已经改善。
蛋白质结构的例子更能说明“读懂研究任务”与“取代科学方法”之间的差别。公告称研究人员在多代理设置中,用 Carbon 从大量未标注序列及结构档案找远缘同源序列;在 CASP17 盲测集的 7 个低同源蛋白家族上,平均检索到的同源序列数量提高 40 倍。这描述的是上游检索材料增加,不是结构预测准确率提高 40 倍,更不是已经广泛验证的药物研发收益。Google 也明确说更大范围的基准仍在进行。若删掉“7 个家族”“检索数量”“评估尚在继续”三个限定,数字就会变成另一个未经报道的结论。
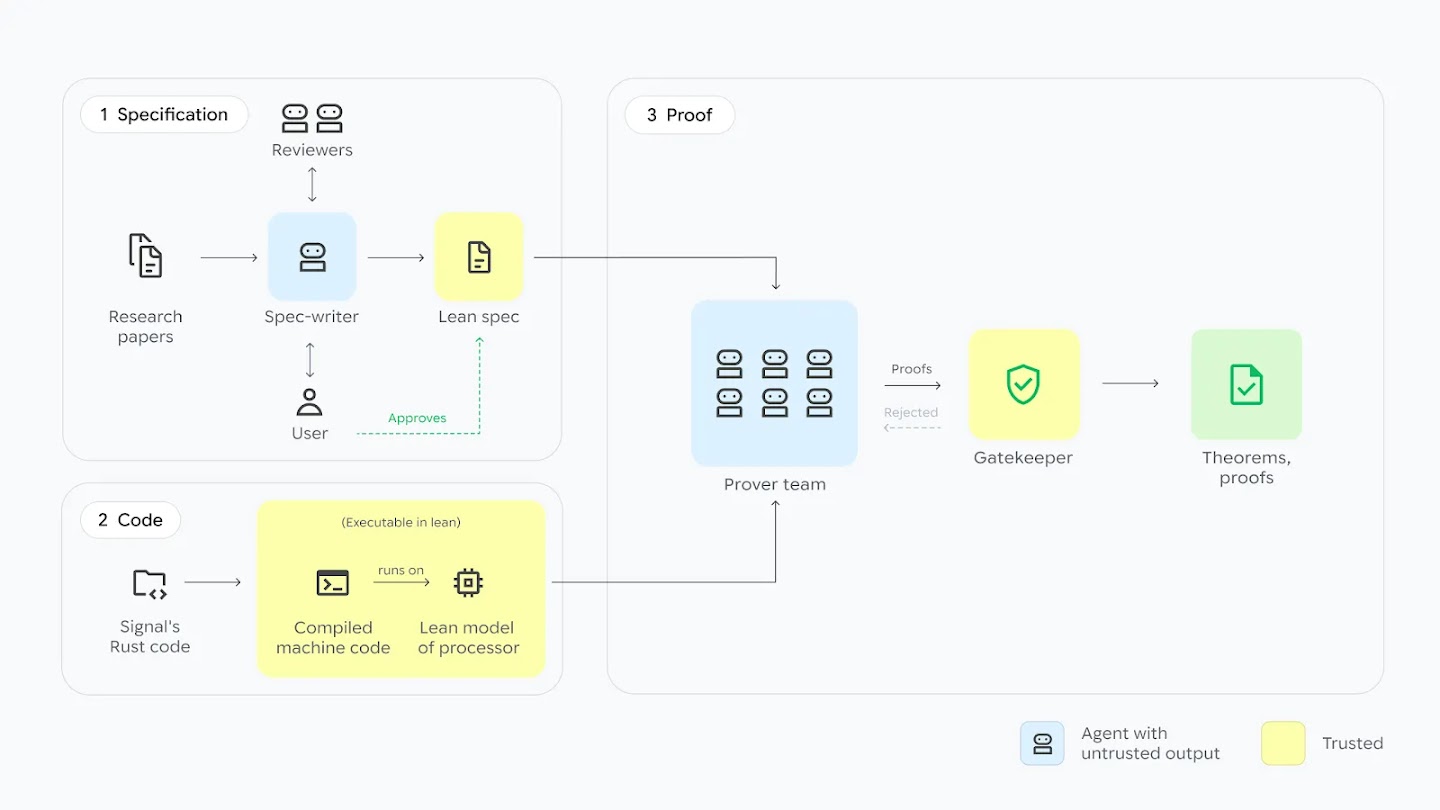
最适合辨认多模型和人类分工的是 AlphaProof Code。Carbon 的发布稿称它参与把安全目标转成定理、在 Lean 中生成大量证明代码,并帮助研究人员验证某加密协议底层代码的关键性质。另读Google DeepMind 对 AlphaProof Code 的原始项目说明后,边界更加清楚:这是由多模型、代理、人工审阅与 Lean 证明检查组成的框架;人定义并审看要验证的性质,机器检查证明是否符合形式系统。它报道的结果,是针对研究者指定的安全性质,对相关编译后核心代码作机器核验;不是“Carbon 单独证明整个应用程序绝无漏洞”。一项能被形式化核验的工程进展确实重要,但将它嫁接成公开 API 模型可以自主审计任意真实系统,会误导使用者。
榜单与“每任务成本”为什么不能替你做采购决定
Google 还报告 Carbon 在 CursorBench 4.0、WANDR、AutomationBench 等测试领先,并据此提出较低的每任务成本主张。上述三项与前文 MKA 的任务定义和比较对象不同,不能拼成“所有工作都最便宜”。“每任务”要能指导采购,至少得定义成功标准、模型配置、工具费用与失败重试怎样计入;团队自己的 Argon 基线和 Carbon 小批量结果,比跨测试汇总的一个胜出百分比有用。
型号版本也是证据边界。Google 公告的直连定价脚注特意限定为 intended for public access 的 Carbon;本站实际售价另以 pirouter 公开目录为准。模型卡又说明专门网络安全防御能力通过 Fairwind 给已验证的防御者;不能拿 Fairwind 渠道的安全测试成果直接当成本站普通型号用户一定能复现的功能。在安全领域尤其应只按官方所列权限与具体可用版本评估,不能从演示或跑分推断有未授权的访问办法。对于一般团队,真正需要讨论的多是代码质量、复杂资料理解和可核验的科学分析,而不是跨渠道拼一张“全能力”成绩单。
pirouter 上的 Carbon 如何计费?单价不是任务账单
本站公开型号详情与模型目录列出的,是 pirouter 对 google/gemini-4-carbon 的售价,每项均按百万计费 token 计算:
| pirouter 计费项目 | 每 100 万 token 售价 |
|---|---|
| 未缓存输入 | 4 美元 |
| 输出(含思考) | 20 美元 |
| 已命中缓存的输入读取 | 0.20 美元 |
缓存读价只对实际计为缓存读取的 token 生效,不能假设每个请求都会命中缓存;思考 token 归输出计费。上游报告的输入总 token 可能已包含缓存份额,核算时应按平台账单分类,将未缓存输入与缓存读取分别乘对应费率,不能把原始输入总量再与缓存读取量相加。Google 直连 API 的活动价属于另一条商业渠道,不传递到本站售价,不能把原厂活动或 Ultra 订阅权益当作 pirouter 的折扣或免费额度。上表也没有承诺某个特定项目的速率和配额;实际使用前以本账号可见的详情与账单为准。
比编一组“典型请求”数字更有用的是取你团队同一任务在 Argon 上的真实基线:过去几次从接到需求到验收通过,共发了多少次请求,未缓存输入、缓存读取与输出的计费用量各多少,失败后重试了几轮,工具、等待和人工修正占多少。再让 Carbon 在相同输入、权限和验收标准下完成同一批任务,对照每个合格结果的全链路账单,而非只比较单轮价格。长程代理会反复带入上下文,较高 thinking 水平可能增加计费输出,多个代理可能并行消耗 token;这些都得逐轮记录,不能凭模型名称估计“节省比例”。如果 Argon 的本项目账单还没拿到,先把基线列为缺项,不以厂商 benchmark 的成本主张代替。
价格之外还有迁移成本:更长的等待是否超出产品超时预算,现有提示词与工具 schema 是否仍稳定,审阅者能否在相同规则下接受结果,失败后有没有回退到 Argon 的路径。模型卡 Known Limitations 一节明说可能有慢响应、超时和幻觉;这比在演示里追求“看起来更聪明”更接近生产环境的约束。本站明码单价只解决每种 token 怎么收费,不能保证任务账单的大小:调用数量、计费 token、缓存实际命中和验收成功率都会改变最终结果。
哪些任务值得从 Argon 切换?先做一轮最小验收
对现在要决策的团队,可以把候选任务分为三袋,而不是把“更强模型”设为全局开关。第一袋是常规且已有稳定通过率的工作,例如格式固定的整理、明确输入输出的轻量编码,让 Argon 留在默认路径;这与 Google 对其适合多数工作场景的定位一致。第二袋是高价值但易失败的复杂任务,如跨包迁移、带图表的多文件分析、需要反复验证的调试:Carbon 值得拿同一组真实任务跑小样本对照。第三袋是受限或高风险任务,如需要特定渠道的安全研究、受机构审查的科学结论,先核权限、审核与责任机制,再谈模型。
这轮对照应先写清“完成”的定义。代码任务用同一构建、回归测试与界面检查;资料任务用同一引用准确性和数字复核标准;研究任务把检索发现、实验验证及最终主张拆开验收。分别从现有 Argon 账单与 Carbon 新试点保存实际 model ID、thinking 档位、入口、输入/输出计费 token、调用和重试次数、端到端耗时、人工修正量,最后算每个合格结果的总成本。跑不了某个渠道,就记为“未测试”,不拿展示视频或另一版本的跑分填补。
Carbon 在 pirouter 上线,让接入决策从“原厂什么时候开放”推进到“我现在能否在所用入口完成任务、哪些难题值这个价”。结论不是立刻迁走全部流量,而是先挑失败代价最高、验收最明确的一类难题,在相同标准下看它是否比 Argon 带来足够的质量收益。拿到本站实际用量和合格结果,再决定下一步。