
Grok 4.7 の料金はプロンプト 200k でリクエスト全体が 2 倍:500k コンテキストの 199k と 201k の請求を GPT-6 Sol・Claude Opus 5.5 と比較
Grok 4.7 の API 料金は 100 万トークンあたり入力 $2・キャッシュ読み取り $0.50・出力 $6 で 4.6 と同額。プロンプトが 200k トークンに達すると、超えた分ではなく全トークンが $4・$1・$12 になり、出力 8k なら 199k で $0.446、201k で $0.900 です。Zenn の「Fast なら3倍」は Cursor で 500k と Fast を重ねた数字で、Fast は公開 API にありません。GPT-6 Sol(272k 規則、既定でキャッシュ書き込み)と Claude Opus 5.5(1M まで割増なし)と並べ、長さとキャッシュで振り分ける境界を計算しました。
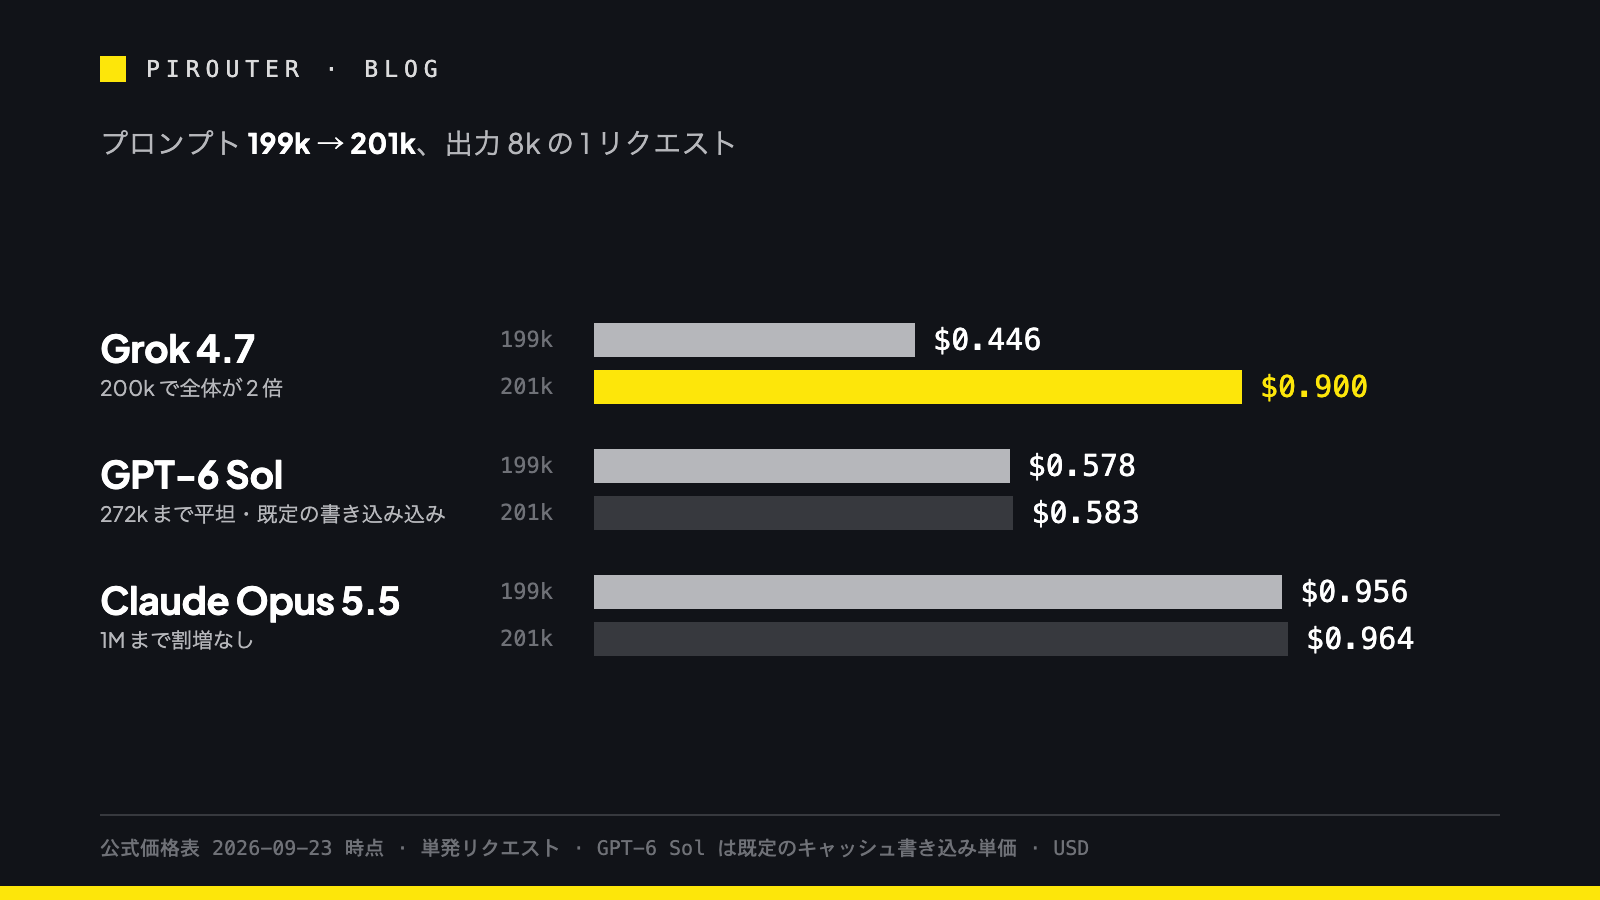
結論から書くと、Grok 4.7 の API 料金は 100 万トークンあたり入力 $2、キャッシュ読み取り(キャッシュ済みの入力を再利用する分)$0.50、出力 $6 で、Grok 4.6 と同じです。プロンプトが 200k トークンに達したリクエストは、超えた分だけでなくリクエストの全トークンが $4・$1・$12 になります。出力 8k で計算すると、プロンプト 199k なら $0.446、201k なら $0.900。2k トークン足しただけで請求は 2 倍です。
判定はプロンプト(システムプロンプトと履歴を含む入力)のトークン数で、出力は数えません。キャッシュ読み取りの分も含まれ、xAI は「Long context pricing applies when total prompt tokens (including cached tokens) exceed the model’s long context threshold」と書いています(Prompt Caching: Usage & Pricing)。価格は 2026-09-23 時点です(Pricing、Models: Grok 4.7)。
Requests whose prompt reaches 200k tokens are billed at the higher rate for all tokens in the request.
コンテキスト上限 500,000 トークンのうち、200k から先の 6 割(300k)では、リクエスト全体がロングコンテキスト(長文)料金になります。割引付きのバッチ API も grok-4.7 では使えません。
Zenn の「Fast なら3倍」は 500k と Fast を重ねた数字
9 月 22 日の Zenn 記事は、Cursor の料金表を 4 行に整理しています(Grok 4.7 500k が追加。料金は通常の2倍、Fast なら3倍、Shinoda Yukihiro さん)。著者は Cursor だけで使っており、API 側は文書を読んだ範囲だと断っています。下の行名は Cursor 料金表の表記です(Cursor Models & Pricing)。
| Cursor の区分 | 入力 | キャッシュ読み取り | 出力 | 通常比 |
|---|---|---|---|---|
| Grok 4.7 | $2 | $0.50 | $6 | 1 倍 |
| Grok 4.7 (Fast) | $4 | $1 | $12 | 2 倍 |
| Grok 4.7 500k | $4 | $1 | $12 | 2 倍 |
| Grok 4.7 500k (Fast) | $6 | $1.50 | $18 | 3 倍 |
Fast は同じモデルを速い基盤で動かす版(速度も価格も 2 倍)です。著者の「Fast+500k だと3倍」のとおり、3 倍は長文との重ね掛けです。
API 側から補うと 3 点です。
- Fast は公開 API にない。 xAI の料金ページは「available only through Cursor and Grok Build; it is not available on the public xAI API」と書いています。Grok Build は xAI のコーディングツールです。
- API は自動で切り替わる。 API に 500k という別モデルはなく、
grok-4.7でプロンプトが 200k に届いたリクエストだけが長文料金になります。Zenn の比較表も API 側を「送ったリクエストが 20 万トークン以上のとき。自動で切り替わる」と正確に書いています。 - Cursor の境界は 2 通りに読める。 ヘルプは「long-context rates above 256k input tokens」、料金表は「Grok 4.7 500k」を別の行として載せています(Cursor Help: Grok 4.7)。256k 超で切り替わるのか、500k を選んだ時点で $4 なのかは決まりません。
xAI の表記は、料金表とモデルページが「≥ 200k」「reaches」で揃っています。「exceed」と書くのは Fast の節とキャッシュの解説ページです。
199k と 201k の請求:跳ぶのは Grok 4.7 だけ
式は「(プロンプト − キャッシュ分) × 入力単価 + キャッシュ分 × キャッシュ読み取り単価 + 出力 × 出力単価」です。出力 8k で、3 社の公式単価から当方が計算しました。料金だけの比較で、3 モデルの品質は同じではありません。
| プロンプト | Grok 4.7 | GPT-6 Sol(既定) | GPT-6 Sol(キャッシュ無効) | Claude Opus 5.5 |
|---|---|---|---|---|
| 199k | $0.446 | $0.578 | $0.478 | $0.956 |
| 201k | $0.900 | $0.583 | $0.482 | $0.964 |
| 271k | $1.180 | $0.758 | $0.622 | $1.244 |
| 273k | $1.188 | $1.485 | $1.212 | $1.252 |
| 400k | $1.696 | $2.120 | $1.720 | $1.760 |
GPT-6 Sol は入力 $2・キャッシュ読み取り $0.20・出力 $10 で、プロンプトが 272k を超えるとリクエスト全体の入力とキャッシュが 2 倍、出力が 1.5 倍です(GPT-6 Sol、OpenAI Pricing)。同じ規則が GPT-6 Luna にもあります。OpenAI はキャッシュが既定で有効で、書き込みは通常入力の 1.25 倍です(Prompt caching)。単発ではプロンプト全体が書き込み単価(272k 以下 $2.50、超えると $5.00)になり、「既定」列はこの値です。単発なら explicit モード(prompt_cache_options.mode)でブレークポイントを置かずにキャッシュを切ると安く、「キャッシュ無効」列になります。Claude Opus 5.5 は $4 / $20 で割増がなく、料金ページは「A 900k-token request is billed at the same per-token rate as a 9k-token request」と書いています(Pricing: Long context pricing)。
単発のリクエストなら、Grok 4.7 が割高になるのは GPT-6 Sol に対して 200k〜272k の帯だけで、Sol は既定でも約 35% 安く、キャッシュを切れば約半額です。272k を超えると Grok 4.7 が 3 社でいちばん安くなり、差は出力が多いほど開きます。推論トークンも出力単価で課金されるので(xAI の Usage & Pricing)、400k・出力 64k なら Grok 4.7 $2.368、Opus 5.5 $2.880、Sol $2.960(キャッシュ無効で $2.560)です。
トークナイザは各社で違い、同じ文書でもトークン数は一致しません(Claude Opus 5.5 は 1M トークンを約 55.5 万語としています)。
キャッシュ読み取りが多い長文では、Grok 4.7 がいちばん高い
同じ履歴を送り続けるエージェントでは、プロンプトの大半がキャッシュ読み取りです。例は 300k のうち 280k がキャッシュ、新規 20k、出力 8k。Sol の 272k 判定にキャッシュ分が入るかは OpenAI に記載がなく、入る前提です(推定)。
| Grok 4.7 | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| キャッシュ読み取り単価 | $1.00 | $0.40 | $0.20 |
| 請求(書き込み費なし) | $0.456 | $0.312 | $0.296 |
| 請求(新規 20k を書き込み計上) | $0.456 | $0.332 | $0.316 |
書き込み費(新規分をキャッシュに保存する単価)は xAI にはなく、Sol(長文)と Opus 5.5(5 分キャッシュ)は $5 です。入れても順位は変わらず、除外は Grok 4.7 に不利な単純化ではありません。この長さでは入力単価は 3 社とも $4 で、差はキャッシュ読み取り単価(Opus 5.5 と 5 倍差)です。
エージェントの履歴は伸び続けるので、200k を越えたターン以降は、ステップ数の二乗で伸びる請求(常時稼働エージェントの請求書)の傾きがずっと 2 倍です。
Grok 4.7 に送るのはプロンプト 200k 未満のとき:長さとキャッシュで振り分ける
| プロンプトの長さと形 | 向いている先 |
|---|---|
| 200k 未満、キャッシュ少なめ | Grok 4.7。3 社で最安 |
| 200k 未満、キャッシュ主体 | GPT-6 Sol がわずかに安い(180k・うち 160k キャッシュで $0.162 対 $0.168) |
| 200k〜272k | GPT-6 Sol。既定で約 35% 安く、キャッシュ無効なら約半額 |
| 272k〜500k、キャッシュ少なめ | Grok 4.7。出力が多いほど差が開く |
| 長文でキャッシュ主体 | Opus 5.5 か GPT-6 Sol |
| 500k 超 | Grok 4.7 は上限を超える |
地域を指定すると 3 社とも 1.1 倍です(xAI の US リージョンエンドポイント、OpenAI の Regional processing、Anthropic の inference_geo: "us")。
送る前に数えるなら、xAI の POST /v1/tokenize-text がモデル別のトークン列を返します(Inference API: Account)。手軽には、直前ターンの usage フィールド(API レスポンスに入る消費トークン数)の prompt_tokens に今回の追加分を足して見積もれます。190k を超えそうなら、履歴を要約して削るか別のモデルに回します。10k の余裕は、見積もり誤差と、k が 1,000 か 1,024 か未記載なことへの備えです。乗り換えるとキャッシュが切れるので、振り分けはセッション開始時に決めます。199k と 201k の差 $0.454 は 1 リクエストなら小銭ですが、1 日 1,000 リクエストなら $454 です。